IT & Engineering
Blinde Flecken durch fehlende Daten beim Machine Learning vermeiden

Sie haben ein Projekt und möchten darauf Machine Learning anwenden. Sie beginnen einfach: ein Merkmal hinzufügen, Daten sammeln, ein Modell erstellen. Sie fügen ein weiteres äußerst nützliches Merkmal hinzu, das jedoch nur in der Hälfte Ihrer Datenpunkte vorhanden ist. Sie möchten klug vorgehen und alle verfügbaren Daten nutzen (einschließlich derer mit fehlenden Werten), aber wie stellen Sie das an?
Wenn ich in der Entwicklung auf ein Problem stoße, versuche ich, eine funktionierende Lösung zu googeln. Sie muss nicht zu 100 % mathematisch exakt sein, sollte aber sinnvoll sein. Meine Suche führte mich zu Missing Value in Data Analysis auf Stack Overflow.
Die Lösungen reichen von einfachen Ansätzen, wie dem Füllen von Lücken mit dem Durchschnitt oder den häufigsten Werten, bis hin zur Vorab-Vorhersage der fehlenden Werte. In meinem Fall führte ich ein separates binäres Merkmal ein, das angibt, ob der Wert fehlt.
Wann immer ich an einer Lösung zweifelte, wandte ich mich der Mathematik zu. Die Mathematik ist sehr präzise darin, wann etwas funktioniert oder nicht, und was die Bedingungen und Kompromisse sind. Es gibt auch viel Literatur über Datenimputation– Fachleute schreiben ihre Doktorarbeiten über dieses Problem.
Doch dann stieß ich (eher zufällig) auf einen anderen Ansatz. Anstatt zu versuchen, die Daten zu imputieren, nutzen Sie Algorithmen, die keine Datenimputation erfordern. Diese funktionieren sofort – ob mit fehlenden Werten oder ohne. Klingt wie ein Märchen, oder?
Während meiner Recherche erwähnte niemand so etwas. Ich sprach mit Promovierten und Fachleuten aus diesem Bereich und hörte immer nur von Datenimputation.
Dann stieß ich auf einen Coursera Kurs, der sehr detailliert auf Entscheidungsbaum-Algorithmen einging. Entscheidungsbäume funktionieren so, dass an der Wurzel begonnen wird und man mit einer bestimmten Wahrscheinlichkeit nach links oder rechts geht. Hier ist ein Entscheidungsbaum für das Überleben von Fahrgästen auf der Titanic:
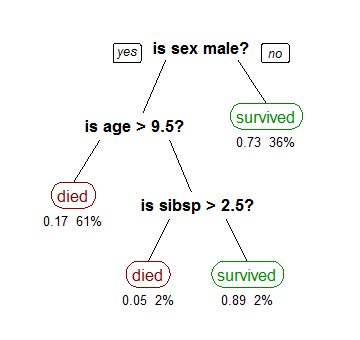
Wie Entscheidungsbaum-Algorithmen wie C4.5, C5.0 und CART fehlende Werte berücksichtigen, sieht so aus:
Stellen Sie sich vor, ein Merkmalswert ist unbekannt. Das bedeutet, Sie können die Bedingung nicht überprüfen und wissen nicht, welchem Zweig Sie folgen sollen. Ein gängiger Ansatz ist die Verwendung des häufigsten Wertes. Dies entspricht im Grunde der Wahl des wahrscheinlichsten Zweigs.
Baumalgorithmen betrachten beide Zweige mit Gewichtungen, die der Wahrscheinlichkeit der Zweige entsprechen.
Lernen an einem Beispiel
Ziehen wir ein weiteres Beispiel heran. Hier ist ein Wahrscheinlichkeitsbaum aus einem einfachen GMAT-Test der eine Stichprobengröße von 100 Studierenden in einer Hochschulklasse annimmt:
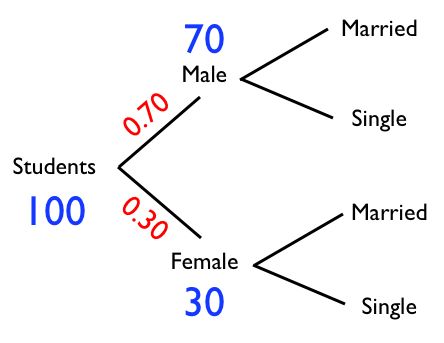
Für männliche Personen beträgt die Wahrscheinlichkeit, ledig zu sein,
50 / 70 = 71 %
Für weibliche Personen beträgt die Wahrscheinlichkeit, ledig zu sein,
20 / 30 = 67 %
Ist das Geschlecht unbekannt, beträgt die Wahrscheinlichkeit, ledig zu sein,
(0,7 71 %) + (0,3 67 %) = 70 %
0,7, da 70 von 100 Studierenden männlich sind. 0,3, da 30 von 100 Studierenden weiblich sind.
Indem die Gesamtwahrscheinlichkeit in Zweigwahrscheinlichkeiten mit Gewichtungen aufgeteilt wird, werden alle Möglichkeiten berücksichtigt. Im Allgemeinen halte ich dies für eine viel bessere Methode, um fehlende Daten zu bewältigen und dem Modell beizubringen, zukünftige Werte zu generalisieren.
Leider unterstützen Bibliotheken, die diese Algorithmen implementieren, selten fehlende Werte. Zum Beispiel scikit-learn -Bibliothek – die De-facto-Machine-Learning-Bibliothek für Python – erfordert, dass alle Werte numerisch sind.
Dennoch gibt es gute Bibliotheken wie Orange die fehlende Werte unterstützen. Und wie sich zeigt, lässt sich diese Einschränkung überwinden.
Die Leistungsfähigkeit der Datenimputation
Anfangs machte mich dieser mangelnde Support für fehlende Werte sowohl wütend als auch amüsiert. Ernsthaft, warum lässt sich ausgerechnet der Algorithmus, dessen Vorteil der integrierte Support für fehlende Werte ist, nicht ohne Datenimputation nutzen? Mal ehrlich.
import randomrndef impute_gender():rnreturn random.choice(["Male"] * 70 + ["Female"] * 30)
Das Schöne an der Datenimputation ist, dass sie sich auf jeden Machine-Learning-Algorithmus anwenden lässt, nicht nur auf Entscheidungsbäume.
Das hat mich völlig verblüfft. Aus einem Hindernis wurde eine Lösung, alles dank derselben einfachen Idee.
Erkenntnisse
Unabhängig davon, in welchem Bereich Sie arbeiten oder wie gut Sie beim Sammeln von Daten sind, es werden immer fehlende Werte auftreten. Vielleicht arbeiten Sie an einer Credit-Scoring-Anwendung. Oder Sie versuchen vorherzusagen, wann E-Mail-Empfänger ihre Nachrichten am wahrscheinlichsten öffnen, um den Versand entsprechend zu planen. Reale Aufgaben weisen oft Lücken auf.
Es gibt viele verschiedene Herangehensweisen an das Problem fehlender Werte, und je nach Anwendungsfall fallen die Antworten unterschiedlich aus. Doch im Kern einer komplexen Lösung liegt oft eine einfache Idee.
Nützliche Links
- Wiki-Artikel zu Datenimputation
- Einige gängige Methoden, um fehlende Werte zu imputieren
- Quora-Artikel darüber, wie Entscheidungsbäume fehlende Werte behandeln
- Orange – häufig genutzte Machine-Learning-Bibliothek in Python, die fehlende Werte unterstützt
- Das Modell testen um realen Aufgaben standzuhalten
Viel Erfolg beim Machine Learning. Wie gehen Sie mit fehlenden Werten um? Teilen Sie es unten in den Kommentaren mit …