IT & Engineering
Éviter les angles morts des données manquantes avec le machine learning

Vous avez un projet et vous souhaitez y appliquer le machine learning. Vous commencez simplement : ajouter une fonctionnalité, collecter des données, créer un modèle. Vous ajoutez une autre caractéristique très utile, mais elle n’est représentée que dans la moitié de vos points de données. Vous voulez faire preuve d’ingéniosité et utiliser toutes les données dont vous disposez (y compris celles avec des valeurs manquantes), mais comment faire ?
En tant que spécialiste du développement, lorsque je rencontre un problème, j’essaie de trouver sur Google une solution qui fonctionne. Elle n’a pas besoin d’être précise à 100 % d’un point de vue mathématique, mais elle doit avoir du sens. Mes recherches m’ont mené à Valeurs manquantes dans l’analyse de données sur Stack Overflow.
Les solutions vont d’une approche simple, comme combler les lacunes avec des valeurs moyennes ou les plus courantes, jusqu’à la prédiction préalable des valeurs manquantes. Dans mon cas, j’ai introduit une caractéristique binaire distincte indiquant si la valeur est manquante.
Chaque fois que je doutais d’une solution, je me tournais vers les mathématiques. Les mathématiques sont très précises sur ce qui fonctionne ou non, et sur les conditions et les compromis à accepter. Il existe également une abondante littérature sur l’imputation de données– des spécialistes obtiennent même leur doctorat en travaillant sur ce problème !
Mais j’ai ensuite découvert une approche différente (un peu par hasard). Au lieu d’essayer d’imputer les données, vous pouvez utiliser des algorithmes qui ne le nécessitent pas. Ils fonctionnent tels quels, avec ou sans valeurs manquantes. On se croirait dans un conte de fées, n’est-ce pas ?
Pendant mes recherches, personne ne m’avait parlé d’une telle méthode. J’ai discuté avec des titulaires de doctorat et des spécialistes du domaine, et l’on ne me parlait que d’imputation de données.
Puis je suis tombé sur un Coursera cours qui détaillait de manière approfondie les algorithmes d’arbre de décision. Le principe des arbres de décision est de partir de la racine et d’aller à gauche ou à droite avec une certaine probabilité. Voici un arbre de décision pour la survie des passagers du Titanic :
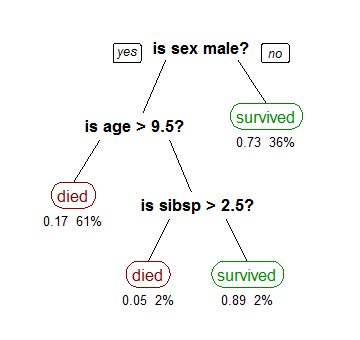
La manière dont les algorithmes d’arbre de décision comme C4.5, C5.0 et CART prennent en compte les valeurs manquantes se présente ainsi :
Imaginez que la valeur d’une caractéristique soit inconnue, ce qui signifie que vous ne pouvez pas vérifier la condition et n’avez aucun moyen de savoir quelle branche suivre. L’une des approches courantes consiste à utiliser la valeur la plus fréquente. Cela revient essentiellement à choisir la branche la plus probable.
Les algorithmes d’arbre examinent plutôt les deux branches en leur attribuant des poids égaux à leur probabilité.
Apprendre par l’exemple
Prenons un autre exemple. Voici un arbre de probabilité tiré d’un simple test GMAT qui s’appuie sur un échantillon de 100 élèves dans une classe universitaire :
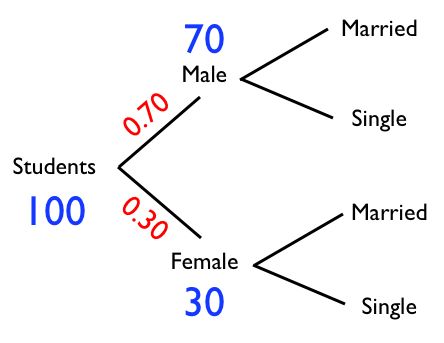
Pour un homme, la probabilité d’être célibataire est de
50 / 70 = 71 %
Pour une femme, la probabilité d’être célibataire est de
20 / 30 = 67 %
Si le genre est inconnu, la probabilité d’être célibataire est de
(0,7 71 %) + (0,3 67 %) = 70 %
0,7, car 70 élèves sur 100 sont des hommes. 0,3, car 30 élèves sur 100 sont des femmes.
En décomposant la probabilité globale en probabilités de branches avec leurs pondérations respectives, nous prenons en compte toutes les possibilités. De manière générale, je pense que c’est une méthode bien plus efficace pour pallier l’absence de données et apprendre à notre modèle à généraliser les valeurs futures.
Malheureusement, les bibliothèques qui implémentent ces algorithmes prennent rarement en charge les valeurs manquantes. Par exemple, scikit-learn – la bibliothèque de machine learning de référence pour Python – exige que toutes les valeurs soient numériques.
Mais il existe toujours de bonnes bibliothèques, telles que Orange qui prennent bien en charge les valeurs manquantes. Et il s’avère qu’il est possible de contourner cette limite.
La puissance de l’imputation de données
Au début, ce manque de prise en charge des valeurs manquantes m’a à la fois frustré et amusé. Sérieusement, pourquoi l’algorithme même, dont l’avantage réside dans sa prise en charge native des valeurs manquantes, ne peut-il pas être utilisé sans imputer les données ?! C’est un comble !
import randomrndef impute_gender():rnreturn random.choice(["Male"] * 70 + ["Female"] * 30)
Et la beauté de l’imputation de données réside dans le fait qu’elle peut s’appliquer à n’importe quel algorithme de machine learning, et non pas seulement aux arbres de décision.
Cela m’a époustouflé ! Un obstacle s’est transformé en solution, tout cela grâce à une idée toute simple !
Leçons retenues
Quel que soit votre domaine d’activité ou votre talent pour collecter des données, vous rencontrerez toujours des valeurs manquantes. Vous travaillez peut-être sur une application de notation de crédit. Ou bien vous essayez de prédire à quel moment vos destinataires ont le plus de chances d’ouvrir vos emails, afin de planifier vos envois en conséquence. Les tâches réelles comportent généralement des lacunes.
Il existe de nombreuses façons d’aborder un problème tel que les valeurs manquantes et, selon les cas, les réponses peuvent différer. Cependant, au cœur d’une solution complexe se cache souvent une idée simple.
Liens utiles
- Article Wiki sur l’imputation de données
- Quelques méthodes courantes pour imputer les valeurs manquantes
- Article Quora sur la façon dont les arbres de décision gèrent les valeurs manquantes
- Orange – bibliothèque de machine learning couramment utilisée en Python qui prend en charge les valeurs manquantes
- Tester votre modèle pour résister aux tâches du monde réel
Bon machine learning ! Comment gérez-vous les valeurs manquantes ? Dites-le-moi ci-dessous dans les commentaires…