IT & Engineering
Gubernator: Cloud-natives, verteiltes Rate-Limiting für Microservices

Mailgun freut sich, heute Gubernator als Open Source bereitzustellen – einen hochleistungsfähigen, verteilten Rate-Limiting-Microservice. Was macht Gubernator? Gute Frage:
Funktionen von Gubernator
- Gubernator verteilt Rate-Limit-Anfragen gleichmäßig über den gesamten Cluster. Das bedeutet, dass Sie das System durch das einfache Hinzufügen weiterer Knoten skalieren.
- Gubernator ist nicht auf externe Caches wie Memcache oder Redis angewiesen. Daher gibt es keine Deployment-Synchronisierung mit einem abhängigen Dienst. Dies macht die dynamische Vergrößerung oder Verkleinerung des Clusters in einem Orchestrierungssystem wie Kubernetes oder Nomad zu einer trivialen Angelegenheit.
- Gubernator speichert keinen Zustand auf der Festplatte. Die Konfiguration wird pro Anfrage vom Client übergeben.
- Gubernator bietet sowohl GRPC- als auch HTTP-Zugang zu seiner API.
- Lässt sich als Sidecar für Dienste, die Rate-Limiting benötigen, oder als separater Dienst ausführen.
- Lässt sich als Bibliothek verwenden, um einen domänenspezifischen Rate-Limiting-Dienst zu implementieren.
- Unterstützt optional eine Eventually-Consistent-Verteilung von Rate-Limits für Umgebungen mit extrem hohem Durchsatz.
- Gubernator ist die englische Aussprache des russischen Worts für Gouverneur – und es klingt einfach cool.
Sicherlich haben Sie viele Fragen dazu, warum wir uns entschieden haben, Gubernator als Open Source bereitzustellen. Bevor wir also darauf eingehen, wie Gubernator funktioniert, lassen Sie uns zunächst einige dieser Fragen beantworten. Die wichtigste Frage, die Sie sich wahrscheinlich stellen, ist…
Warum nicht Redis nutzen?
Bei der Evaluierung von Redis sind uns einige Dinge aufgefallen.
- Die Nutzung der grundlegenden Rate-Limit-Implementierung von Redis würde zusätzliche Netzwerk-Roundtrips verursachen, selbst mit Pipelining.
- Wir könnten die Roundtrips reduzieren, indem wir https://redis.io/commands/eval nutzen und ein LUA-Skript schreiben, das wir für jeden implementierten Algorithmus pflegen müssten.
- Jede einzelne Anfrage würde zu mindestens einem Roundtrip zu Redis führen. Kombiniert mit mindestens einem Roundtrip zu unserem Microservice bedeutet dies mindestens zwei Roundtrips pro Anfrage an unseren Dienst.
Die optimale Lösung für Redis besteht darin, ein LUA-Skript zu schreiben, das den Rate-Limit-Algorithmus implementiert. Dieses Skript wird dann auf dem Redis-Server gespeichert und für jede Rate-Limit-Anfrage aufgerufen. In diesem Szenario wird die meiste Arbeit von Redis erledigt und unser Microservice fungiert im Grunde als Proxy für den Zugriff auf Redis. Da dies der Fall ist, haben wir zwei Optionen:
- Gubernator als Rate-Limit-Bibliothek erstellen, die Zugriff auf Redis bietet. Diese Bibliothek würde von jedem Dienst verwendet werden, der Rate-Limiting benötigt.
- Redis eliminieren und die Verteilungs-, Caching- und Limiting-Algorithmen in einem Rate-Limiting-Microservice implementieren, der einen schlanken GRPC-Client für die Nutzung durch jeden Dienst bereitstellt.
Warum ein Microservice?
Mailgun ist ein polyglottes Unternehmen, wobei Python und Golang den Großteil unserer Codebasis ausmachen. Wenn wir uns entscheiden, Rate-Limiting als Bibliothek zu implementieren, erfordert dies mindestens eine Python- und eine Golang-Version der Bibliothek. Wir sind diesen Weg intern bereits mit einer Python- und Golang-Version derselben Bibliothek gegangen. Unserer Erfahrung nach haben gemeinsam genutzte Bibliotheken über verschiedene Dienste hinweg die folgenden Nachteile.
- Fehlerbehebungen und Funktionsupdates in der Bibliothek erfordern im besten Fall ein Update der Abhängigkeit. Im schlimmsten Fall sind Änderungen an allen Diensten erforderlich, die die Bibliothek verwenden, und zwar in allen unterstützten Sprachen.
- Selten möchte das Entwicklungsteam neue Funktionen in beiden Sprachen pflegen oder schreiben. Dies führt in der Regel dazu, dass eine Version der Bibliothek mehr Funktionen aufweist oder besser gepflegt wird als die andere.
Da die Anzahl der Microservices und Sprachen in unserem Ökosystem weiter wächst, summieren sich diese Probleme und verschlimmern sich. Im Vergleich dazu lassen sich GRPC- und HTTP-Bibliotheken für jede Sprache, die Zugriff auf Gubernator benötigt, leicht erstellen und pflegen.
Bei Microservices können Fehlerbehebungen und neue Funktionen ohne Unterbrechung abhängiger Dienste hinzugefügt werden. Solange Breaking Changes an der API nicht zulässig sind, können abhängige Dienste neue Funktionen aktivieren, ohne dass alle abhängigen Dienste aktualisiert werden müssen.
Das wichtigste Merkmal von Gubernator als Microservice ist, dass er einen Synchronisationspunkt für die vielen Anfragen schafft, die in das System gelangen. Anfragen, die innerhalb von wenigen Mikrosekunden eingehen, lassen sich optimieren und in Batches (Stapel) zusammenfassen. Dies reduziert die Gesamtbandbreite und die Roundtrip-Latenz, die der Dienst unter hoher Last aufweist. Mehrere Dienste, die alle auf einem einzigen Host laufen und bei denen dieselbe Bibliothek in ihren jeweiligen Prozessen ausgeführt wird, verfügen nicht über diese Fähigkeit.
Warum ist Gubernator zustandslos?
Gubernator ist zustandslos, da für den Betrieb kein Speicherplatz auf der Festplatte erforderlich ist. Es werden niemals Konfigurations- oder Cache-Daten auf die Festplatte synchronisiert. Das liegt daran, dass jede Anfrage an Gubernator die Konfiguration für das Rate-Limit enthält.
Zunächst könnte man meinen, dies bedeute einen unnötigen Overhead für jede Anfrage. In der Realität besteht eine Rate-Limit-Konfiguration jedoch nur aus vier 64-Bit-Ganzzahlen. Die Konfiguration setzt sich aus Limit, Duration (Dauer), Algorithm (Algorithmus) und Behavior (Verhalten) zusammen (siehe unten für Details zur Funktionsweise). Gerade aufgrund dieser einfachen Konfiguration kann Gubernator genutzt werden, um eine Vielzahl von Rate-Limit-Anwendungsfällen bereitzustellen, die Clients einsetzen können. Einige dieser Anwendungsfälle sind:
- Ingress-Limiting – Typisches HTTP-basiertes Limiting im Stil von „402 Too Many Requests“
- Traffic Shedding – Nur neue oder nicht authentifizierte Anfragen ablehnen, wenn sich Ihre API in einem schlechten Zustand befindet.
- Egress-Limiting – Externe SMTP-Server mit Millionen von Nachrichten zu bombardieren, ist keine gute Idee.
- Queue-Verarbeitung – Wissen, wann eine Anfrage sofort bearbeitet werden kann oder in die Warteschlange gestellt und in der Reihenfolge ihres Eingangs verarbeitet werden sollte.
- API-Kapazitätsmanagement – Globale Limits für die Gesamtzahl der Anfragen festlegen, die ein kollektives API-System verarbeiten kann. Anfragen, die die normale Betriebskapazität des Systems überschreiten, ablehnen oder in die Warteschlange stellen.
Zusätzlich zu den genannten Anwendungsfällen hat ein konfigurationsloses Design große Auswirkungen auf das Design und Deployment von Microservices:
- Keine Synchronisierung der Konfiguration beim Deployment. Wird ein Dienst bereitgestellt, der Gubernator nutzt, muss vorab keine Rate-Limit-Konfiguration für Gubernator deployt werden.
- Dienste, die Gubernator verwenden, besitzen ihr eigenes Rate-Limit-Domain-Modell für ihren Problembereich. Dadurch wird domänenspezifisches Wissen aus Gubernator ferngehalten, sodass sich Gubernator auf das konzentrieren kann, was es am besten kann: Rate-Limiting.
Abgesehen von diesen Fragen lassen Sie uns mehr über Gubernator als Ganzes sprechen, beginnend damit, wie es funktioniert.
Wie Gubernator funktioniert
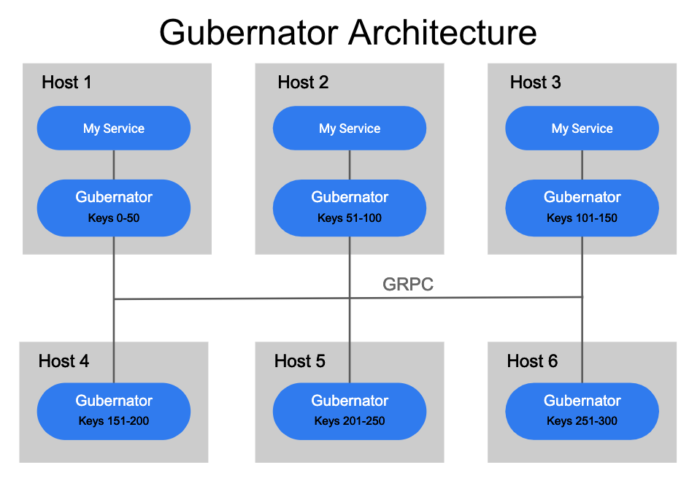
Gubernator ist so konzipiert, dass es als verteilter Cluster von Peers ausgeführt wird, die einen In-Memory-Cache aller derzeit aktiven Rate-Limits nutzen. Daher werden niemals Daten auf die Festplatte synchronisiert. Da die meisten netzwerkbasierten Rate-Limit-Dauern nur für wenige Sekunden aufrechterhalten werden, ist der Verlust des In-Memory-Caches während eines Neustarts oder einer geplanten Ausfallzeit kein großes Problem. Bei Gubernator ziehen wir Leistung der Genauigkeit vor, da es bei einem Cache-Verlust akzeptabel ist, wenn ein kleiner Teil des Datenverkehrs für kurze Zeit (meist Sekunden) zu viele Anfragen stellt.
Wird eine Rate-Limit-Anfrage an Gubernator gestellt, wird die Anfrage mit einem Schlüssel versehen und ein konsistenter Hashing-Algorithmus angewendet, um zu bestimmen, welcher Peer der Besitzer der Rate-Limit-Anfrage wird. Die Wahl eines einzigen Besitzers für ein Rate-Limit macht atomare Inkrementierungen von Zählern sehr schnell und vermeidet die Komplexität und Latenz, die mit der konsistenten Verteilung von Zählern über einen Cluster von Peers einhergeht.
Obwohl einfach und performant, könnte dieses Design anfällig für einen Ansturm von Anfragen (Thundering Herd) sein, da ein einziger Koordinator für möglicherweise Hunderttausende von Anfragen an ein Rate-Limit verantwortlich ist.
Um dem entgegenzuwirken, können Clients `Behaviour=BATCHING` anfordern. Dadurch können Peers mehrere Anfragen innerhalb eines festgelegten Zeitfensters (standardmäßig 500 Mikrosekunden) entgegennehmen und in einer einzigen Peer-Anfrage zusammenfassen. Dies reduziert die Gesamtzahl der Netzwerkanfragen an einen einzelnen Gubernator-Peer enorm.
Um sicherzustellen, dass jeder Peer im Cluster den richtigen Hash für einen Rate-Limit-Schlüssel exakt berechnet, muss die Liste der Peers im Cluster zeitnah und konsistent an jeden Peer verteilt werden. Derzeit unterstützt Gubernator die Nutzung von etcd oder der Kubernetes-Endpoints-API zur Erkennung von Gubernator-Peers.
Betrieb von Gubernator
Wenn ein Client oder Dienst eine Anfrage an Gubernator stellt, wird die Rate-Limit-Konfiguration bei jeder Anfrage vom Client bereitgestellt. Die Rate-Limit-Konfiguration wird dann zusammen mit dem aktuellen Rate-Limit-Status im lokalen Cache des Rate-Limit-Besitzers gespeichert. Rate-Limits und deren Konfiguration, die im lokalen Cache gespeichert sind, existieren nur für die angegebene Dauer der Rate-Limit-Konfiguration.
Nach Ablauf der Dauer und wenn das Rate-Limit innerhalb der Dauer nicht erneut angefragt wurde, wird es aus dem Cache verworfen. Nachfolgende Anfragen für denselben Namen und dasselbe unique_key-Paar erstellen die Konfiguration und das Rate-Limit im Cache neu, und der Zyklus wiederholt sich. Andererseits überschreiben nachfolgende Anfragen mit unterschiedlichen Konfigurationen die vorherige Konfiguration und wenden die neue Konfiguration sofort an.
Eine beispielhafte Rate-Limit-Anfrage über GRPC könnte wie folgt aussehen:
rate_limits:rn # Scopes the request to a specific rate limit rn - name: requests_per_secrn # A unique_key that identifies this rate limit requestrn unique_key: account_id=123|source_ip=172.0.0.1rn # The number of hits we are requestingrn hits: 1rn # The total number of requests allowed for this rate limitrn limit: 100rn # The duration of the rate limit in millisecondsrn duration: 1000rn # The algorithm used to calculate the rate limit rn # 0 = Token Bucketrn # 1 = Leaky Bucketrn algorithm: 0rn # The behavior of the rate limit in gubernator.rn # 0 = BATCHING (Enables batching of requests to peers)rn # 1 = NO_BATCHING (Disables batching)rn # 2 = GLOBAL (Enable global caching for this rate limit)rn behavior: 0
Eine beispielhafte Antwort wäre:
rate_limits:rn # The status of the rate limit. OK = 0, OVER_LIMIT = 1rn - status: 0,rn # The current configured limitrn limit: 10,rn # The number of requests remainingrn remaining: 7,rn # A unix timestamp in milliseconds of when the rate limit will reset,rn # or if OVER_LIMIT is set it is the time at which the rate limitrn # will no longer return OVER_LIMIT.rn reset_time: 1551309219226,rn # Additional metadata about the request the client might find usefulrn metadata:rn # This is the name of the node that owns this requestrn "owner": "api-n03.staging.us-east-1.mailgun.org:9041"
Globales Verhalten
Da Gubernator-Rate-Limits gehasht und von einem einzigen Peer im Cluster verarbeitet werden, würden Rate-Limits, die für jede Anfrage in einem Rechenzentrum gelten, dazu führen, dass die Rate-Limit-Anfrage von einem einzigen Peer für das gesamte Rechenzentrum verarbeitet wird.
Betrachten wir zum Beispiel ein Rate-Limit mit name=requests_per_datacenter und unique_id=us-east-1. Stellen Sie sich nun vor, dass für jede HTTP-Anfrage, die in das Rechenzentrum us-east-1 eingeht, eine Anfrage an Gubernator mit diesem Rate-Limit gestellt wird. Dies könnten Hunderttausende oder sogar potenziell Millionen von Anfragen pro Sekunde sein, die alle gehasht und von einem einzigen Peer im Cluster verarbeitet werden. Aufgrund dieses potenziellen Skalierungsproblems führt Gubernator ein konfigurierbares behavior (Verhalten) namens GLOBAL ein.
Wird ein Rate-Limit mit behavior=GLOBAL konfiguriert, wird die von einem Client empfangene Rate-Limit-Anfrage nicht an den besitzenden Peer weitergeleitet. Stattdessen wird sie aus einem internen Cache beantwortet, der von dem Peer verwaltet wird, der die Anfrage empfangen hat. Hits für das Rate-Limit werden vom empfangenden Peer als Batch zusammengefasst und asynchron an den besitzenden Peer gesendet. Dort werden die Hits summiert und das OVER_LIMIT berechnet. Es liegt dann in der Verantwortung des besitzenden Peers, jeden Peer im Cluster mit dem aktuellen Status des Rate-Limits zu aktualisieren, sodass die internen Caches der Peers routinemäßig aktualisiert werden – mit dem aktuellsten Rate-Limit-Status vom Besitzer.
Nebeneffekte des globalen Verhaltens
Da Hits gebatcht und asynchron an den besitzenden Peer weitergeleitet werden, enthält die unmittelbare Antwort an den Client nicht die genauesten remaining-Zählwerte. Dieser Zählwert wird erst aktualisiert, nachdem der asynchrone Aufruf an den Besitzer-Peer abgeschlossen ist und der besitzende Peer Zeit hatte, alle Peers im Cluster zu aktualisieren. Infolgedessen ermöglicht die Verwendung von GLOBAL eine größere Skalierung, jedoch auf Kosten der Konsistenz. Die Nutzung von GLOBAL kann die Traffic-Menge pro Rate-Limit-Anfrage erhöhen, wenn der Cluster groß genug ist. GLOBAL sollte nur für extrem hochvolumige Rate-Limits verwendet werden, die mit dem traditionellen Nicht-GLOBAL-Verhalten schlecht skalieren.
Gubernator-Leistung
In unserer Produktionsumgebung senden wir für jede Anfrage an unsere API zwei Rate-Limit-Anfragen zur Auswertung an Gubernator: eine zur Bewertung der HTTP-Anfrage und die andere zur Bewertung der Anzahl der Empfänger, an die eine Person innerhalb der spezifischen Dauer eine E-Mail senden kann. Unter diesem Setup bearbeitet ein einzelner Gubernator-Knoten über 2.000 Anfragen pro Sekunde, wobei die meisten gebatchten Antworten in weniger als einer Millisekunde zurückgegeben werden.
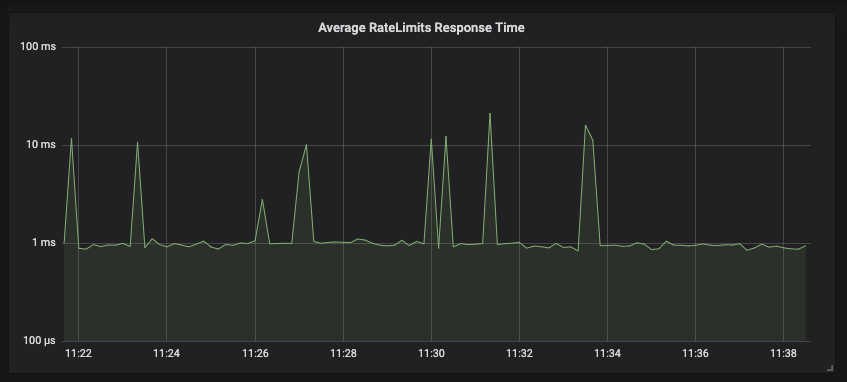
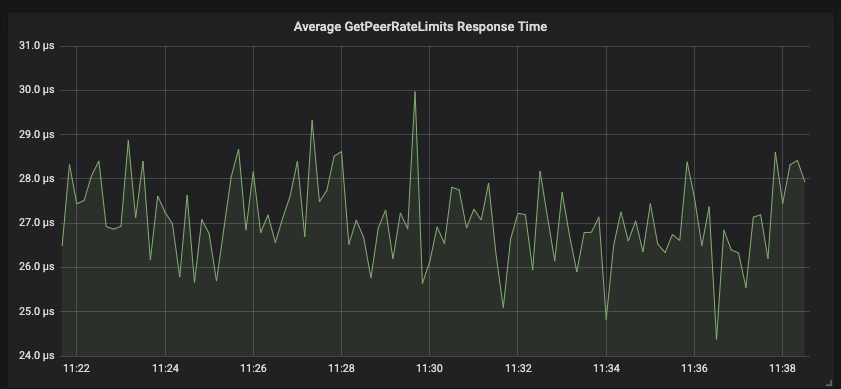
An besitzende Knoten weitergeleitete Peer-Anfragen antworten typischerweise in unter 30 Mikrosekunden.
Da viele unserer öffentlich zugänglichen APIs in Python geschrieben sind, führen wir viele Python-Interpreter-Instanzen auf einem einzigen Knoten aus. Diese Python-Instanzen leiten Anfragen lokal an die Gubernator-Instanz weiter, die diese dann in Batches zusammenfasst und an besitzende Knoten weiterleitet.
Gubernator ermöglicht es der Nutzerschaft, ein Nicht-Batching-Verhalten zu wählen, was die Latenz für Client-Rate-Limit-Anfragen weiter reduzieren würde. Aufgrund von Durchsatzanforderungen verwendet unsere Produktionsumgebung jedoch Behaviour=BATCHING mit dem standardmäßigen 500-Mikrosekunden-Fenster. In der Produktion haben wir während der Spitzen-API-Nutzung Batch-Größen von 1.000 beobachtet. Andere, die nicht dieselben hohen Traffic-Anforderungen haben, könnten das Batching deaktivieren und würden geringere Latenzen feststellen, allerdings auf Kosten des Durchsatzes.
Gubernator als Bibliothek
Wenn Sie Golang nutzen, können Sie Gubernator als Bibliothek verwenden. Dies ist nützlich, wenn Sie einen Rate-Limit-Dienst implementieren möchten, der auf Ihrem eigenen unternehmensspezifischen Modell aufbaut. Wir tun dies intern hier bei Mailgun mit einem Dienst, den wir kreativ ratelimits genannt haben und der die Limits pro Account verfolgt. Auf diese Weise nutzen Sie die Leistung und Geschwindigkeit von Gubernator, legen aber dennoch Geschäftslogik darüber und integrieren domänenspezifische Probleme in Ihren Rate-Limiting-Dienst.
Wenn Sie die Bibliothek verwenden, wird Ihr Dienst zu einem vollwertigen Mitglied des Clusters und nimmt an demselben konsistenten Hashing und Caching teil wie ein eigenständiger Gubernator-Server. Alles, was Sie tun müssen, ist die GRPC-Serverinstanz bereitzustellen und Gubernator mitzuteilen, wo sich die Peers in Ihrem Cluster befinden.
Fazit
Die Nutzung von Gubernator als vielseitiger Rate-Limiting-Dienst ermöglicht es uns, auf eine Microservice-Architektur zu vertrauen, ohne Kompromisse bei der Dienstunabhängigkeit einzugehen oder die Doppelarbeit zu riskieren, die bei gängigen Rate-Limiting-Lösungen erforderlich ist. Wir hoffen, dass durch die Veröffentlichung dieses Projekts als Open Source auch andere mitwirken und von der Arbeit profitieren können, die wir hier begonnen haben.
Möchten Sie bei Mailgun arbeiten? Wir stellen ein. Und es sind mehrere Stellen im Entwicklungsteam offen. Aktuelle Stellenangebote hier ansehen.


