IT & Engineering
Wie wir eine 30-fache Performance-Verbesserung bei den MongoDB-Lese-Einstellungen erzielt haben

Sie wissen ja, was man sagt: Je redundanter man ist, desto redundanter ist man.
Replica-Sets sind Datenbankprozesse, die eine hohe Verfügbarkeit gewährleisten und Serverausfälle durch Redundanz reduzieren. Sie bilden die Grundlage für Produktionsumgebungen und sind eigentlich nicht als eigenständige Tools gedacht, mit denen sich Ihre Antwortzeit und Performance-Metriken verbessern lassen. Bei Mailgun fielen uns hohe Antwortzeiten bei einem unserer Nodes auf, der den Support für diese Prozesse übernimmt. Wir hassen es, ausgebremst zu werden – vor allem, wenn es keinen Sinn ergibt. Also machten wir uns daran, das Problem zu beheben.
Abnormale Antwortzeiten: Ursachenfindung
Im Jahr 2021 fielen uns seltsame Performance-Probleme bei den Antwortzeiten für USW2 auf. Warum wir das jetzt erwähnen? Wir profitieren immer noch von den durchgeführten Anpassungen und möchten dieses Wissen gerne mit Ihnen teilen.
Zunächst fiel uns auf, dass unser Rate-Limit-Service (basierend auf Gubernator) bei unseren Prozessen in USW2 durchgängig Antwortzeiten von 150 ms aufwies. Seltsamerweise lag derselbe Code im 99. Perzentil der Anfragen bei durchschnittlich 5 ms. Diese Latenz war besonders seltsam, da wir im 50. Perzentil eine durchschnittliche Antwortzeit von etwa 2 ms erzielen. Es gab also etwas, das wir unbedingt untersuchen mussten.
Unser Ausgangspunkt war der Vergleich der Metriken zwischen USW2 und USW1. Wir fügten weitere Metriken hinzu, um zu erfassen, wie lange der Abruf der Rate-Limit-Definitionen aus MongoDB dauerte (bei Cache-Fehlschlägen), wodurch wir ein besseres Verständnis der Vorgänge erhielten.
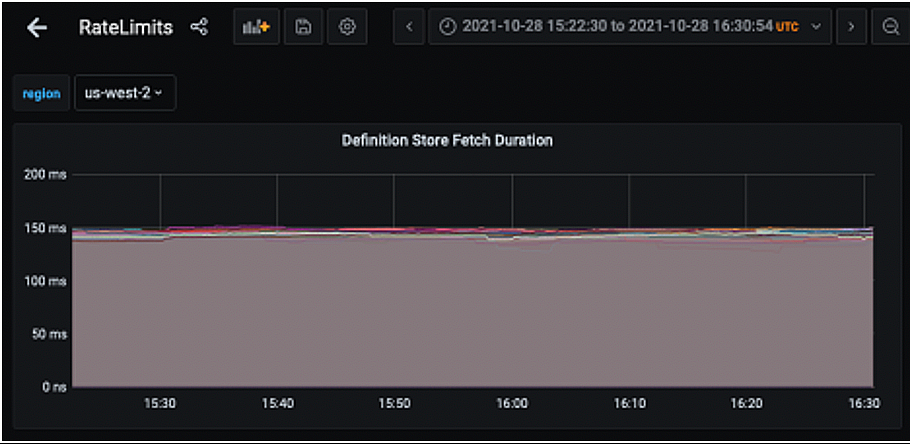
Das daraus resultierende Diagramm bestätigte den Trend von 150 ms in USW2, zeigte aber auch Antwortzeiten von 2–5 ms von MongoDB in USE1. Damit war das Problem eingegrenzt und es stand fest, dass etwas mit der MongoDB-Konfiguration nicht stimmte, das sich speziell auf USW2 auswirkte.
MongoDB-Performance: Erkenntnisse aus der Dokumentation
Damit war „Schritt 1: Problemfindung“ abgeschlossen.
Als Nächstes haben wir uns intensiv mit der MongoDB-Dokumentation befasst. Der Aha-Moment kam, als wir die Haupttopologie von MongoDB verstanden und die Standard-Lese-Einstellungen von MongoDB entdeckten. MongoDB-Clients bevorzugen beim Lesen die primäre Instanz in einem Cluster. Es ist nicht immer von Vorteil, wenn Ihre Datenbank Favoriten hat.
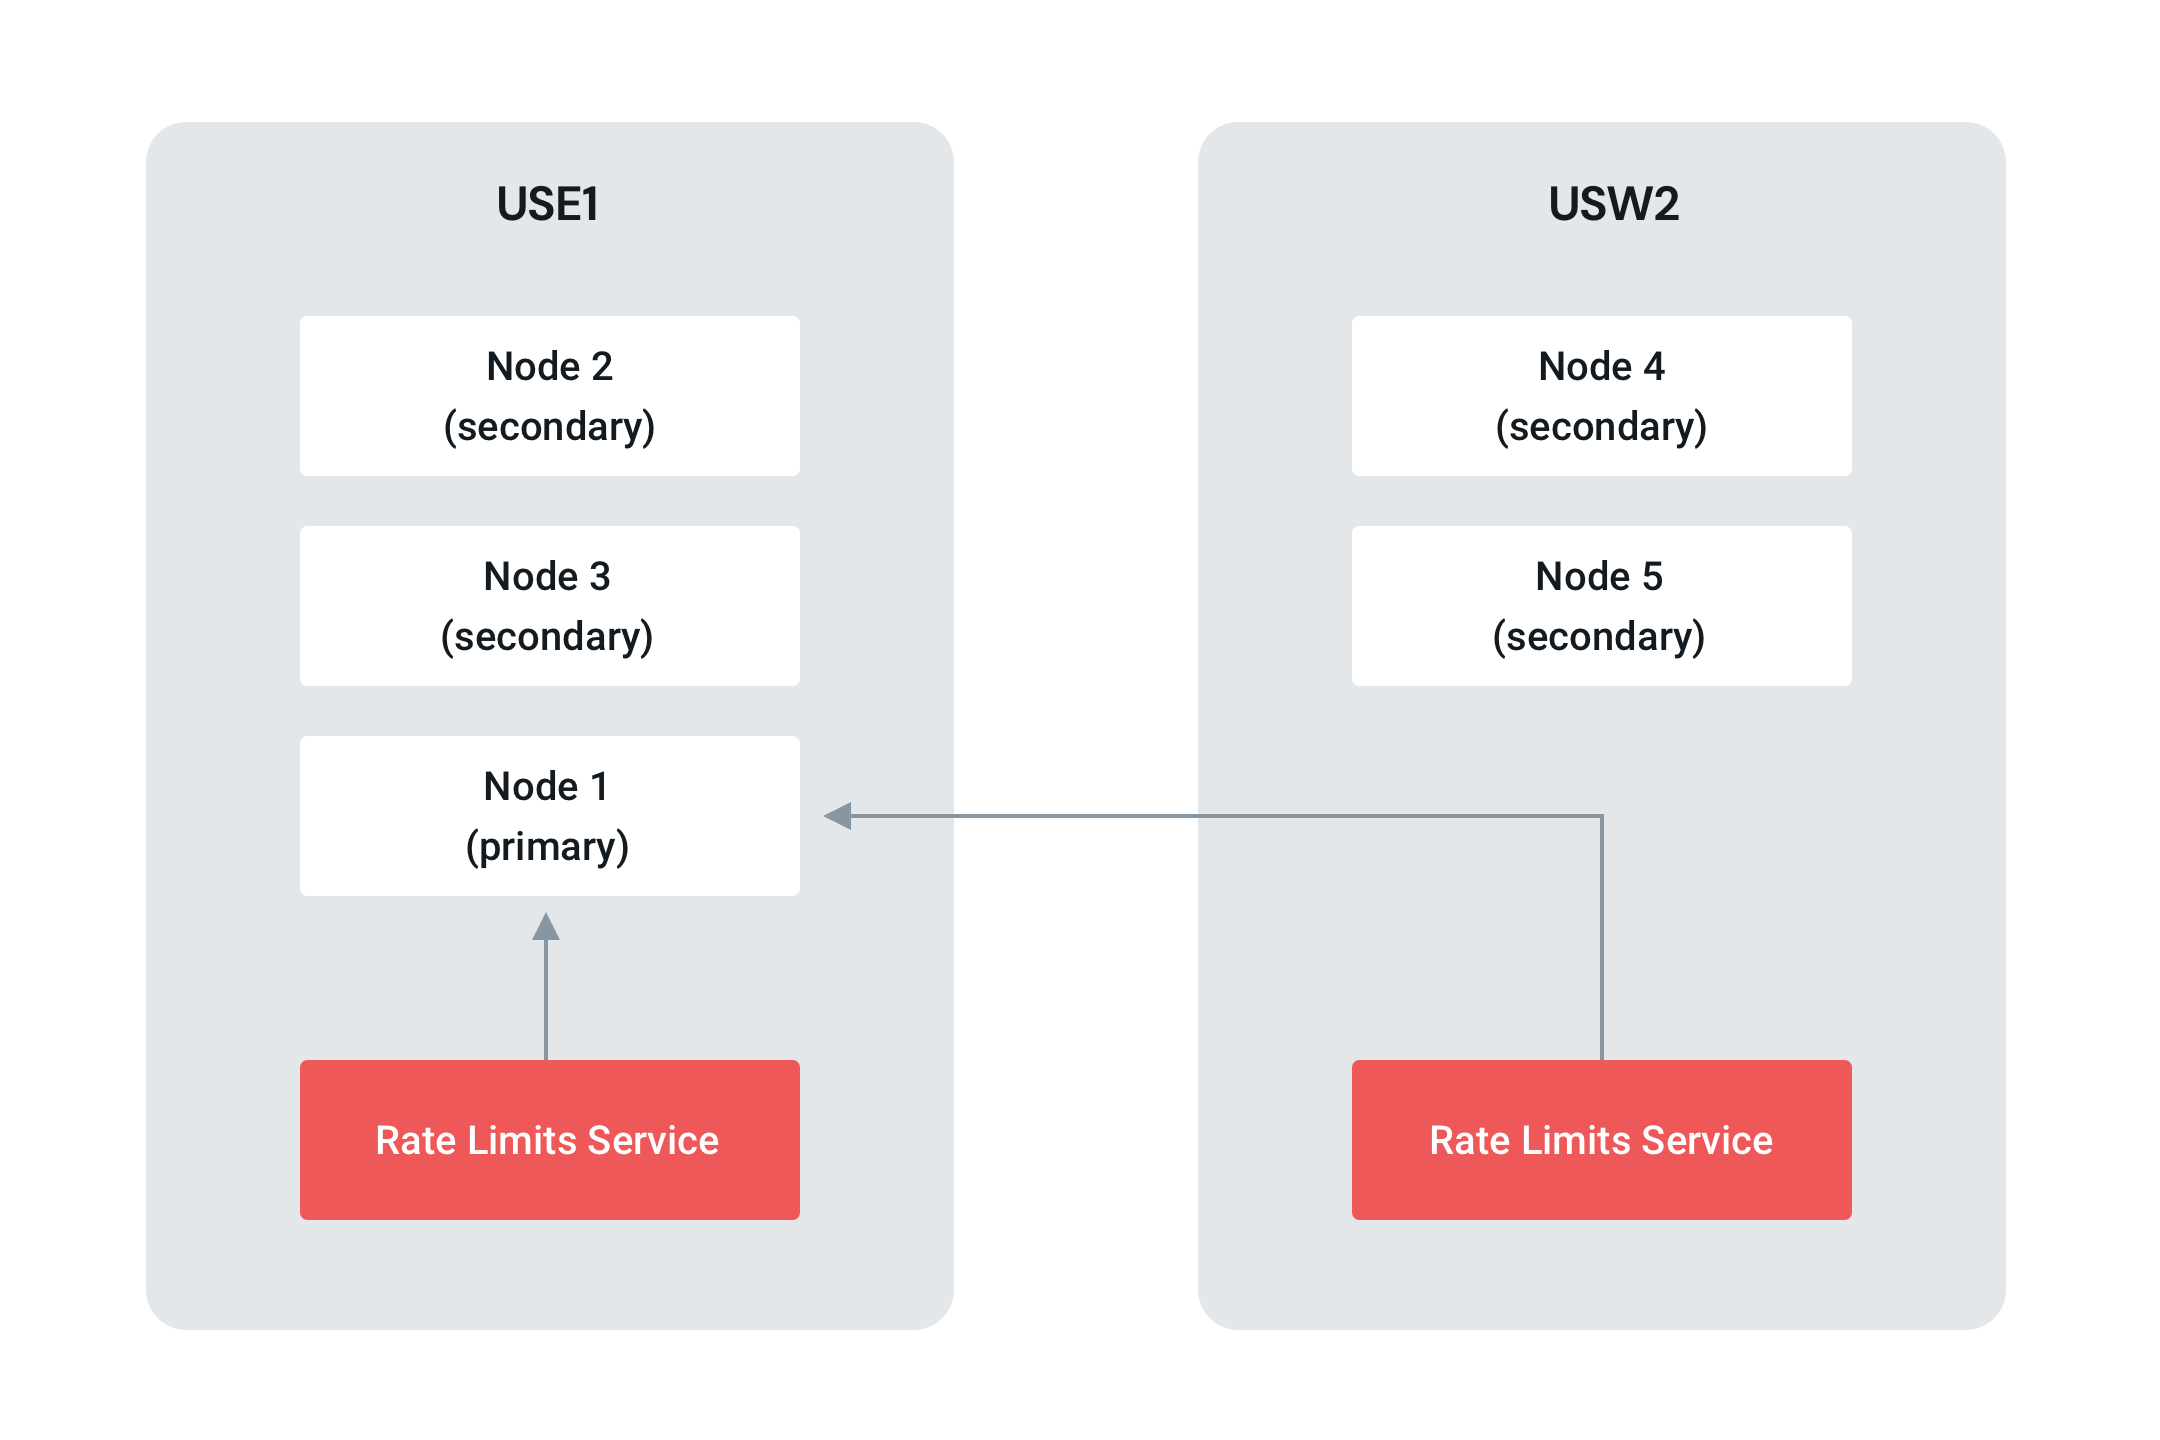
In der Standardkonfiguration des MongoDB-Clients las der Client in USW2 regionsübergreifend aus dem primären Node in USE1. Die MongoDB-Standardwerte sind so festgelegt, dass Vorgänge aus sekundären Elementen lesen, es sei denn, das Set verfügt über eine einzelne primäre Instanz.
Die Dokumentation wies darauf hin, dass wir durch die Verwendung von readPreference=secondaryPreferred in unserem MongoDB-Client in der Lage wären, eine Verbindung zu den lokalen MongoDB-Nodes herzustellen, anstatt nur zum primären Node (USE1).
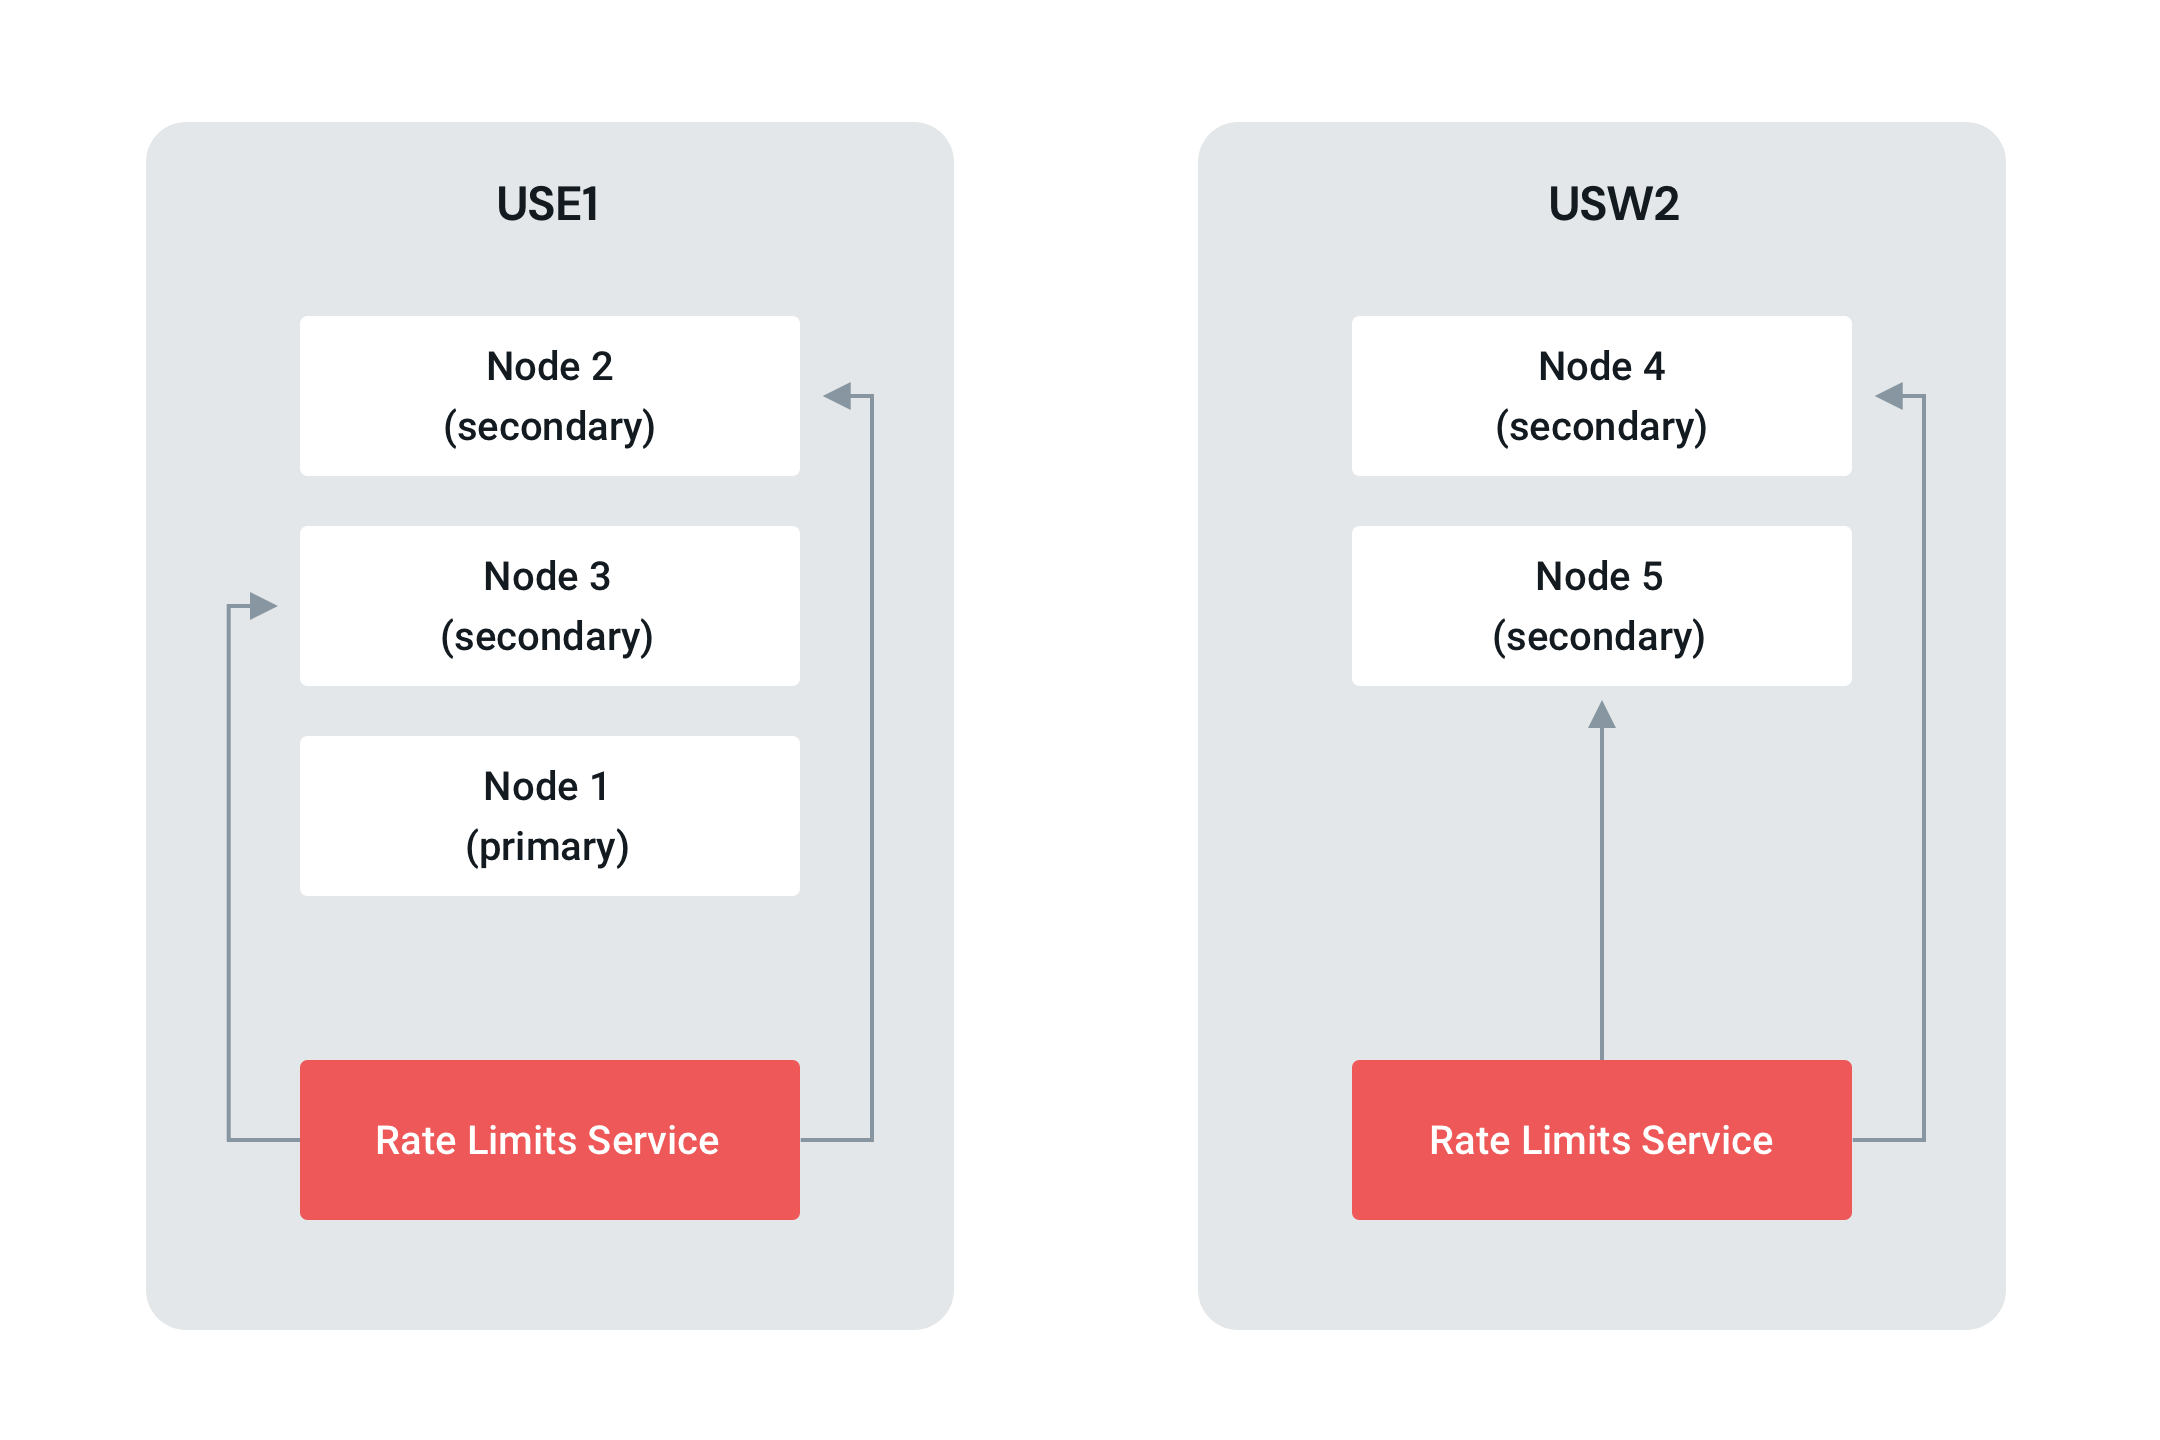
Perfekt. Diese Strukturierung würde es uns ermöglichen, die Performance zu optimieren, indem wir die Lesezugriffe auf mehrere sekundäre Server verteilen, sodass jeder Server auf weniger Leseanfragen antwortet. Wir dachten, dass die Aktualisierung unserer Lese-Einstellungen das Problem lösen würde, aber so einfach ist es leider selten, oder? Manchmal ist die Situation eher ein Clusterf@%* (Wortspiel beabsichtigt).
Fehlerbehebung beim Golang Mongo Client
Wir dachten wirklich, dass wir es mit diesen Lese-Einstellungen geschafft hätten, aber nun schlug die Verbindung zum Cluster über die URI fehl:
mongodb://mongo-main-n01-us-east-1.postgun.com:27017,mongo-main-n02-us-eas t-1.postgun.com:27017,mongo-main-n03-us-east-1.postgun.com:27017/?tlsCerti ficateKeyFile=/etc/mailgun/ssl/mongo.pem&tlsCAFile=/etc/mailgun/ssl/mongo ca.crt&replicaSet=main&readPreference=secondary&readPreferenceTags=dc:use1 &readPreferenceTags=dc:usw2
Es stellte sich heraus, dass wir eine ältere Version des MongoDB-Clients nutzten (go.mongodb.org/mongo-driver v1.0.2), die für unsere TLS-Optionen keinen Support bot. Als wir das herausgefunden hatten, konnten wir endlich die Bereitstellung vornehmen und prüfen, ob die Aktualisierung unserer Lese-Einstellungen Auswirkungen hatte, nachdem wir ein Upgrade auf go.mongodb.org/mongo-driver v1.7.3 vorgenommen und ein kleines Problem mit dem URI-Format in unserem Framework behoben hatten:
PIP-1477: URIWithOptions() now correctly injects a '/' after host list by thrawn01 · Pull Request #92 · mailgun/holster
Performance-Verbesserung bei MongoDB
Das brachte schließlich den gewünschten Erfolg. Die Auswirkung war enorm und führte zu einer ~30-fachen Verbesserung (Antwortzeit von 5–10 ms im 99. Perzentil) der Lese-Performance in USW2. Nicht schlecht.
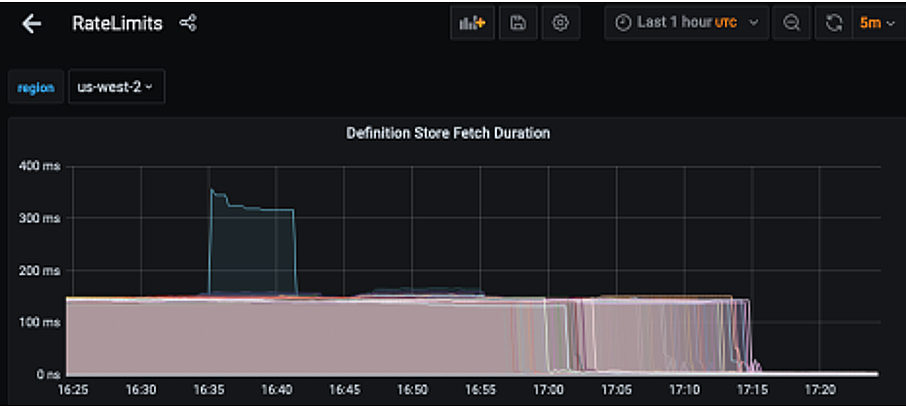
Unsere Lösung begann mit der Untersuchung der Abrufraten, um den betroffenen Server zu isolieren, und führte uns dazu, unsere Logik der Lese-Einstellungen auf der Grundlage der Dokumentation des MongoDB-Clients zu optimieren. Letztendlich fanden wir heraus, dass es sich auch um ein Versionsproblem handelte und wir unseren MongoDB Go Driver aktualisieren mussten, um erfolgreich eine Verbindung zur Cluster-URI herzustellen und unsere Antwortzeit zu verbessern.
Wie wir auch weiterhin optimieren
Die Ursachendiagnose gehört zum Entwicklungsalltag und die Lösung von Performance-Problemen erfolgt Schritt für Schritt. Wenn Sie ähnliche Latenzen in Ihren Metriken feststellen, beginnen Sie mit der Überprüfung Ihrer Server, Rate-Limit-Services, und vergessen Sie nicht, den Support für Features Ihrer Mongo-Treiberversion zu überprüfen.
Mit derartigen Untersuchungen und Updates arbeiten wir daran, ein besseres Gesamtsystem und ein noch besseres Nutzererlebnis zu schaffen. Wenn Sie mehr von unserem Entwicklungsteam hören möchten, sollten Sie unseren Newsletter abonnieren, um künftig keine Berichte und Einblicke in den Betrieb zu verpassen.




