IT & Engineering
Comment nous avons multiplié par 30 nos performances grâce aux préférences de lecture de MongoDB

Vous connaissez le dicton… plus il y a de redondance, plus il y a de redondance.
Les jeux de répliques sont des processus de base de données qui offrent une haute disponibilité et réduisent les pannes de serveur grâce à la redondance. Ils constituent la base des déploiements en production et ne sont pas vraiment conçus comme des outils autonomes destinés à améliorer vos temps de réponse et vos statistiques de performance. Chez Mailgun, nous avons remarqué des temps de réponse élevés sur l’un de nos nœuds prenant en charge ces processus. Nous détestons les ralentissements, surtout lorsqu’ils n’ont aucun sens. Nous avons donc décidé d’y remédier.
Temps de réponse anormaux : trouver la cause principale
En 2021, nous avons remarqué d’étranges problèmes de performance dans nos temps de réponse pour la région USW2. Pourquoi en parler aujourd’hui ? Eh bien, nous bénéficions toujours des mises à jour que nous avons effectuées et nous souhaitons partager notre expérience.
Nous avons d’abord remarqué que notre service de limitation de débit (basé sur Gubernator) affichait des temps de réponse constants de 150 ms pour nos processus dans la région USW2. Étrangement, le même code affichait une moyenne d’environ 5 ms dans le 99e centile des requêtes. Cette latence était particulièrement curieuse, car nous avons en moyenne un temps de réponse d’environ 2 ms dans le 50e centile. Il y avait donc un problème que nous devions absolument examiner.
Notre point de départ a été de comparer les statistiques entre USW2 et USW1. Nous avons ajouté des statistiques supplémentaires afin de générer un rapport sur le temps nécessaire pour récupérer les définitions de limitation de débit depuis MongoDB (en cas d’absence dans le cache), ce qui nous a permis de mieux comprendre ce qui se passait.
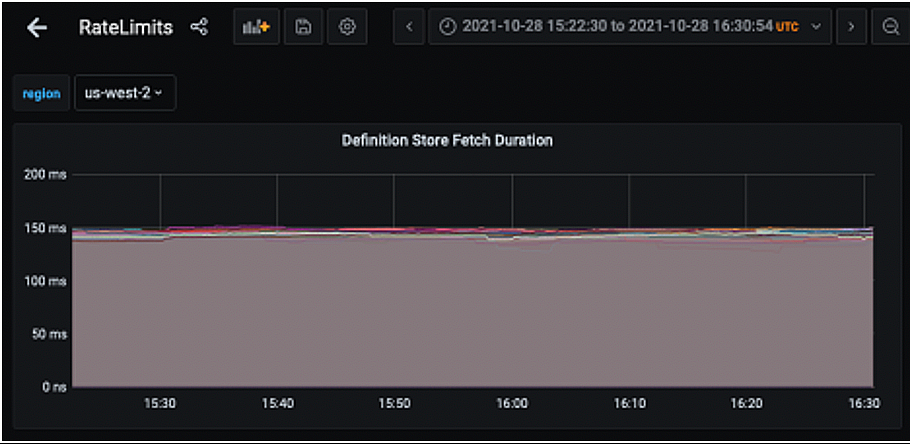
Le graphique qui en a résulté a confirmé la tendance à 150 ms dans la région USW2, mais a également montré des temps de réponse de 2 à 5 ms depuis MongoDB dans la région USE1. Cela a permis d’isoler le problème et de confirmer que la configuration de MongoDB affectait spécifiquement la région USW2.
Performances de MongoDB : enseignements tirés de la documentation
L’étape 1, « Localiser le problème », était donc terminée.
Ensuite, nous nous sommes plongés dans la documentation de MongoDB. L’illumination est venue lorsque nous avons compris la topologie principale de MongoDB et découvert les préférences de lecture par défaut de MongoDB. Les clients MongoDB préfèrent l’instance principale d’un cluster lors des lectures. Ce n’est pas toujours idéal lorsque votre base de données fait du favoritisme.
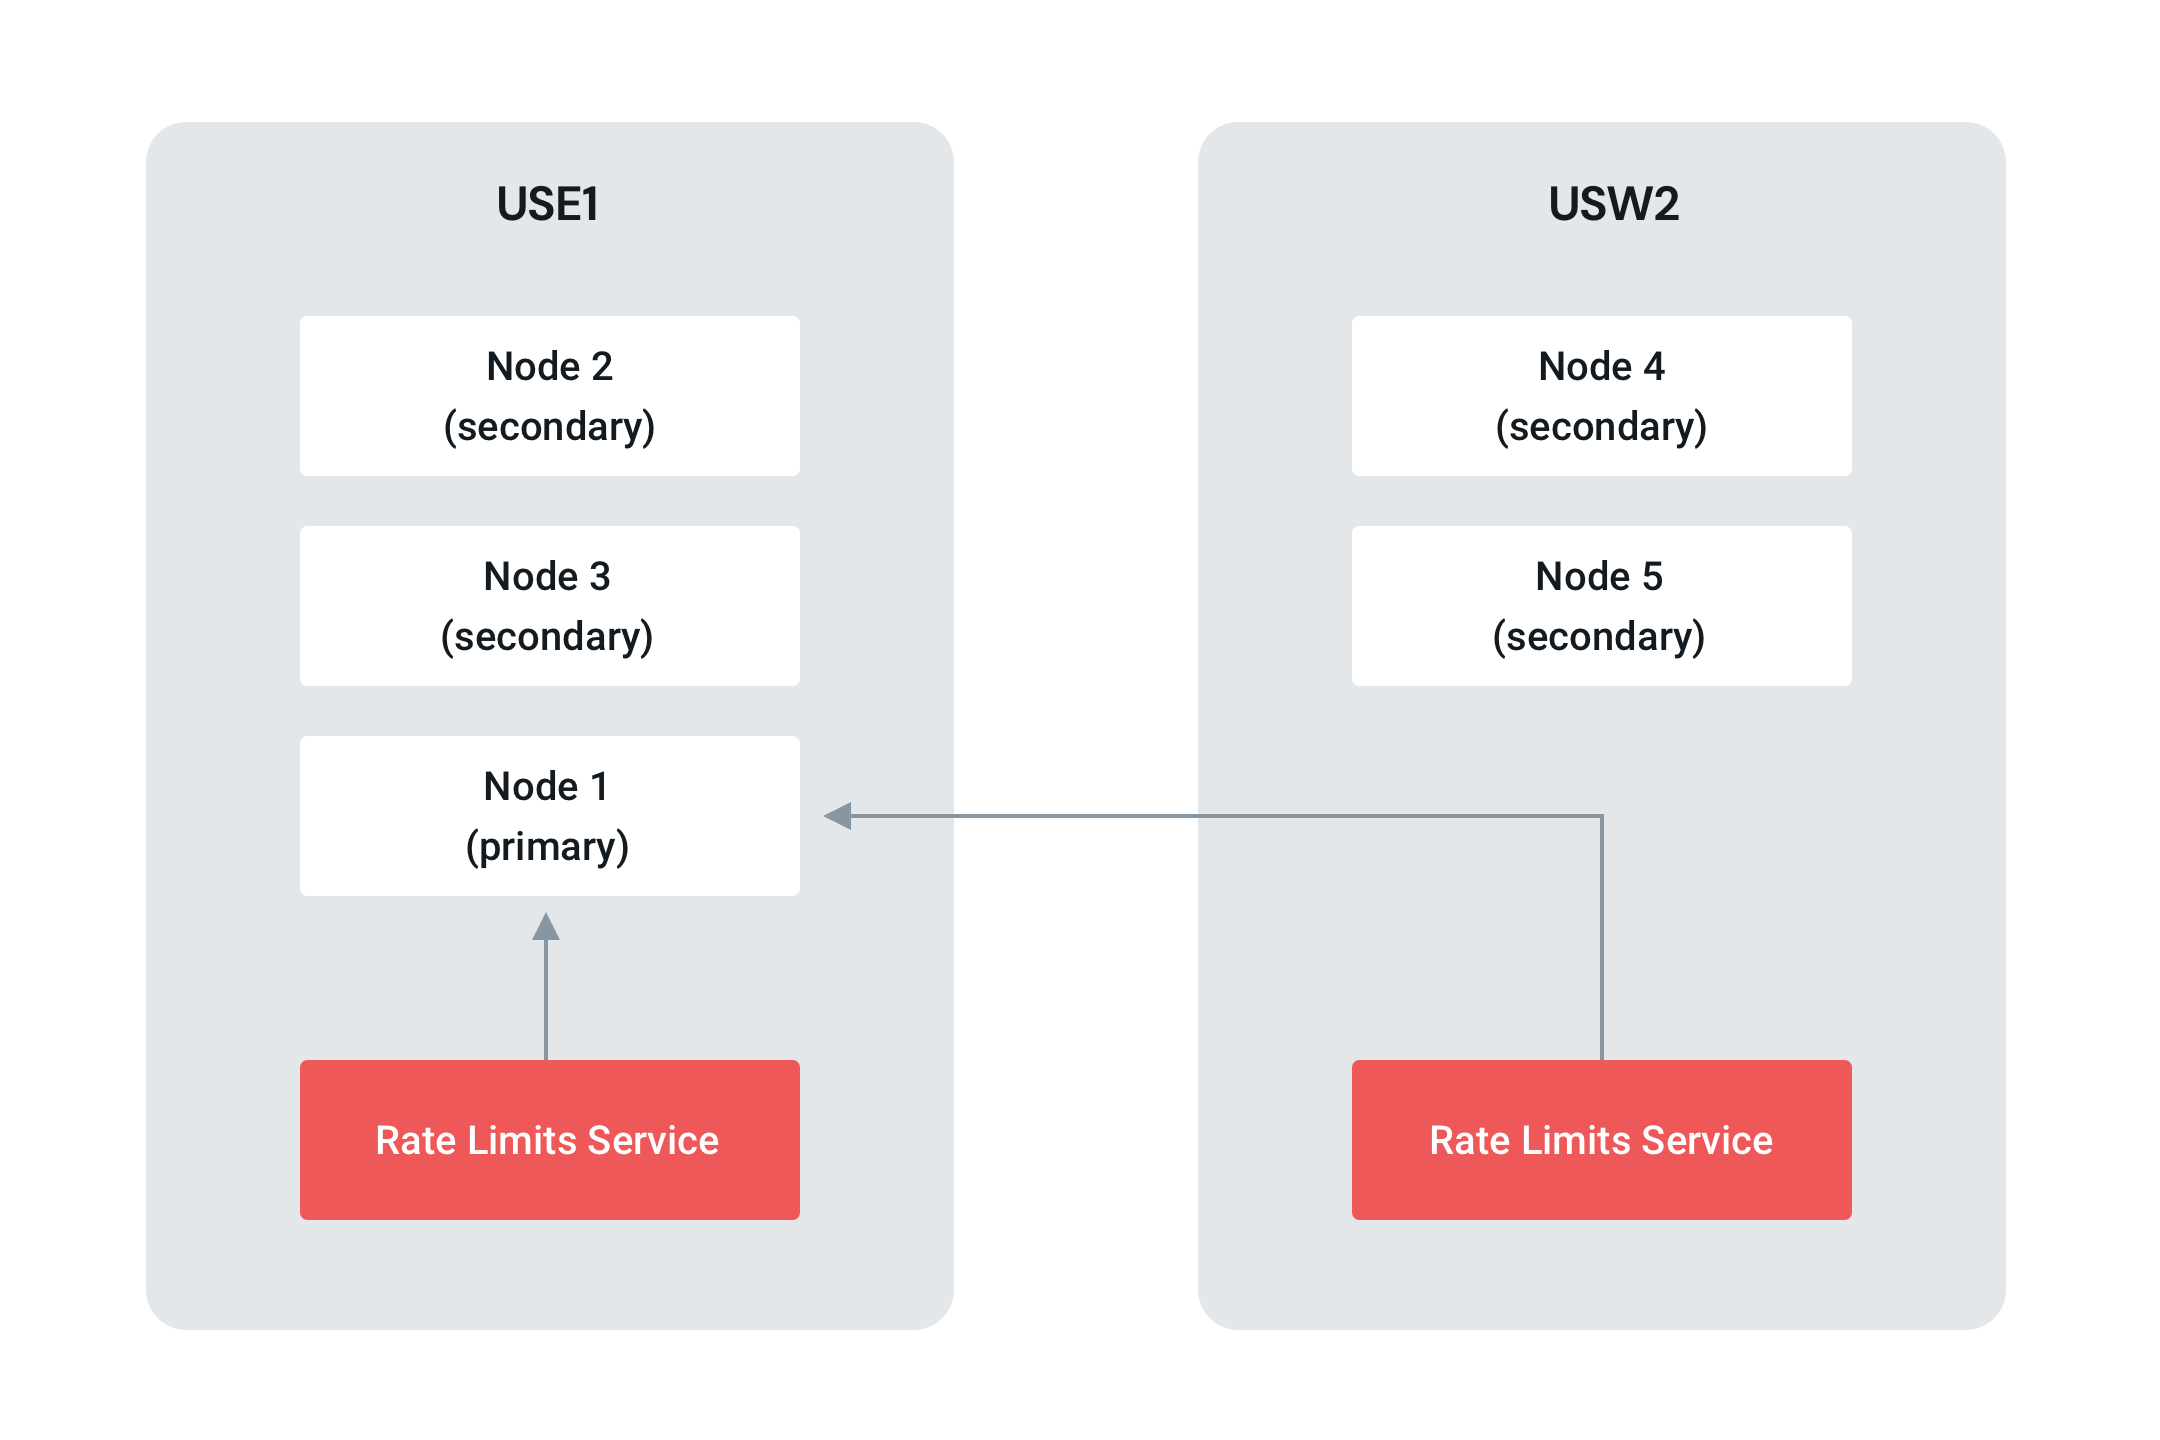
Dans la configuration par défaut du client MongoDB, le client de la région USW2 effectuait des lectures inter-régions vers le nœud principal de la région USE1. Les paramètres par défaut de MongoDB sont définis de sorte que les opérations lisent depuis les membres secondaires, à moins que le jeu ne possède un seul nœud principal.
Leur documentation indiquait que si nous utilisions readPreference=secondaryPreferred dans notre client MongoDB, nous pourrions nous connecter aux nœuds MongoDB locaux au lieu du seul nœud principal (USE1).
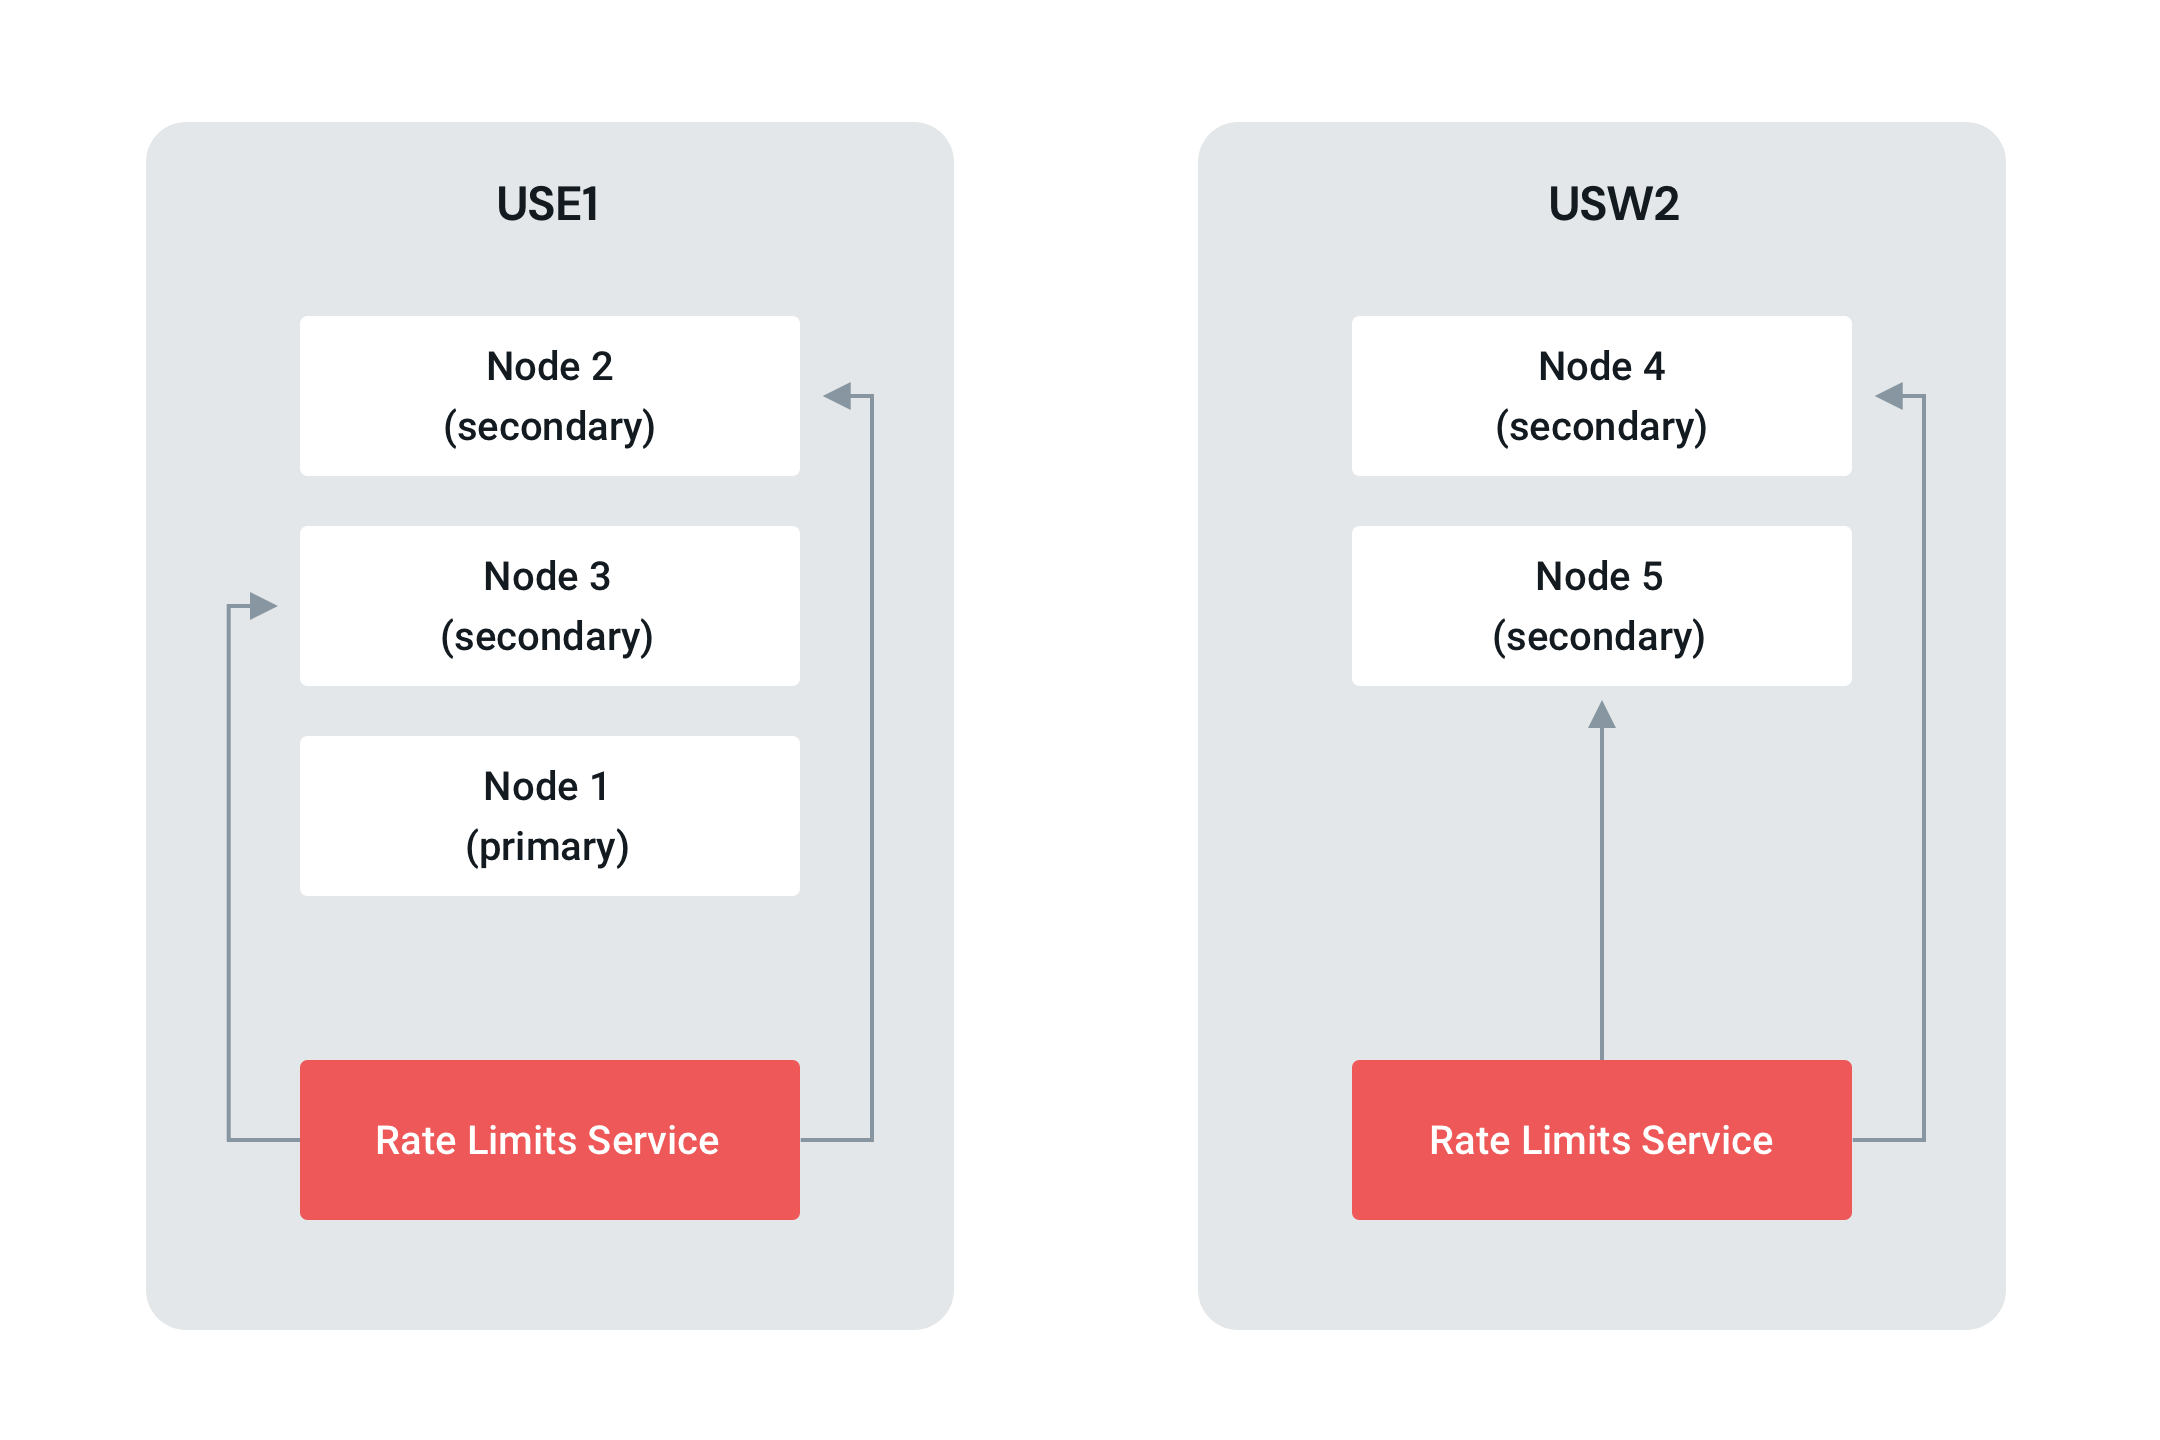
Parfait. Cette structuration nous permettrait d’optimiser les performances, en répartissant les lectures sur plusieurs serveurs secondaires où chaque serveur répondrait à un nombre réduit de requêtes de lecture. Nous pensions que la mise à jour de nos préférences de lecture résoudrait le problème, mais ce n’est jamais aussi simple, n’est-ce pas ? Parfois, la situation s’apparente plutôt à un véritable clusterf@%* (jeu de mots assumé).
Dépannage du client Mongo Golang
Nous pensions vraiment avoir trouvé la solution avec ces préférences de lecture, mais voilà que nous n’arrivions plus à nous connecter au cluster en utilisant l’URI :
mongodb://mongo-main-n01-us-east-1.postgun.com:27017,mongo-main-n02-us-eas t-1.postgun.com:27017,mongo-main-n03-us-east-1.postgun.com:27017/?tlsCerti ficateKeyFile=/etc/mailgun/ssl/mongo.pem&tlsCAFile=/etc/mailgun/ssl/mongo ca.crt&replicaSet=main&readPreference=secondary&readPreferenceTags=dc:use1 &readPreferenceTags=dc:usw2
Il s’est avéré que nous utilisions une ancienne version du client MongoDB (go.mongodb.org/mongo-driver v1.0.2) qui ne prenait pas en charge nos options TLS. Une fois que nous l’avons compris, nous avons enfin pu déployer et vérifier si la mise à jour de nos préférences de lecture avait un impact après avoir mis à niveau vers go.mongodb.org/mongo-driver v1.7.3, et résolu un problème mineur de format d’URI avec notre framework :
PIP-1477: URIWithOptions() now correctly injects a '/' after host list by thrawn01 · Pull Request #92 · mailgun/holster
Amélioration des performances de MongoDB
Cela a finalement résolu le problème. L’effet a été spectaculaire, se traduisant par des performances de lecture environ 30 fois supérieures (temps de réponse de 5 à 10 ms dans le 99e centile) pour la région USW2. Pas mal.
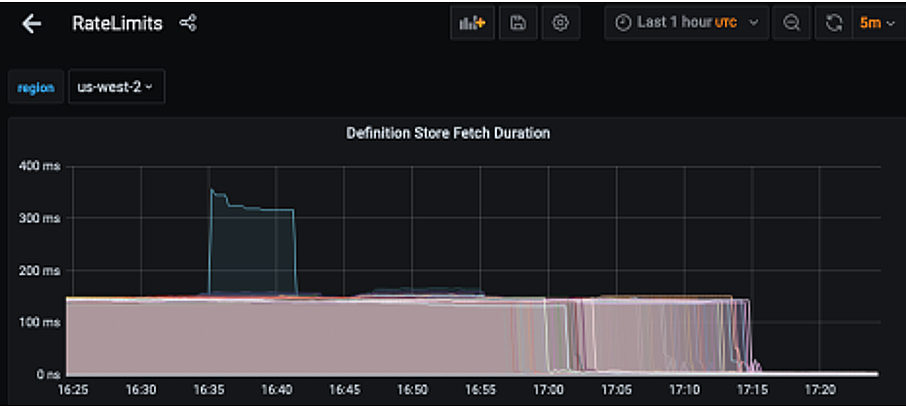
Notre solution a commencé par une analyse des taux de récupération afin d’isoler le serveur affecté, ce qui nous a conduits à optimiser notre logique de préférences de lecture en nous basant sur la documentation du client MongoDB. En fin de compte, nous avons découvert qu’il s’agissait également d’un problème de version et que nous devions mettre à jour notre pilote MongoDB pour Go afin de nous connecter avec succès à l’URI du cluster et d’améliorer notre temps de réponse.
Diagnostiquer la cause principale fait partie du quotidien de l’équipe de développement, et la résolution des problèmes de performance se fait couche par couche. Si vous constatez une latence similaire dans vos statistiques, commencez par évaluer vos serveurs, vos services de limitation de débit, et n’oubliez pas de vérifier la prise en charge des fonctionnalités de la version de votre pilote Mongo.
Les analyses et les mises à jour de ce type reflètent notre manière de travailler afin de créer un meilleur système global et une expérience utilisateur optimale. Alors, si vous souhaitez en savoir plus sur notre équipe d’ingénierie, n’hésitez pas à vous inscrire pour ne rien manquer de nos prochaines histoires et de nos informations sur les opérations.




Comment nous continuons à optimiser