IT & Engineering
GroupCache: Der überlegene Golang-Cache

Der Golang-Cache macht verteiltes Caching und die Synchronisierung einfach und lässt sich mit GroupCache leicht bereitstellen. Aber warum ist dies das überlegene Tool? Und welche Probleme löst es? Bei Mailgun haben wir GroupCache eingesetzt, um die Latenz in unserem Rate-Limiting-Service zu reduzieren. Wir haben von der Synchronisierung profitiert und gleichzeitig Deadlock-Probleme bei der Erstellung und Verwaltung eindeutiger Ressourcen vermieden. Wenn Sie noch nicht überzeugt sind, ist das in Ordnung. Wir sind sicher, dass Sie es am Ende dieses Artikels sein werden.
Was ist ein verteilter Cache?
Ein Cache ist eine Hochgeschwindigkeits-Speicherlösung, die stark nachgefragte Daten vorhält, um den Datenzugriff und -abruf zu beschleunigen. Ein verteilter Cache unterteilt den Cache in Segmente und verteilt diese, sodass jeder Knoten in einem Server-Cluster nur ein Segment des gesamten Caches enthält. Auf diese Weise lässt sich der Cache weiter skalieren, indem dem Cluster einfach neue Knoten hinzugefügt werden.
Dies ist aus mehreren Gründen wichtig.
- Verteilte Caches ermöglichen es dem Cache, mit den Daten zu wachsen. Sie sind in Umgebungen mit hohem Datenvolumen und großer Auslastung von Vorteil.
- Ein verteilter Cache kann sich über mehrere Server erstrecken, was ihm eine weitaus höhere Transaktionskapazität verleiht.
Wie funktioniert verteiltes Caching?
Verteilte Caching-Systeme wie Redis und Memcached-Clients funktionieren in der Regel so:
- Die App fragt die zwischengespeicherten Daten über einen Schlüssel beim Client an.
- Anschließend führt der Client einen Consistent Hash auf den Schlüssel aus, um festzustellen, welcher Knoten über die Daten verfügt.
- Sobald der Client die Daten lokalisiert hat, sendet er eine Netzwerkanfrage an den Knoten.
- Der Knoten gibt die Daten zurück, falls diese gefunden werden.
- Die App prüft, ob Daten zurückgegeben werden. Andernfalls rendert oder ruft sie die Daten aus der Datenbank ab.
- Die App weist den Client an, Daten für diesen Schlüssel zu speichern.
- Der Client führt einen Consistent Hash auf den Schlüssel aus, um festzustellen, welcher Knoten die Daten besitzen soll.
- Abschließend speichert der Client die Daten auf dem Knoten.
Wenn man sich diesen Ablauf ansieht, fallen zwei wesentliche Auswirkungen auf:
- Jede Cache-Anfrage führt zu einem Roundtrip zu einem Knoten, unabhängig davon, ob es sich um einen Cache-Hit oder -Miss handelt.
- Sie können den Roundtrip zu einem Knoten nicht vermeiden, indem Sie den Wert lokal zwischenspeichern, da der entfernte Knoten die Daten jederzeit ohne Wissen der App invalidieren könnte.
Obwohl keine dieser Auswirkungen für die meisten Anwendungen besonders problematisch ist, können die zusätzlichen Roundtrips zur Datenbank Anwendungen mit hoher Leistung und geringer Latenz beeinträchtigen. Es gibt jedoch noch eine weitere Auswirkung, die möglicherweise nicht sofort ersichtlich ist: das Thundering-Herd-Problem.
Das Thundering-Herd-Problem lösen: Cache Stampedes und hohe Nebenläufigkeit
Das Thundering-Herd-Problem ist ein Ansturm von Anfragen, der das System überlastet. Dieses Problem, das manchmal auch als Cache Stampede, Dogpiling oder Slashdot-Effekt bezeichnet wird, tritt auf, wenn mehrere Instanzen einer Anwendung gleichzeitig versuchen, auf Daten zuzugreifen.
In diesem Kontext ist unsere Thundering Herd eine Reaktion auf einen Cache-Miss, was bedeutet, dass die Daten entweder entfernt oder nie in den Cache gelegt wurden. Beispielsweise bleibt eine Anwendung im Normalbetrieb auch unter starker Auslastung responsiv, solange die Daten zwischengespeichert bleiben.
Wenn der Cache nicht über die Daten verfügt, könnte diese Thundering Herd durch gleichzeitige Prozesse das System überlasten, was zu Staus und einem potenziellen Zusammenbruch des Systems führt.
Um diese gleichzeitigen Prozesse zu bewältigen, benötigen Sie ein System zur Synchronisierung des Abrufs oder Renderings der Daten. Glücklicherweise gibt es eine Golang-Bibliothek namens GroupCache, die verwendet werden kann, um das Thundering-Herd-Problem zu lösen und die erwähnten Auswirkungen des Remote-Caches zu verbessern.
Was ist GroupCache und wie schneidet es im Vergleich zu anderen Caching-Lösungen ab?
Es gibt viele Caching-Lösungen auf dem Markt. GroupCache von Golang ist eine Open-Source-Lösung, die sich von beliebten Tools wie BigCache, Redis und Memcache unterscheidet, da sie sich als In-Code Distributed Cache (ICDC) direkt in Ihren Code integriert. Dies bedeutet, dass jede Instanz der App ein Knoten im verteilten Cache ist. Der Vorteil? Als vollwertiges Mitglied des verteilten Caches kennt jede Anwendungsinstanz die Datenstrukturen – nicht nur, wie Daten für den Knoten gespeichert werden, sondern auch, wie die Daten abgerufen oder gerendert werden, falls sie fehlen.
Um zu verstehen, warum dies Redis oder Memcached überlegen ist, gehen wir den Ablauf des verteilten Cachings bei der Verwendung von GroupCache durch. Behalten Sie beim Lesen des Ablaufs im Hinterkopf, dass GroupCache eine Bibliothek ist, die von der Anwendung verwendet wird und auch auf eingehende Anfragen von anderen Instanzen der Anwendung lauscht, die GroupCache verwenden.
- Die App fragt die Daten über einen Schlüssel beim GroupCache an.
- Als Nächstes prüft der GroupCache den In-Memory-Hot-Cache auf die Daten. Wenn keine Daten vorhanden sind, wird fortgefahren.
- Der GroupCache führt einen Consistent Hash auf den Schlüssel aus, um festzustellen, welche GroupCache-Instanz über die Daten verfügt.
- Dann sendet der GroupCache eine Netzwerkanfrage an die GroupCache-Instanz, die die Daten hat.
- Der GroupCache gibt die Daten zurück, wenn sie im Arbeitsspeicher vorhanden sind. Andernfalls bittet er die App, die Daten zu rendern oder abzurufen.
- Abschließend gibt der GroupCache die Daten an die GroupCache-Instanz zurück, die die Anfrage initiiert hat.
Schritt 5 ist im Kontext eines Thundering-Herd-Ereignisses von Bedeutung, da nur eine der GroupCache-Instanzen das Rendering oder den Abruf der angeforderten Daten durchführt. Alle anderen Instanzen der Anwendung, die die Daten ebenfalls bei der GroupCache-Instanz anfragen, werden blockiert, bis die besitzende Instanz der Anwendung die Daten erfolgreich rendert oder abruft. Dies schafft einen natürlichen Synchronisationspunkt für den Datenzugriff im verteilten System und verhindert das Thundering-Herd-Problem.
Schritt 2 ist ebenfalls von Bedeutung, da die Möglichkeit, die Daten lokal im Arbeitsspeicher zwischenzuspeichern, die Kosten eines Netzwerk-Roundtrips vermeidet. Dies bietet einen enormen Leistungsvorteil und reduziert die Netzwerkbelastung. Da GroupCache ein Teil der Anwendung ist, vermeiden wir die Möglichkeit, dass der GroupCache die Daten ohne Wissen der Anwendung löscht, da ein solches Löschereignis von allen Instanzen der Anwendung geteilt wird, die GroupCache verwenden.
Ein zugegebenermaßen kleinerer Vorteil – aber einer, den diejenigen von uns, die Einfachheit schätzen, begrüßen werden – betrifft die Bereitstellung. Obwohl es nicht allzu schwierig ist, Redis und Memcached als separate Entitäten von der Anwendung bereitzustellen und abzusichern, bedeutet eine einzige bereitzustellende Anwendung für Betreiber eine Aufgabe weniger, die sie verwalten, aktuell halten und absichern müssen.
Es lohnt sich, dies noch einmal zu erwähnen, da man es leicht übersieht. Die Fähigkeit der Cache-Implementierung, die Daten bei einem Cache-Miss aus einer Datenbank zu rendern oder abzurufen, sowie die Möglichkeit, sich auf einen lokalen In-Memory-Hot-Cache zu verlassen, machen GroupCache zu einer überlegenen Wahl unter den verteilten Caches. Kein verteilter Cache außerhalb Ihrer Anwendung kann diese Vorteile bieten.
GroupCache als Synchronisierungstool
Da GroupCache großartige Synchronisierungssemantiken bietet, haben wir festgestellt, dass GroupCache bei der Erstellung und Verwaltung eindeutiger Ressourcen eine überlegene Alternative zu Sperren auf Verteilungs- oder Datenbankebene ist.
Als Beispiel liest unsere interne Analysen-Engine Tausende von Ereignissen und fügt dynamisch Tags mit zugewiesenen Statistiken hinzu. Da bei uns viele Instanzen der Engine ausgeführt werden, muss jedes neue erkannte Tag als potenziell neues Tag behandelt werden. Normalerweise würde dies einen konstanten Strom von Upsert-Anfragen an unsere Datenbank erzeugen. Durch die Verwendung von GroupCache kann jede Instanz den Cache mit dem Schlüssel account:tag abfragen.
Wenn das Tag bereits existiert, wird es mit den neuesten Daten zum Tag zurückgegeben. Wenn das Tag jedoch nicht existiert, leitet GroupCache die Anfrage an die besitzende Instanz weiter und erstellt das Tag. Auf diese Weise wird nur ein einziges Upsert an die Datenbank gesendet, wenn das System auf ein neues Tag stößt.
Auf ähnliche Weise verwenden wir GroupCache zum Zählen eindeutiger Zähler, bei denen das System nur eine einzige Instanz eines Zählers erfassen soll. Da wir Groupcache verwenden, vermeiden wir die Nutzung einer verteilten Sperre und Deadlock-Probleme vollständig. Dies ist besonders nützlich, wenn eine NoSQL-Datenbank verwendet wird, die über wenig bis gar keine eigenen Sperr- oder Synchronisierungssemantiken verfügt.
Verwendung von GroupCache
Mailgun nutzt eine modifizierte Version von Brad Fitzpatricks (patrickmn) originaler GroupCache-Bibliothek auf github.com.
Nennenswerte Änderungen an der Bibliothek sind:
- Support für die explizite Entfernung von Schlüsseln aus einer Gruppe.
Remove() - Support für abgelaufene Werte.
SetBytes(),SetProto()undSetString()akzeptieren jetzt eine optionaletime.Time{}, die einen Zeitpunkt in der Zukunft darstellt, an dem der Wert abläuft. - Support für den Golang-Standard
context.Context - Füllt immer den Hot-Cache auf.
- Um GroupCache zu verwenden, erstellen Sie einen Pool von Instanzen, mit denen jede GroupCache-Instanz kommuniziert. Anschließend erstellen Sie mehrere unabhängige Cache-Gruppen, die denselben Pool von Instanzen verwenden.
- Behalten Sie die Peers in unserem Cluster im Auge und fügen Sie unsere Instanz zum Pool hinzu `
http://localhost:8080` pool := groupcache.NewHTTPPoolOpts("http://localhost:8080", &groupcache.HTTPPoolOptions{}) - Fügen Sie weitere Peers hinzu
pool.Set("http://peer1:8080", "http://peer2:8080") - Erstellen Sie einen neuen Gruppen-Cache mit einer maximalen Cache-Größe von 3 MB group: =
groupcache.NewGroup("users", 3000000, groupcache.GetterFunc( func(ctx context.Context, id string, dest groupcache.Sink) error { // Gibt ein Protobuf-Struct `User` zurück if user, err := fetchUserFromMongo(ctx, id); err != nil { return err } - Legen Sie fest, dass der Nutzer im Groupcache nach 5 Minuten abläuft
if err := dest.SetProto(&user, time.Now().Add(time.Minute*5)); err != nil { return err } return nil }, )) - var user User
- Rufen Sie die Definition aus dem Gruppen-Cache ctx ab,
cancel := context.WithTimeout(context.Background(), time.Second*10) if err := group.Get(ctx, “key”, groupcache.ProtoSink(&user)); err != nil { return nil, err } cancel()
So implementieren Sie es mit HTTP/2 und TLS
GroupCache verwendet HTTP zur Kommunikation zwischen Instanzen im Cluster. Wenn Ihre Anwendung ebenfalls HTTP verwendet, kann GroupCache denselben HTTP-Port wie Ihre Anwendung nutzen. Fügen Sie den Pool einfach als Handler mit einem eigenen Pfad hinzu.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
Wenn für Ihre Anwendung TLS konfiguriert ist, profitiert GroupCache von derselben TLS-Konfiguration, die Ihre Anwendung verwendet. Zudem besteht die Möglichkeit, HTTP/2 zu aktivieren, was die Leistung von GroupCache-Anfragen weiter verbessert. Sie können HTTP/2 auch ohne TLS über H2C verwenden.
Mailguns Update zur Schlüsselentfernung
Ein nennenswerter Unterschied der Mailgun-Version von GroupCache ist die Möglichkeit, Schlüssel explizit aus dem Cache zu löschen. Wenn eine Instanz einen Schlüssel entfernen möchte, löscht sie den Schlüssel zunächst aus der besitzenden Instanz und sendet dann die Löschanfragen an alle anderen Instanzen im Pool. Dadurch wird sichergestellt, dass alle zukünftigen Anfragen von Nicht-Eigentümer-Instanzen im Pool an den Eigentümer zu einem neuen Abruf oder Rendering der Daten führen (oder zu einem Fehler, falls die Daten nicht mehr verfügbar sind).
Wie bei jedem verteilten System besteht die Möglichkeit, dass eine Instanz nicht verfügbar ist oder die Verbindung unterbrochen wurde, als die Entfernungsanfrage gestellt wurde. In diesem Szenario gibt group.Remove() einen Fehler zurück, der darauf hinweist, dass einige Instanzen nicht kontaktiert wurden, und die Art des Fehlers angibt.
Je nach Anwendungsfall hat der Nutzer dann die Möglichkeit, den Aufruf von group.Remove() erneut zu versuchen oder den Fehler zu ignorieren. Für einige Systeme kann es akzeptabel sein, den Fehler zu ignorieren, insbesondere wenn Sie die Funktion für abgelaufene Werte verwenden.
Die Funktion für abgelaufene Werte ermöglicht es Ihnen, eine optionale Ablaufzeit time.Time anzugeben, die einen zukünftigen Zeitpunkt festlegt, an dem die Daten ablaufen sollen.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
In dem oben genannten Szenario, in dem wir vorübergehend die Verbindung zu einer Instanz verlieren, sprechen wir davon, dass sich der Instanzen-Pool in einem inkonsistenten Zustand befindet. Bei Verwendung in Verbindung mit der Datenablauffunktion wissen wir jedoch, dass das System schließlich wieder konsistent wird, wenn die Daten auf den getrennten Instanzen ablaufen.
Es gibt andere, weitaus komplexere Lösungen für dieses Problem, aber wir haben in der Praxis festgestellt, dass Eventually-Consistent-Lösungen der einfachste und am wenigsten fehleranfällige Weg sind, um mit Netzwerkunterbrechungen umzugehen.
Leistungsverbesserungen von Mailgun durch die Verwendung von GroupCache
Bei Mailgun erfolgte der erste produktive Einsatz von GroupCache in unserem Rate-Limit-Service. Da dieser Service auf einem sehr hohen Leistungs- und niedrigen Latenzniveau arbeiten muss, waren herkömmliche Caching-Systeme bedenklich: Je mehr Roundtrips wir in die Anfrage-Pipeline einführten, desto mehr Möglichkeiten gab es für zusätzliche Latenzen.
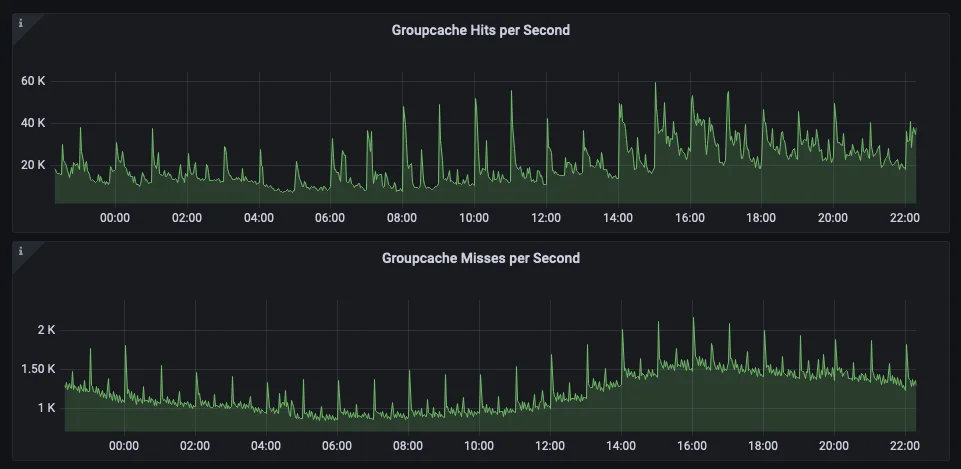
Die folgenden Diagramme zeigen die Gesamtzahl der Cache-Hits sowie die Gesamtzahl der Hits, die zu einem Roundtrip zu einer anderen GroupCache-Instanz geführt haben. Dies demonstriert genau, wie sehr wir vom lokalen In-Memory-Hot-Cache profitieren, anstatt bei jeder Anfrage einen Roundtrip-Aufruf durchzuführen.
Im nächsten Diagramm können Sie genau sehen, wie sehr MongoDB und unsere Anwendung von der Vermeidung des Thundering-Herd-Problems profitieren, wenn neue Schlüssel aus dem System abgerufen werden.
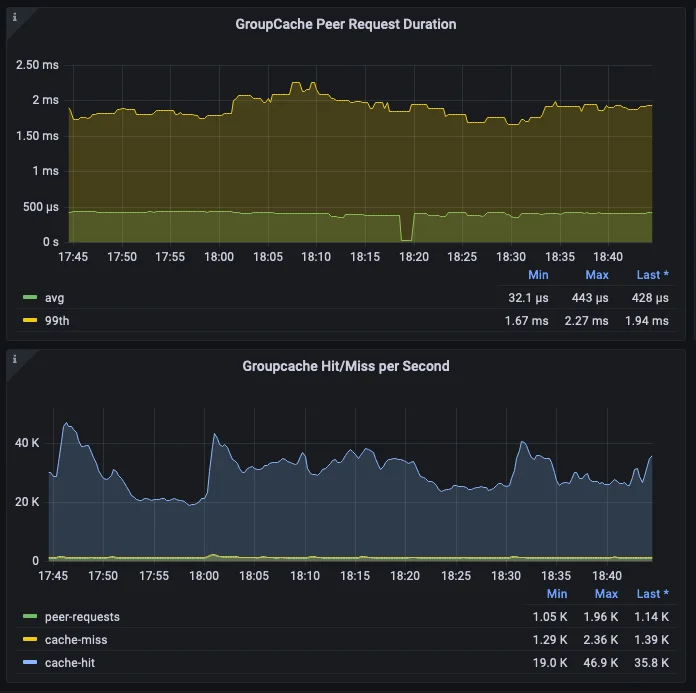
Die tatsächlichen Aufrufe von MongoDB machen nur einen kleinen Bruchteil der gesamten Anfragen aus, die tatsächlich an den Service gestellt werden. Zusammen mit der Geschwindigkeit von Gubernator ermöglicht dies unserem Rate-Limit-Service, auch bei hoher Auslastung mit geringer Latenz zu arbeiten.
Hier sehen Sie die Antwortzeit-Metriken des Rate-Limits-Service. Bedenken Sie, dass wir für jede Anfrage einen Gubernator-Aufruf und eine GroupCache-Anfrage durchführen, was in einer GroupCache-HTTP-Anfrage oder MongoDB-Anfrage resultieren kann – aber nicht muss. (Dieses Diagramm zeigt die langsamsten Antworten, nicht den Durchschnitt).
Fazit: Verteiltes Caching leicht gemacht
GroupCache hat die Leistung unserer Dienste bei Mailgun verbessert. Es macht verteiltes Caching und Synchronisierung einfach und leicht bereitzustellen. Ich hoffe, dass andere dieselben Vorteile entdecken, die wir genießen, und dass dies weitere ICDC-Implementierungen in anderen Sprachen inspiriert.
War das hilfreich? Bei Mailgun evaluieren und implementieren wir ständig neue Wege, um unsere Dienste zu skalieren und unsere Leistung zu verbessern. Das ist nicht immer einfach. Wir würden uns freuen, wenn Sie aus unseren Erfahrungen lernen. Abonnieren Sie unseren Newsletter für weitere Inhalte wie diesen.


