IT & Engineering
GroupCache: o cache superior para Golang

O cache para Golang torna o cache distribuído e a sincronização simples e fáceis de implantar com o GroupCache. Mas por que essa é a ferramenta superior? E quais problemas ela resolve? Na Mailgun, usamos o GroupCache para reduzir a latência em nosso serviço de limitação de taxa e colhemos os benefícios da sincronização, evitando problemas de deadlock ao criar e gerenciar recursos exclusivos. Se você não está convencido, tudo bem. Temos certeza de que estará no final deste texto.
O que é um cache distribuído?
Um cache é uma solução de armazenamento de memória de alta velocidade que retém dados de alta demanda para acelerar a recuperação e o acesso aos dados. Um cache distribuído divide o cache em segmentos e os distribui de forma que cada nó em um cluster de servidores contenha apenas um segmento de todo o cache. Dessa forma, o cache pode continuar a escalar simplesmente adicionando novos nós ao cluster.
Isso é importante por alguns motivos.
- Caches distribuídos permitem que o cache cresça à medida que os dados crescem. Eles são vantajosos em ambientes com alto volume de dados e carga.
- Um cache distribuído pode abranger vários servidores, proporcionando uma capacidade de transação muito maior.
Como funciona o cache distribuído?
Sistemas de cache distribuído, como clientes do Redis e Memcached, geralmente funcionam assim:
- O App solicita ao Client os dados em cache por meio de uma chave.
- Em seguida, o Client realiza um hash consistente na chave para determinar qual Node possui os dados.
- Assim que o Client localiza os dados, ele faz uma solicitação de rede para o Node.
- O Node retorna os dados, se forem encontrados.
- O App verifica se os dados foram retornados; caso contrário, ele renderiza ou busca os dados no banco de dados.
- O App informa ao Client para armazenar os dados dessa chave.
- O Client executa um hash consistente na chave para determinar qual Node deve ser o proprietário dos dados.
- Finalmente, o Client armazena os dados no Node.
Analisando esse fluxo, há duas grandes implicações que se destacam:
- Toda solicitação de cache resulta em uma ida e volta a um Node, independentemente de um cache hit ou miss.
- Você não pode evitar a ida e volta a um Node armazenando o valor localmente, pois o Node remoto pode invalidar os dados a qualquer momento sem o conhecimento do App.
Embora nenhuma dessas implicações seja particularmente problemática para a maioria dos aplicativos, as idas e voltas adicionais ao banco de dados podem afetar os aplicativos de alto desempenho e baixa latência. No entanto, há mais uma implicação que pode não ser imediatamente óbvia: o thundering herd!
Resolvendo o problema do thundering herd: estouros de cache e alta concorrência
O problema do thundering herd é um estouro de solicitações que sobrecarregam o sistema. Às vezes chamado de estouro de cache, dogpiling ou efeito slashdot, esse problema ocorre quando instâncias concorrentes de um aplicativo tentam acessar dados simultaneamente.
Para essa discussão, nosso thundering herd é em resposta a um cache miss, o que significa que os dados foram removidos ou nunca foram colocados no cache. Por exemplo, em operação normal, um aplicativo permanece responsivo sob carga pesada, desde que os dados permaneçam em cache.
Quando o cache não tem os dados, esse thundering herd de trabalho concorrente pode sobrecarregar o sistema e resultar em congestionamento e possível colapso do sistema.
Para combater esse trabalho concorrente, você precisa de um sistema para sincronizar a busca ou renderização dos dados. Felizmente, existe uma biblioteca em Golang chamada GroupCache que pode ser usada para resolver o problema do thundering herd e melhorar as implicações do cache remoto que mencionamos.
O que é o GroupCache e como ele se compara a outras soluções de cache?
Existem muitas soluções de cache no mercado. O GroupCache do Golang é uma solução de código aberto que difere de ferramentas populares como BigCache, Redis e Memcache, pois se integra diretamente ao seu código como um In Code Distributed Cache (ICDC). Isso significa que cada instância do App é um Node no cache distribuído. A vantagem? Como membro integral do cache distribuído, cada instância do aplicativo conhece as estruturas de dados, não apenas como armazenar dados para o nó, mas também como buscar ou renderizar os dados se eles estiverem faltando.
Para entender por que isso é superior ao Redis ou Memcached, vamos analisar o fluxo de cache distribuído ao usar o GroupCache. Ao ler o fluxo, lembre-se de que o GroupCache é uma biblioteca usada pelo aplicativo que também escuta as solicitações recebidas de outras instâncias do aplicativo que estão usando o GroupCache.
- O App solicita ao GroupCache os dados por meio de uma chave.
- Em seguida, o GroupCache verifica o hot cache na memória em busca dos dados; se não houver, ele continua.
- O GroupCache realiza um hash consistente na chave para determinar qual instância do GroupCache tem os dados.
- Então, o GroupCache faz uma solicitação de rede à instância do GroupCache que possui os dados.
- O GroupCache retorna os dados se eles existirem na memória; caso contrário, solicita que o App renderize ou busque os dados.
- Finalmente, o GroupCache retorna os dados à instância do GroupCache que iniciou a solicitação.
A Etapa 5 é significativa no contexto de um evento de thundering herd, pois apenas uma das instâncias do GroupCache executará a renderização ou busca dos dados solicitados. Todas as outras instâncias do aplicativo – que também estão solicitando os dados da instância do GroupCache – serão bloqueadas até que a instância proprietária do aplicativo renderize ou busque os dados com sucesso. Isso cria um ponto de sincronização natural para acesso aos dados no sistema distribuído e anula o problema do thundering herd.
A Etapa 2 também é significativa, pois a capacidade de armazenar os dados localmente em cache na memória evita o custo de uma ida e volta à rede, proporcionando um enorme benefício de desempenho e pressão de rede reduzida. Como o GroupCache faz parte do aplicativo, evitamos a possibilidade de o GroupCache excluir os dados sem o conhecimento do aplicativo, já que qualquer evento de exclusão desse tipo é compartilhado por todas as instâncias do aplicativo usando o GroupCache.
Um benefício reconhecidamente menor — mas que aqueles de nós que gostam de simplicidade podem apreciar — é o da implantação. Embora não seja muito difícil implantar e proteger o Redis e o Memcached como entidades separadas do aplicativo, ter um único aplicativo para implantar significa uma coisa a menos para um operador lidar e manter atualizado e seguro.
Vale a pena mencionar de novo, pois é fácil de deixar passar. A capacidade da implementação do cache de renderizar ou buscar os dados em um banco de dados durante um cache miss, e a capacidade de depender de um hot cache na memória local é o que torna o GroupCache uma escolha superior entre os caches distribuídos. Nenhum cache distribuído externo ao seu aplicativo pode fornecer esses benefícios.
GroupCache como uma ferramenta de sincronização
Como o GroupCache fornece ótimas semânticas de sincronização, descobrimos que ele é uma alternativa superior a bloqueios distribuídos ou no nível do banco de dados ao criar e gerenciar recursos exclusivos.
Como exemplo, nosso mecanismo de análises interno lê milhares de eventos e adiciona tags de forma dinâmica com estatísticas atribuídas. Como temos muitas instâncias do mecanismo em execução, cada nova tag vista deve ser tratada como uma possível nova tag. Normalmente, isso geraria um fluxo constante de solicitações upsert para nosso banco de dados. Usando o GroupCache, cada instância pode consultar o cache com a chave account:tag.
Se a tag já existe, ela é retornada com os dados mais recentes dela. No entanto, se a tag não existir, o GroupCache retransmite a solicitação para a instância proprietária e cria a tag. Dessa forma, apenas um único upsert é enviado ao banco de dados quando o sistema encontra uma nova tag.
Da mesma forma, usamos o GroupCache para contar contadores exclusivos em que o sistema deve registrar apenas uma única instância de um contador. Como estamos usando o GroupCache, evitamos completamente usar bloqueios distribuídos e problemas de deadlock. Isso é especialmente útil ao usar um banco de dados nosql com pouca ou nenhuma semântica de bloqueio ou sincronização própria.
Usando o GroupCache
A Mailgun executa uma versão modificada do código de Brad Fitzpatrick (patrickmn) original da biblioteca do GroupCache no github.com.
Mudanças notáveis na biblioteca são:
- Suporte para remoção de chaves explícitas de um grupo.
Remove() - Suporte para valores expirados.
SetBytes(),SetProto()eSetString()agora aceitam umtime.Time{}opcional, que representa um momento no futuro quando o valor irá expirar - Suporte para o padrão Golang
context.Context - Sempre preenche o hotcache
- Para usar o GroupCache, você cria um Pool de instâncias com as quais cada instância do GroupCache falará e, em seguida, cria vários Groups de cache independentes que usam o mesmo Pool de instâncias.
- Rastreie os peers em nosso cluster e adicione nossa instância ao pool `
http://localhost:8080` pool := groupcache.NewHTTPPoolOpts("http://localhost:8080", &groupcache.HTTPPoolOptions{}) - Adicione mais peers
pool.Set("http://peer1:8080", "http://peer2:8080") - Crie um novo group cache com um tamanho máximo de cache de 3 MB group: =
groupcache.NewGroup("users", 3000000, groupcache.GetterFunc( func(ctx context.Context, id string, dest groupcache.Sink) error { // Retorna uma struct protobuf `User` if user, err := fetchUserFromMongo(ctx, id); err != nil { return err } - Defina o usuário no groupcache para expirar após 5 minutos
if err := dest.SetProto(&user, time.Now().Add(time.Minute*5)); err != nil { return err } return nil }, )) - var user User
- Busque a definição no cache do grupo ctx,
cancel := context.WithTimeout(context.Background(), time.Second*10) if err := group.Get(ctx, “key”, groupcache.ProtoSink(&user)); err != nil { return nil, err } cancel()
Como implementar com HTTP/2 e TLS
O GroupCache usa HTTP para se comunicar entre as instâncias no cluster. Se o seu aplicativo também usa HTTP, o GroupCache pode usar a mesma porta HTTP do seu aplicativo. Basta adicionar o pool como um handler com seu próprio caminho.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
Se o seu aplicativo tiver o TLS configurado, o GroupCache se beneficiará da mesma configuração de TLS que o seu aplicativo usa, tendo também a opção de ativar o HTTP/2, o que melhora ainda mais o desempenho das solicitações do GroupCache. Você também pode usar HTTP/2 sem TLS por meio do H2C.
Atualização de remoção de chaves da Mailgun
Uma diferença notável na versão da Mailgun do GroupCache é a capacidade de excluir as chaves de forma explícita do cache. Quando uma instância deseja remover uma chave, primeiro ela exclui a chave da instância proprietária e, em seguida, envia as solicitações de exclusão para todas as outras instâncias no pool. Isso garante que quaisquer solicitações futuras de instâncias não proprietárias no pool para a proprietária resultarão em uma nova busca ou renderização dos dados (ou em um erro, se os dados não estiverem mais disponíveis).
Como em qualquer sistema distribuído, há a possibilidade de que uma instância não esteja disponível ou a conectividade tenha sido perdida quando a solicitação de remoção foi feita. Nesse cenário, group.Remove() retornará um erro indicando que algumas instâncias não foram contatadas e a natureza do erro.
Dependendo do caso de uso, o usuário então tem a opção de tentar novamente a chamada de group.Remove() ou ignorar o erro. Para alguns sistemas, ignorar o erro pode ser aceitável, especialmente se você estiver usando o recurso de valores expirados.
O recurso de valores expirados permite que você forneça um tempo de expiração opcional, time.Time, que especifica um momento futuro em que os dados devem expirar.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
No cenário acima, no qual perdemos temporariamente a conectividade com uma instância, dizemos que o pool de instâncias está em um estado inconsistente. No entanto, quando usado em conjunto com o recurso de expiração de dados, sabemos que o sistema acabará se tornando consistente de novo quando os dados nas instâncias desconectadas expirarem.
Existem outras soluções muito mais complexas para resolver esse problema, mas descobrimos na prática que as soluções eventualmente consistentes são a maneira mais simples e menos propensa a erros de lidar com interrupções de rede.
Melhorias de desempenho da Mailgun com o GroupCache
Na Mailgun, nosso primeiro uso de produção do GroupCache foi em nosso serviço de limite de taxa (ratelimit). Como esse serviço deve operar em um nível muito alto de desempenho/baixa latência, os sistemas de cache tradicionais eram uma preocupação; quanto mais idas e voltas introduzíamos no pipeline de solicitações, mais oportunidades tínhamos de introduzir latência adicional.
Os gráficos a seguir mostram o número total de cache hits e, desses hits, o número total de hits que resultaram em uma ida e volta para outra instância do GroupCache. Isso demonstra exatamente o quanto nos beneficiamos do hot cache na memória local em comparação com uma chamada de ida e volta em cada solicitação.
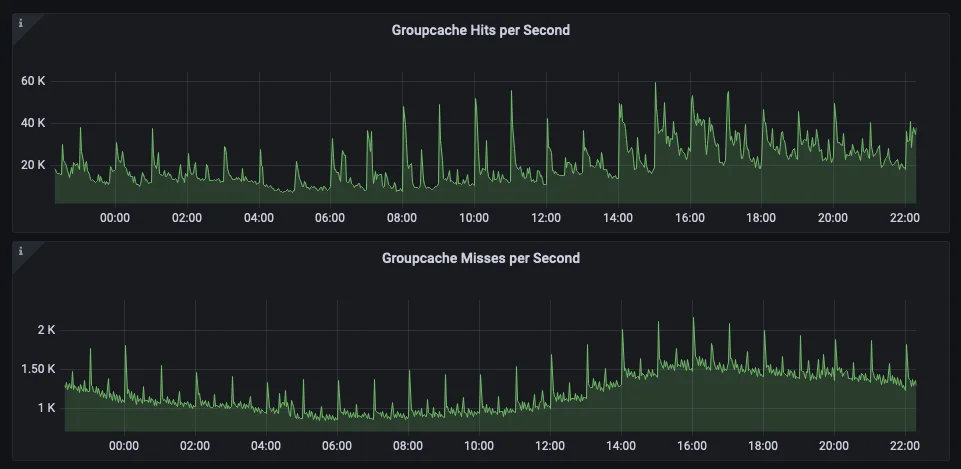
Você pode ver no próximo gráfico exatamente o quanto o MongoDB e nosso aplicativo se beneficiam de evitar o thundering herd à medida que novas chaves são recuperadas do sistema.
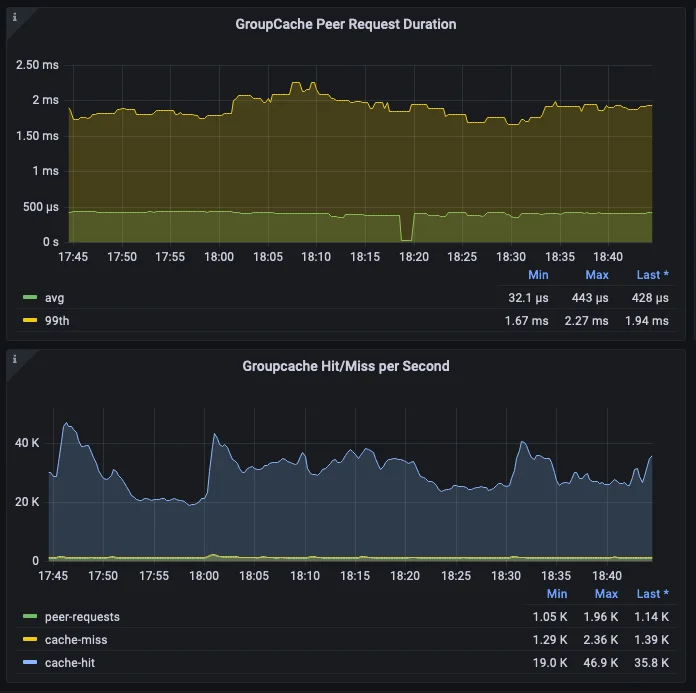
As chamadas reais para o MongoDB são uma pequena fração do total de solicitações que foram realmente feitas ao serviço. Isso, além da velocidade do Gubernator, é o que permite que nosso serviço de limite de taxa tenha um desempenho de baixa latência, mesmo durante uma alta carga.
Aqui você pode ver as métricas de tempo de resposta do serviço de limite de taxa. Lembre-se de que, para cada solicitação, fazemos uma chamada ao Gubernator e uma solicitação ao GroupCache, o que pode ou não resultar em uma solicitação HTTP do GroupCache ou solicitação ao MongoDB. (Este gráfico mostra as respostas mais lentas, e não a média).
Conclusão: cache distribuído de forma fácil
O GroupCache melhorou o desempenho de nossos serviços na Mailgun. Ele torna o cache distribuído e a sincronização simples e fáceis de implantar. Minha esperança é que outras pessoas descubram os mesmos benefícios que estamos aproveitando e inspirem outras implementações ICDC em outras linguagens.
Isso foi útil? Na Mailgun, estamos sempre avaliando e implementando novas formas de ajudar a escalar nossos serviços e melhorar nosso desempenho. Isso nem sempre é fácil. Adoraríamos que você aprendesse com nossas experiências. Assine nossa newsletter para ver mais conteúdos como este.



