IT & Engineering
Evitar los puntos ciegos de los datos faltantes con el aprendizaje automático

Tienes un proyecto y quieres aplicarle el aprendizaje automático. Empiezas por algo sencillo: añades una característica, recopilas datos y creas un modelo. Añades otra característica muy útil, pero solo está representada en la mitad de tus puntos de datos. Quieres actuar con inteligencia y utilizar todos los datos de los que dispones (incluidos los que tienen valores faltantes), pero ¿cómo lo haces?
Como profesional del desarrollo, cuando me encuentro con un problema, intento buscar en Google una solución que funcione. No tiene por qué ser 100 % exacta a nivel matemático, pero debe tener sentido. Mi búsqueda me llevó a Valores faltantes en el análisis de datos en Stack Overflow.
Las soluciones van desde algo tan sencillo como rellenar los huecos con la media o los valores más comunes hasta predecir primero los valores faltantes. En mi caso, introduje una característica binaria distinta que indicaba si el valor faltaba.
Siempre que dudaba de una solución, recurría a las matemáticas. Las matemáticas son muy precisas a la hora de determinar cuándo funciona o no algo, y cuáles son las condiciones y los compromisos. También hay mucho escrito sobre la imputación de datos—¡hay gente que se doctora investigando este problema!
Pero entonces me topé con un enfoque distinto (un poco por accidente). En lugar de intentar imputar los datos, puedes utilizar algoritmos que no requieran dicha imputación. Simplemente funcionan sin más configuración, haya valores faltantes o no. Suena a cuento de hadas, ¿verdad?
Cuando estaba investigando, nadie me mencionó nada parecido. Hablé con personas con doctorado y profesionales del sector, y lo único que me decían era imputación de datos.
Entonces me topé con un Coursera curso que detallaba de forma exhaustiva los algoritmos de árboles de decisión. El funcionamiento de los árboles de decisión consiste en empezar por la raíz e ir a la izquierda o a la derecha con una determinada probabilidad. Aquí tienes un árbol de decisión para la supervivencia del pasaje del Titanic:
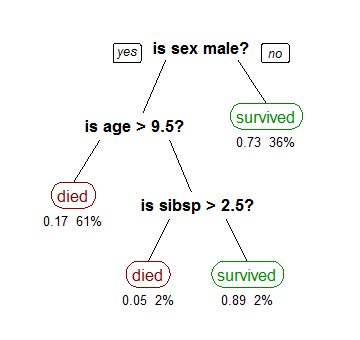
La forma en que los algoritmos de árboles de decisión como C4.5, C5.0 y CART tienen en cuenta los valores faltantes es la siguiente:
Imagina que se desconoce el valor de una característica, lo que significa que no puedes comprobar la condición y no tienes forma de saber qué rama seguir. Un enfoque habitual es utilizar el valor más común. Esto es, en esencia, el equivalente a elegir la rama más probable.
Lo que hacen los algoritmos de árbol es considerar ambas ramas con pesos iguales a la probabilidad de dichas ramas.
Aprender con ejemplos
Veamos otro ejemplo. Aquí tienes un árbol de probabilidades de una sencilla prueba GMAT que asume un tamaño de muestra de 100 estudiantes en una clase de la universidad:
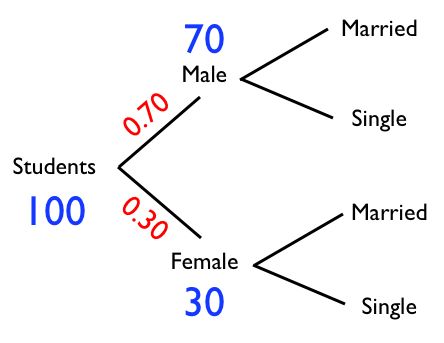
Si eres hombre, la probabilidad de no tener pareja es de:
50 / 70 = 71 %
Si eres mujer, la probabilidad de no tener pareja es de:
20 / 30 = 67 %
Si se desconoce el género, la probabilidad de no tener pareja es de:
(0,7 71 %) + (0,3 67 %) = 70 %
0,7 porque 70 de cada 100 estudiantes son hombres. 0,3 porque 30 de cada 100 estudiantes son mujeres.
Al desglosar la probabilidad general en probabilidades de rama con pesos, consideramos todas las posibilidades. En general, creo que esta es una forma mucho mejor de superar la falta de datos y de enseñar a nuestro modelo a generalizar valores futuros.
Por desgracia, las bibliotecas que implementan estos algoritmos rara vez ofrecen asistencia para los valores faltantes. Por ejemplo, scikit-learn biblioteca —la de aprendizaje automático de facto para Python— exige que todos los valores sean numéricos.
Pero aún hay buenas bibliotecas como Orange que sí ofrecen asistencia para valores faltantes. Y resulta que esta limitación se puede superar.
El poder de la imputación de datos
Al principio, esta falta de asistencia para los valores faltantes me enojó y me hizo gracia a la vez. En serio, ¿por qué el mismo algoritmo cuya ventaja es una asistencia integrada para los valores faltantes no se puede utilizar sin la imputación de datos? ¡Venga ya!
import randomrndef impute_gender():rnreturn random.choice(["Male"] * 70 + ["Female"] * 30)
Y lo bueno de la imputación de datos es que se puede aplicar a cualquier algoritmo de aprendizaje automático, no solo a los árboles de decisión.
¡Me dejó alucinando! Un obstáculo se convirtió en una solución, ¡todo gracias a la misma idea sencilla!
Lecciones aprendidas
No importa en qué campo trabajes o lo bien que se te dé recopilar datos, los valores faltantes van a aparecer. Tal vez estés trabajando en una aplicación de calificación de créditos. O tal vez intentes predecir cuándo es más probable que los destinatarios de los emails abran sus mensajes, para poder programarlos en consecuencia. Las tareas reales tienden a tener lagunas.
Hay muchísimas formas de enfocar un problema como el de los valores faltantes y, dependiendo del caso, las respuestas pueden ser distintas. Pero en el fondo de una solución compleja suele haber una idea sencilla.
Enlaces útiles
- Artículo de Wikipedia sobre la imputación de datos
- Algunas formas habituales de introducir valores faltantes
- Artículo de Quora sobre cómo los árboles de decisión manejan los valores faltantes
- Orange —biblioteca de aprendizaje automático muy utilizada en Python que ofrece asistencia para valores faltantes
- Prueba de tu modelo para soportar tareas del mundo real
¡Feliz aprendizaje automático! ¿Cómo lidias tú con los valores faltantes? Cuéntamelo abajo en los comentarios…