Product
Liberamos el código de nuestra biblioteca de análisis de firmas de email

Allá por 2011, varios clientes nos pidieron una API de análisis de mensajes de alto nivel que pudieran usar para eliminar firmas y citas de un email como el que ves a continuación:
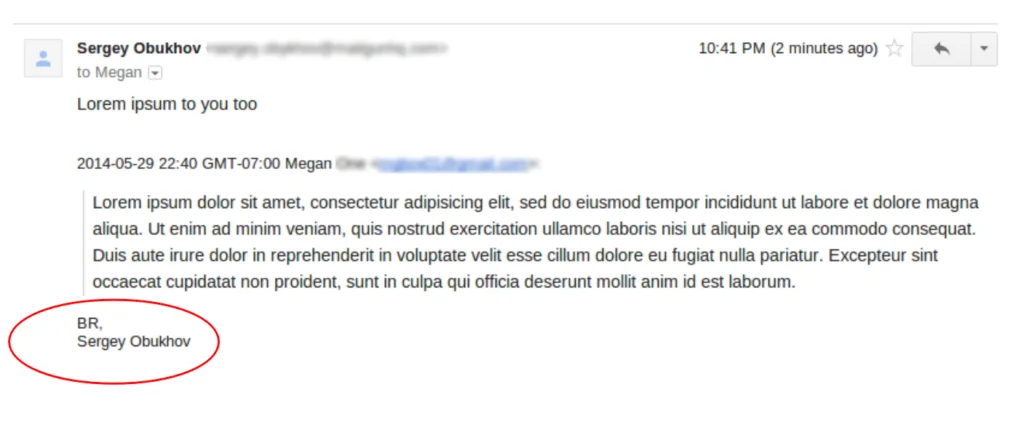
El problema
Aunque para los humanos es sencillo, en realidad es una tarea bastante compleja para las máquinas. Uno de los motivos principales es que no existe un formato estándar para un mensaje de email. Los distintos clientes de email redactan las respuestas de diferentes maneras e, incluso dentro del mismo cliente, el remitente puede cambiar el formato como prefiera. Por ejemplo, los usuarios pueden colocar su respuesta después de citar el mensaje original (respuesta inferior):
El miércoles a las 10:01, Danny escribió:
> Por cierto, ¿qué sistemas se actualizarán? Tuve algunos problemas
> de red después de la actualización de la semana pasada.  ¿Tendré que reiniciar?
No, no tendrás que reiniciar.
antes del mensaje original citado (respuesta superior):
No, no tendrás que reiniciar.

-------- Mensaje original --------

De: Danny

Enviado: martes, 16 de octubre de 2007 10:01

Para: Jim

Asunto: RE: Trabajo

Por cierto, ¿qué sistemas se actualizarán? Tuve algunos problemas

de red después de la actualización de la semana pasada.  ¿Tendré que reiniciar?
o incluso intercalar la respuesta:
> ¿Puedes presentar tu informe una hora más tarde?
Sí, puedo. El resumen se enviará antes de las 17:00.
Jim
El miércoles a las 10:01, Danny escribió:
>> 14:00: Presentación del informe
> Jim, tengo una reunión a esa hora. ¿Puedes presentar tu informe una hora más tarde?
De hecho, hay tantas formas diferentes de responder que incluso existe un artículo de la Wikipedia al respecto. Todo esto hace que analizar el cuerpo de un email sea una tarea compleja.
Incluso con el aprendizaje automático, tuvimos que ajustar cosas constantemente. El formato de los emails cambia de forma constante, los clientes de email de los teléfonos introducen firmas nuevas como “Enviado desde tu teléfono XXX”, se descubren casos atípicos nuevos, etc.
Aquí tienes un ejemplo sencillo. En su momento, todas las firmas de email se separaban con guiones:
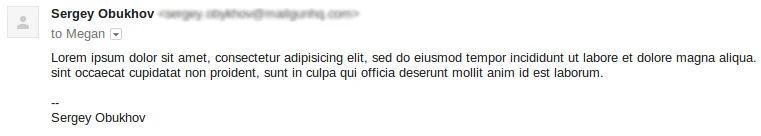
Así que lo primero que se te ocurre es escribir una expresión regular para detectar los guiones como un separador y extraer las líneas posteriores como la firma:
>>> signature = regex.match("^[s]*--*[s]*[a-z .]*$).*", message)
Pero luego recibes un email como este:
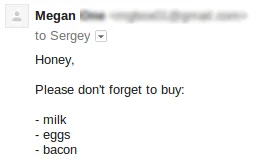
Y tu analizador elimina la parte más importante del email. Es un ejemplo muy sencillo y podrías solucionarlo fácilmente. Pero, en la vida real, las cosas se complican y enrevesan mucho más.
Nuestra solución
Investigamos mucho, observamos todas las variaciones de email que pasan por Mailgun y dimos con una solución basada en varias técnicas de aprendizaje automático. La solución lleva varios años en producción y ha sido sometida a correcciones de errores y mejoras. En general, hemos recibido comentarios positivos de los clientes, aunque, como es natural, el equipo de desarrollo suele señalar dónde se puede mejorar.
Así que ahora tienes la oportunidad de ayudar a mejorar la solución. Debido al panorama del email, distribuido y en constante cambio, hemos decidido abordar este problema con una solución distribuida: ¡hemos liberado nuestra biblioteca en código abierto para que podamos trastear con ella en equipo!
Hemos llamado a nuestra nueva biblioteca talon por un robot multiusos diseñado para realizar misiones que van desde el reconocimiento hasta el combate y para operar en diversos entornos hostiles.
Por si quieres empezar a probarla ya mismo, hemos preparado una sencilla aplicación de demostración y una guía de inicio rápido para ti. Si no, sigue leyendo para ver un resumen más general, los enfoques que adoptamos y los resultados de las evaluaciones.
Así es como se ven los flujos de trabajo más comunes:
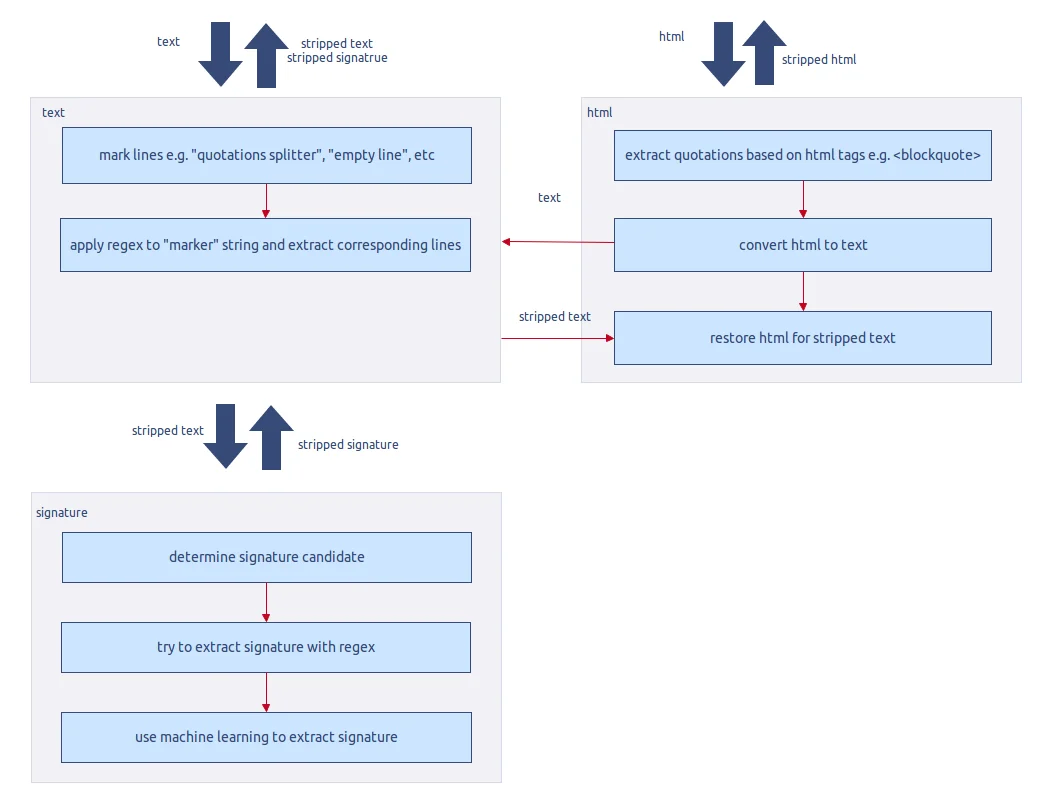
En la actualidad, utilizamos el aprendizaje automático solo para clasificar las líneas de firma. El resto de la biblioteca son varias heurísticas y comprobaciones de coherencia que ideamos al trabajar en las incidencias de asistencia y al analizar los patrones y tendencias del formato de los mensajes.
La parte de aprendizaje automático de la biblioteca se inspira en los siguientes artículos de investigación:
- http://www.cs.cmu.edu/~vitor/papers/sigFilePaper_finalversion.pdf
- http://www.cs.cornell.edu/people/tj/publications/joachims_01a.pdf
Para clasificar las líneas de firma utilizamos SVM con núcleo lineal. Para evaluar nuestros clasificadores, usamos la validación cruzada de cinco iteraciones:
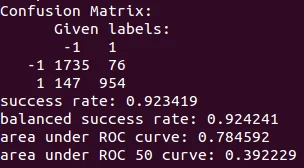
El conjunto de datos constaba de 2912 líneas de email. De las 1030 líneas de firma, 954 se clasificaron de forma correcta. De las 1882 líneas sin firma, 147 se confundieron con firmas. En general, esto nos da una tasa de éxito del 92 % y un 78 % de área bajo la curva ROC. Lo que podría considerarse como excelente y aceptable, respectivamente.
Al modificar la biblioteca para liberarla en código abierto, intentamos ofrecer una estructura robusta que, al mismo tiempo, fuera fácil de ampliar. Por experiencia, las partes que requieren más atención son las expresiones regulares para las citas o los separadores de firmas y la extracción de citas HTML mediante etiquetas HTML. Sin embargo, te animamos a contribuir a cualquier parte de la biblioteca que te interese.
Esperamos que la biblioteca te resulte útil y te haga la vida más fácil.
¡Feliz envío!