IT & Engineering
Maschinelles Lernen für alltägliche Aufgaben

Oft wird angenommen, dass maschinelles Lernen für alltägliche Entwicklungsaufgaben zu kompliziert ist. Wir assoziieren es oft mit Dingen wie Big Data, Data Mining, Data Science und künstlicher Intelligenz. Manchmal fühlt es sich etwa so an:
Maschinelles Lernen ist schwer
Ich hatte schon immer das Gefühl, dass wir vom maschinellen Lernen für einfache Aufgaben, die wir regelmäßig erledigen, profitieren.
Ein Praxisbeispiel
Bei Mailgun arbeiten wir mit E-Mails und als Teil unseres Angebots parsen wir HTML-Zitate. Dadurch können Nutzer die neueste Antwort anstelle der gesamten Konversation abrufen, die als Teil unserer Webhook-Antwort zurückgegeben wird. Erfahren Sie mehr darüber, wie wir eingehende Nachrichten verarbeiten, in unserem Dokumentation.
Für alle, die es nicht wissen: So sieht das Parsen von HTML aus dem öffentlichen Internet aus:
Parsen von HTML aus dem öffentlichen Internet
Es ist unübersichtlich und manchmal bleiben Prozesse hängen.
Ein Wechsel der Parsing-Bibliothek ist hilfreich, löst das Problem jedoch nicht vollständig, da jede Bibliothek ihre Grenzen hat. Sie müssen das Parsen auf ein vernünftiges Maß beschränken.
Cluster-Analyse als Rettung
Aber was sollten die Kriterien und der Schwellenwert sein? Sollten wir nach HTML-Länge oder Tag-Anzahl begrenzen? Vielleicht beides? Vielleicht durch etwas anderes? Das Ziel ist offensichtlich, so viele Nachrichten wie möglich zu verarbeiten, ohne sich selbst ins Bein zu schießen. Der Weg dorthin ist jedoch nicht ganz klar.
Genau hier sind Cluster-Analyse und statistische Klassifizierung nützlich. Für die Untersuchung nutzte ich R, aber abhängig von Ihrer Aufgabe und Ihren persönlichen Einstellungen verwenden Sie vielleicht etwas anderes – scikit-learn, Weka, MOA usw.
Datensatz sammeln
Zuerst haben wir HTML-Länge, Tag-Anzahl und Verarbeitungszeit der Nachricht protokolliert und in einer CSV-Datei gespeichert:
htmllen,tagscount,took rn2893762,85527,34.300139904 rn31378,518,0.0368919372559 rn19105,413,0.0545339584351 rn...
Die überwiegende Mehrheit der Nachrichten wird in Sekundenbruchteilen verarbeitet. Deshalb mussten wir beim Sammeln des Datensatzes sicherstellen, dass wir genügend „langsame“ Nachrichten haben.
Letztendlich hatten wir zwei CSV-Dateien, die an verschiedenen Tagen gesammelt wurden. Eine hatte 13.831 Zeilen und war für die Analyse und das Modell-Training reserviert (der Trainingsdatensatz). Eine andere hatte 12.149 Zeilen und war für die Modell-Validierung reserviert (der Validierungsdatensatz).
Generell benötigen Sie mindestens zwei Datensätze – einen für das Training und einen für die Validierung. Andernfalls könnte das Problem des Overfittings auftreten, bei dem Ihr Modell zwar gut an die Trainingsdaten angepasst ist, in der Praxis jedoch versagt.
Anzahl der Cluster bestimmen
Um die Daten zu visualisieren und nach Mustern zu suchen, K-Means-Clustering wurde zuerst ausprobiert:
messages <- read.csv(file="messages080816.csv", sep=",", head=TRUE) rn mydata <- matrix(messages$took, ncol=1) rnrn ## Determine the number of clusters rn wss <- (nrow(mydata)-1)*sum(apply(mydata,2,var)) rn for (i in 2:15) wss[i] <- sum(kmeans(mydata, rn centers=i)$withinss) rn plot(1:15, wss, type="b", xlab="Number of Clusters", rn ylab="Within groups sum of squares")
Wie Sie sehen, gibt es bis zu 4 Clustern eine deutliche Leistungssteigerung. Danach gibt es keinen wirklichen Schub mehr.
Clustering
Der nächste Schritt bestand darin, herauszufinden, wie sich die Datenpunkte auf die Cluster verteilen:
## K-Means Clustering with 4 clustersrn fit <- kmeans(mydata, 4) rnrn ## Cluster Plot against 1st 2 principal components rn ## vary parameters for most readable graph rn library(cluster) rn clusplot(mydata, fit$cluster, color=TRUE,rn shade=TRUE, labels=2, lines=0)
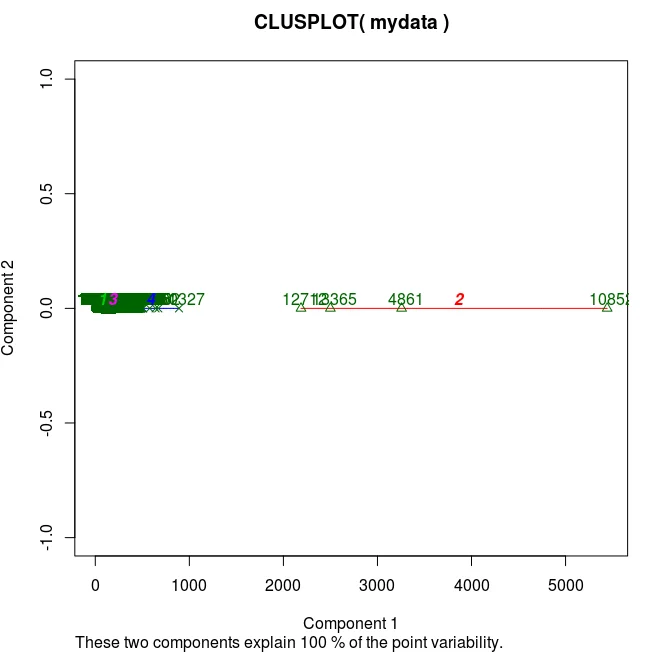
Das Problem lässt sich bereits ein wenig erahnen: Die Cluster bilden sich durch das Abtrennen der weit entfernten Datenpunkte, während das Intervall, an dem wir interessiert sind (1–20 Sek.), genau in der Mitte liegt. Das Problem besteht auch bei Erhöhung der Cluster-Anzahl weiter.
Darüber hinaus gibt es eine deutliche Überschneidung zwischen den Clustern in dem Intervall:
## get clusters mean, min, max rn mean <- aggregate(mydata,by=list(fit$cluster),FUN=mean) rn min <- aggregate(mydata,by=list(fit$cluster),FUN=min) rn max <- aggregate(mydata,by=list(fit$cluster),FUN=max)
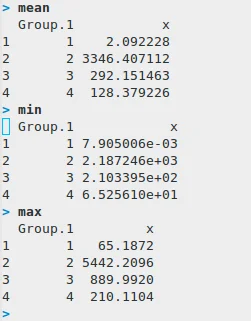
Vergleichen Sie Cluster Nummer 1 und 4. Das Problem besteht auch bei Erhöhung der Cluster-Anzahl weiter.
An diesem Punkt entschieden wir uns für einen anderen Ansatz und betrachteten die Perzentile der Verarbeitungszeit der Nachricht:
percentiles <- quantile(messages$took, seq(0.5, 0.99, 0.01)) rn plot(seq(0.5, 0.99, 0.01), percentile)
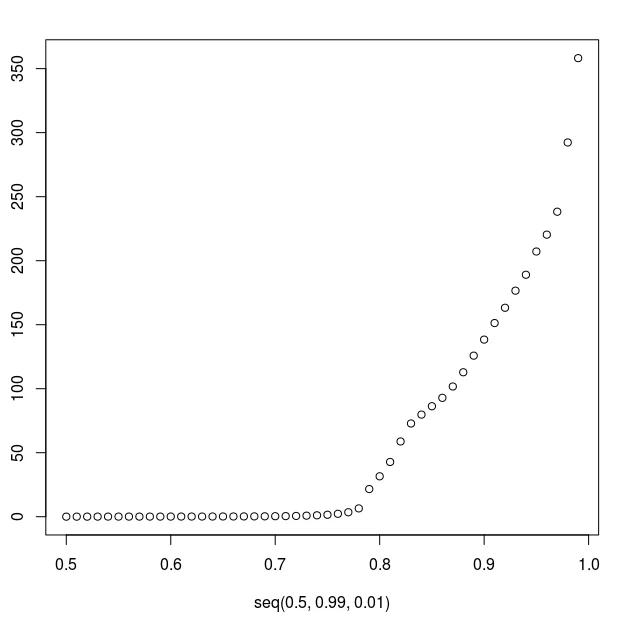
Wie Sie sehen, steigt die Verarbeitungszeit nach dem 78. Perzentil schnell an. Hier war unser erster Schwellenwert – das 78. Perzentil, das 6,5 Sekunden entsprach.
Alle Datenpunkte, die weniger als 6,5 Sek. dauerten, wurden als „schnell“ und andere als „langsam“ markiert.
Klassifizierung
Für die Klassifizierung probierten wir SVM (Support Vector Machines), Random Forests genannt, und CART(Classification And Regression Tree).
CART lieferte für diese Aufgabe etwas bessere Ergebnisse. Der Hauptvorteil besteht jedoch darin, dass es einen Entscheidungsbaum bietet, der leicht zu verstehen, zu erklären und zu implementieren ist, im Gegensatz zu SVM oder Random Forests, die wie eine Black-Box funktionieren und den Einsatz umfangreicher ML-Bibliotheken in der Produktion erfordern.
So klassifizieren Sie mit CART:
x <- subset(messages, select=-took) rnlibrary(rpart) rnrn# grow tree rnfit <- rpart(x$cls ~., method="class", data=x) rnrn## display the results rnprintcp(fit)rnrn# detailed summary of splits rnsummary(fit) rnrn# plot tree rnplot(fit, uniform=TRUE, rn main="Classification Tree for message processing time") rntext(fit, use.n=TRUE, all=TRUE, cex=.8)
Hier ist der Entscheidungsbaum:
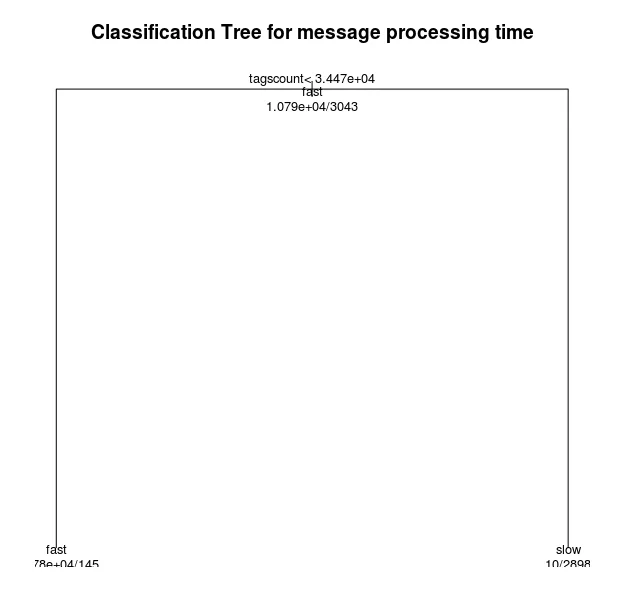
Und so sieht die Implementierung aus:
def html_too_big(s): rn return s.count('<') > _MAX_TAGS_COUNT
Ist das nicht wunderbar? Die gesamte Komplexität der Untersuchung in einer einzigen Zeile.
Validierung
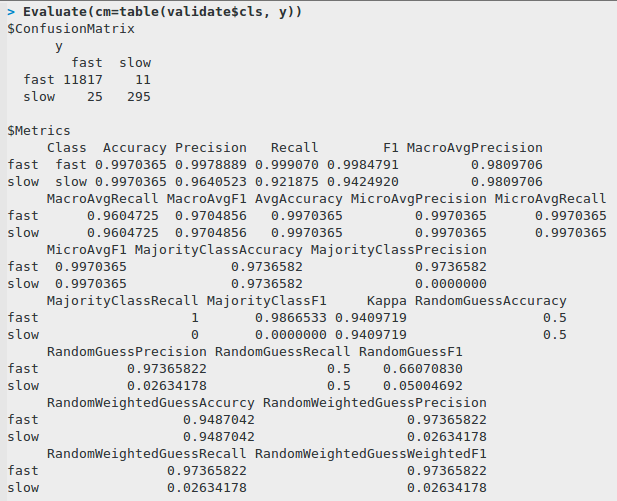
Zur Auswertung nahmen wir den Validierungsdatensatz und versuchten, die Klassifizierung mit unserem Modell vorherzusagen:
validate <- read.csv(file="messages080916.csv", sep=",", head=TRUE) rn validate <- subset(validate, select=-took) rn xv <- subset(validate, select=-cls) rn y <- predict(fit, xv, type="class") rn table(validate$cls, y)
Hier ist die Konfusionsmatrix und einige gängige Klassifizierungsmetriken:
Erkenntnisse
Maschinelles Lernen ist nicht nur für Data Scientists. Sogar bei einfachen Entscheidungen, die durch ML unterstützt werden, profitieren Sie. Machen Sie sich mit Ihren Daten vertraut. Verlassen Sie sich nicht blind auf wissenschaftliche Algorithmen und Modelle.
Nützliche Links
- Hervorragende Erklärung eines Train-Validate-Test -Workflows
- Kurzanleitung zu CART und Random Forests in R
- Kurzanleitung zu Cluster-Analyse in R
- Anleitung zum Plotten in R
- Die Begriffe gängige Klassifizierungsmetriken
- Precision und Recall einfach erklärt
Viel Spaß beim maschinellen Lernen und Data Mining.