IT & Engineering
Machine learning para tarefas do dia a dia

Costuma-se pensar que o machine learning é complexo demais para as tarefas de desenvolvimento do dia a dia. É comum associá-lo a conceitos como big data, mineração de dados, ciência de dados e inteligência artificial. Às vezes, a sensação é mais ou menos assim:
Machine learning é difícil
Sempre achei que podemos nos beneficiar do uso do machine learning em tarefas simples que realizamos regularmente.
Exemplo da vida real
No Mailgun, trabalhamos com e-mail e, como parte da nossa oferta, fazemos a análise de citações em HTML. Isso permite capturar a última resposta em vez de toda a conversa, que é retornada como parte da resposta do nosso webhook. Você pode ler mais sobre como lidamos com o processamento de mensagens de entrada em nosso documentação.
Para quem não sabe, é assim que funciona a análise de HTML da internet pública:
Análise de HTML da internet pública
É confuso e, às vezes, os processos ficam travados.
Mudar a biblioteca de análise pode ajudar, mas não resolverá o problema completamente, pois toda biblioteca tem suas limitações. É necessário restringir a análise a algo razoável.
Análise de clusters como solução
Mas quais devem ser os critérios e o limite? Devemos limitar pelo tamanho do HTML ou pela contagem de tags? Talvez ambos? Talvez por outra coisa? O objetivo, obviamente, é processar o máximo de mensagens possível sem dar um tiro no próprio pé, mas o caminho não é tão óbvio.
É aí que a análise de clusters e a classificação estatística se tornam úteis. Para a pesquisa, usei  , mas, dependendo da sua tarefa e das preferências pessoais, você pode usar outra coisa – scikit-learn, Weka, MOA, etc.
Coletar um conjunto de dados
Primeiro, registramos o tamanho do HTML, a contagem de tags, o tempo de processamento da mensagem e os colocamos em um arquivo CSV:
htmllen,tagscount,took rn2893762,85527,34.300139904 rn31378,518,0.0368919372559 rn19105,413,0.0545339584351 rn...
A grande maioria das mensagens leva frações de segundo para ser processada. Portanto, ao coletar o conjunto de dados, precisávamos garantir que teríamos mensagens “lentas” suficientes.
Acabamos com dois arquivos CSV, coletados em dias diferentes. Um tinha 13.831 linhas e foi reservado para análise e treinamento de modelo (o conjunto de dados de treino). Outro tinha 12.149 linhas e foi reservado para a validação do modelo (o conjunto de dados de validação).
Geralmente, você quer ter pelo menos dois conjuntos de dados – um para treino e outro para validação. Caso contrário, você pode enfrentar o problema de overfitting, quando o modelo se ajusta bem aos dados de treino, mas falha no mundo real.
Determinar o número de clusters
Para visualizar os dados e procurar padrões, a clusterização k-means foi a primeira tentativa:
messages <- read.csv(file="messages080816.csv", sep=",", head=TRUE) rn mydata <- matrix(messages$took, ncol=1) rnrn ## Determine the number of clusters rn wss <- (nrow(mydata)-1)*sum(apply(mydata,2,var)) rn for (i in 2:15) wss[i] <- sum(kmeans(mydata, rn centers=i)$withinss) rn plot(1:15, wss, type="b", xlab="Number of Clusters", rn ylab="Within groups sum of squares")
Como você pode ver, há uma melhoria significativa no desempenho com até 4 clusters. Depois disso, não há um ganho real.
Clusterização
A próxima etapa foi descobrir como os pontos de dados são distribuídos entre os clusters:
## K-Means Clustering with 4 clustersrn fit <- kmeans(mydata, 4) rnrn ## Cluster Plot against 1st 2 principal components rn ## vary parameters for most readable graph rn library(cluster) rn clusplot(mydata, fit$cluster, color=TRUE,rn shade=TRUE, labels=2, lines=0)
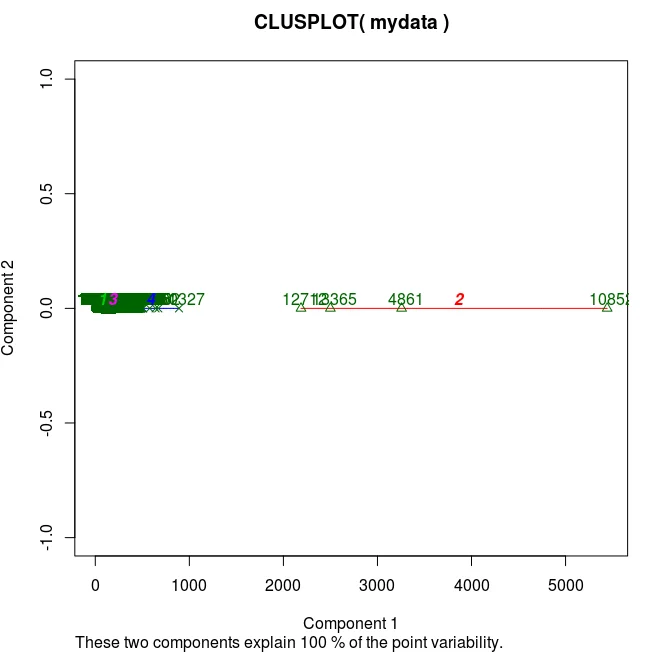
E você já pode antecipar um pouco o problema: os clusters se formam isolando os pontos de dados que estão distantes, enquanto o intervalo que nos interessa (1 a 20 s) fica bem no meio. O problema persiste com o aumento do número de clusters.
Além disso, há uma sobreposição significativa entre os clusters no intervalo:
## get clusters mean, min, max rn mean <- aggregate(mydata,by=list(fit$cluster),FUN=mean) rn min <- aggregate(mydata,by=list(fit$cluster),FUN=min) rn max <- aggregate(mydata,by=list(fit$cluster),FUN=max)
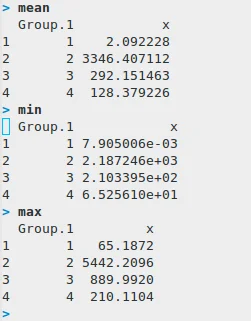
Compare os clusters 1 e 4. O problema persiste com o aumento do número de clusters.
Nesse ponto, decidimos tentar uma abordagem diferente e observar os percentis do tempo de processamento das mensagens:
percentiles <- quantile(messages$took, seq(0.5, 0.99, 0.01)) rn plot(seq(0.5, 0.99, 0.01), percentile)
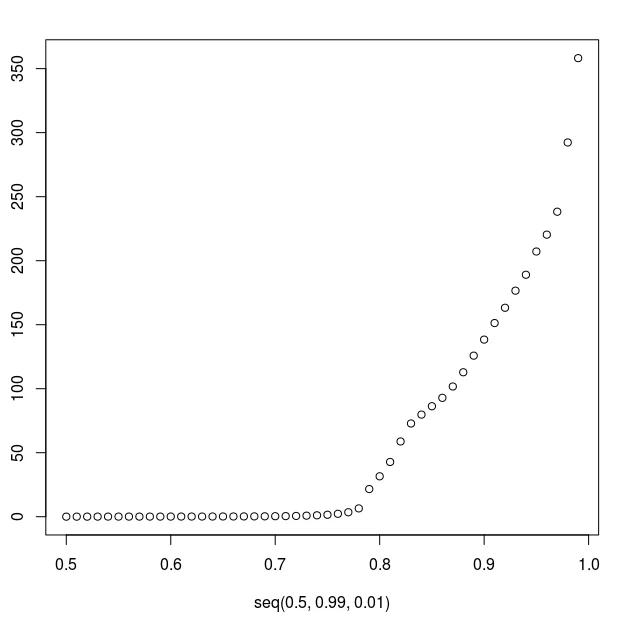
Como você pode ver, após o percentil 78, o tempo de processamento sobe rapidamente. Aqui estava nosso primeiro limite: o percentil 78, que correspondia a 6,5 segundos.
Todos os pontos de dados que levaram menos de 6,5 s foram marcados como “rápidos” e os demais como “lentos”.
Classificação
Para a classificação, testamos o SVM (Máquinas de Vetores de Suporte), Random Forests e CART(Árvore de Classificação e Regressão).
O CART apresentou resultados ligeiramente melhores para essa tarefa, mas sua principal vantagem é que ele gera uma árvore de decisão fácil de entender, explicar e implementar, em comparação com o SVM ou as Random Forests, que funcionam como uma caixa-preta e exigem o uso de bibliotecas pesadas de ML na produção.
Veja como você classifica usando o CART:
x <- subset(messages, select=-took) rnlibrary(rpart) rnrn# grow tree rnfit <- rpart(x$cls ~., method="class", data=x) rnrn## display the results rnprintcp(fit)rnrn# detailed summary of splits rnsummary(fit) rnrn# plot tree rnplot(fit, uniform=TRUE, rn main="Classification Tree for message processing time") rntext(fit, use.n=TRUE, all=TRUE, cex=.8)
Aqui está a árvore de decisão:
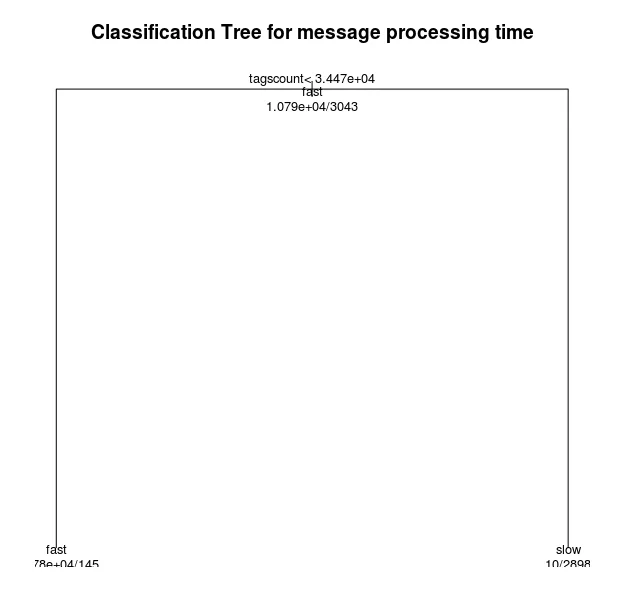
E é assim que fica a implementação:
def html_too_big(s): rn return s.count('<') > _MAX_TAGS_COUNT
Não é lindo? Toda a complexidade da pesquisa em uma única linha!
Validação
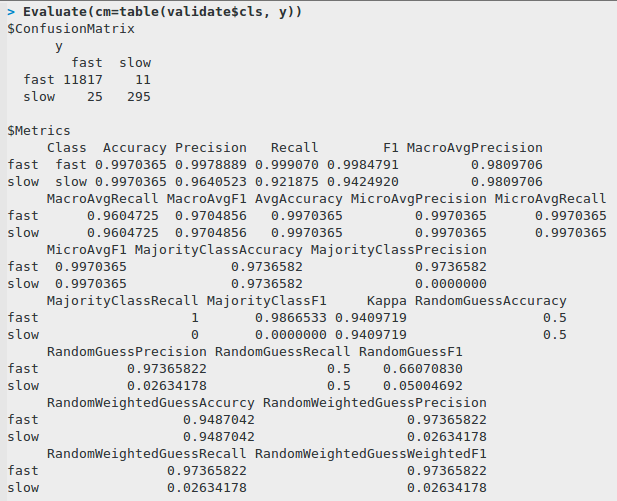
Para a avaliação, pegamos o conjunto de dados de validação e tentamos prever a classificação usando o nosso modelo:
validate <- read.csv(file="messages080916.csv", sep=",", head=TRUE) rn validate <- subset(validate, select=-took) rn xv <- subset(validate, select=-cls) rn y <- predict(fit, xv, type="class") rn table(validate$cls, y)
Aqui está a matriz de confusão e algumas métricas comuns de classificação:
Lições aprendidas
O machine learning não é apenas para cientistas de dados. Mesmo decisões simples impulsionadas por ML podem beneficiar você. Conheça seus dados. Não confie cegamente em modelos e algoritmos científicos.
Links úteis
- Ótima explicação sobre um treino-validação-teste (fluxo de trabalho)
- Guia rápido sobre CART e Random Forests em R
- Guia rápido sobre Análise de Clusters em R
- Como criar gráficos em R
- Conceitos de métricas comuns de classificação
- Precisão e Recall explicados
Divirta-se com o machine learning e a mineração de dados!