IT & Engineering
Machine learning pour les tâches quotidiennes

On pense souvent que le machine learning est trop compliqué pour les tâches de développement quotidiennes. Nous l’associons souvent à des concepts comme le big data, l’exploration de données, la science des données et l’intelligence artificielle. Parfois, cela ressemble à ceci :
Le machine learning est difficile
J’ai toujours pensé que nous pouvions tirer parti du machine learning pour les tâches simples que nous effectuons régulièrement.
Un exemple concret
Chez Mailgun, nous travaillons avec l’email et, dans le cadre de notre offre, nous analysons les citations HTML. Cela permet à l’utilisateur de récupérer la dernière réponse au lieu de la conversation complète, qui est renvoyée dans la réponse de notre webhook. Vous pouvez en savoir plus sur la façon dont nous gérons le traitement des messages entrants dans notre documentation.
Pour celles et ceux qui l’ignorent, voici à quoi ressemble l’analyse du HTML provenant de l’Internet public :
Analyse du HTML provenant de l’Internet public
C’est fastidieux et il arrive que les processus se bloquent.
Changer la bibliothèque d’analyse peut aider, mais cela ne résoudra pas complètement le problème, car chaque bibliothèque a ses limites. Vous devez restreindre l’analyse à une limite raisonnable.
L’analyse de clusters à la rescousse
Mais quels devraient être les critères et le seuil ? Faut-il limiter par la longueur du HTML ou par le nombre de balises ? Peut-être les deux ? Peut-être autre chose ? L’objectif est bien sûr de traiter autant de messages que possible sans se tirer une balle dans le pied, mais la marche à suivre n’est pas très évidente.
C’est là que l’analyse de clusters et la classification statistique s’avèrent utiles. Pour mes recherches, j’utilisais , mais selon votre tâche et vos préférences, vous pourriez utiliser autre chose – scikit-learn, Weka, MOA, etc.
Collecter un jeu de données
Tout d’abord, nous avons consigné la longueur du HTML, le nombre de balises et le temps de traitement des messages, puis nous les avons placés dans un fichier CSV :
htmllen,tagscount,took rn2893762,85527,34.300139904 rn31378,518,0.0368919372559 rn19105,413,0.0545339584351 rn...
Le traitement de la grande majorité des messages prend des fractions de seconde. Par conséquent, lors de la collecte du jeu de données, nous devions nous assurer d’avoir suffisamment de messages « lents ».
Nous avons obtenu deux fichiers CSV, collectés à des jours différents. L’un contenait 13 831 lignes et était réservé à l’analyse et à l’entraînement du modèle (le jeu de données d’entraînement). Un autre contenait 12 149 lignes et était réservé à la validation du modèle (le jeu de données de validation).
En général, il est conseillé d’avoir au moins deux jeux de données : un pour l’entraînement et un pour la validation. Sinon, vous risquez de rencontrer un problème de surapprentissage, où votre modèle est bien ajusté aux données d’entraînement mais échoue dans le monde réel.
Déterminer le nombre de clusters
Pour visualiser les données et rechercher des modèles le partitionnement k-means a d’abord été essayé :
messages <- read.csv(file="messages080816.csv", sep=",", head=TRUE) rn mydata <- matrix(messages$took, ncol=1) rnrn ## Determine the number of clusters rn wss <- (nrow(mydata)-1)*sum(apply(mydata,2,var)) rn for (i in 2:15) wss[i] <- sum(kmeans(mydata, rn centers=i)$withinss) rn plot(1:15, wss, type="b", xlab="Number of Clusters", rn ylab="Within groups sum of squares")
Comme vous pouvez le voir, il y a une amélioration significative des performances jusqu’à 4 clusters. Après cela, il n’y a plus de véritable amélioration.
Clustering
L’étape suivante consistait à comprendre comment les points de données sont répartis entre les clusters :
## K-Means Clustering with 4 clustersrn fit <- kmeans(mydata, 4) rnrn ## Cluster Plot against 1st 2 principal components rn ## vary parameters for most readable graph rn library(cluster) rn clusplot(mydata, fit$cluster, color=TRUE,rn shade=TRUE, labels=2, lines=0)
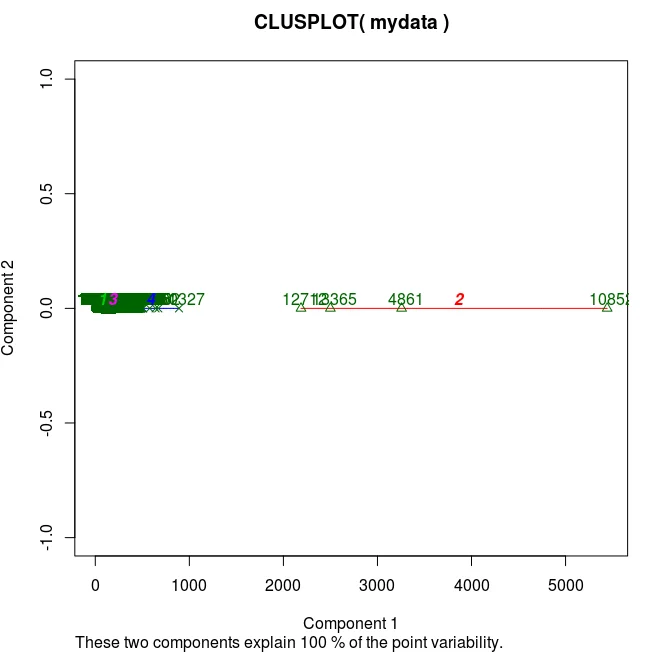
Et vous pouvez déjà anticiper le problème : les clusters se forment en isolant les points de données les plus éloignés, alors que l’intervalle qui nous intéresse (1-20 s) se trouve au beau milieu. Le problème persiste même en augmentant le nombre de clusters.
De plus, il y a un chevauchement important entre les clusters dans l’intervalle :
## get clusters mean, min, max rn mean <- aggregate(mydata,by=list(fit$cluster),FUN=mean) rn min <- aggregate(mydata,by=list(fit$cluster),FUN=min) rn max <- aggregate(mydata,by=list(fit$cluster),FUN=max)
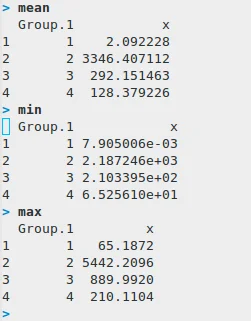
Comparez les clusters 1 et 4. Le problème persiste même en augmentant le nombre de clusters.
À ce stade, nous avons décidé d’essayer une autre approche et d’examiner les centiles du temps de traitement des messages :
percentiles <- quantile(messages$took, seq(0.5, 0.99, 0.01)) rn plot(seq(0.5, 0.99, 0.01), percentile)
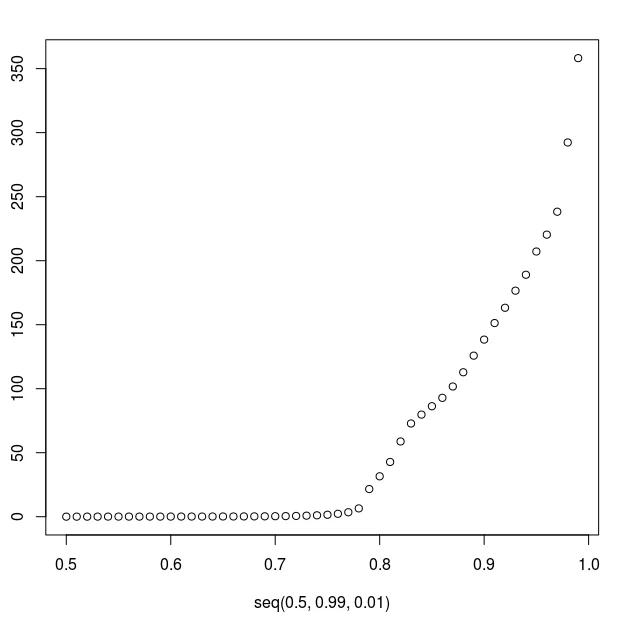
Comme vous pouvez le voir, après le 78e centile, le temps de traitement grimpe rapidement. Voici notre premier seuil : le 78e centile, qui correspondait à 6,5 secondes.
Tous les points de données prenant moins de 6,5 s ont été marqués comme « rapides » et les autres comme « lents ».
Classification
Pour la classification, nous avons essayé SVM (Machines à vecteurs de support), Forêts aléatoires et CART(Arbre de classification et de régression).
CART a montré des résultats légèrement meilleurs pour cette tâche, mais son principal avantage est qu’il fournit un arbre de décision facile à comprendre, à expliquer et à implémenter, contrairement aux SVM ou aux forêts aléatoires qui fonctionnent comme une boîte noire et nécessitent d’utiliser de lourdes bibliothèques de machine learning en production.
Voici comment classer à l’aide de CART :
x <- subset(messages, select=-took) rnlibrary(rpart) rnrn# grow tree rnfit <- rpart(x$cls ~., method="class", data=x) rnrn## display the results rnprintcp(fit)rnrn# detailed summary of splits rnsummary(fit) rnrn# plot tree rnplot(fit, uniform=TRUE, rn main="Classification Tree for message processing time") rntext(fit, use.n=TRUE, all=TRUE, cex=.8)
Voici l’arbre de décision :
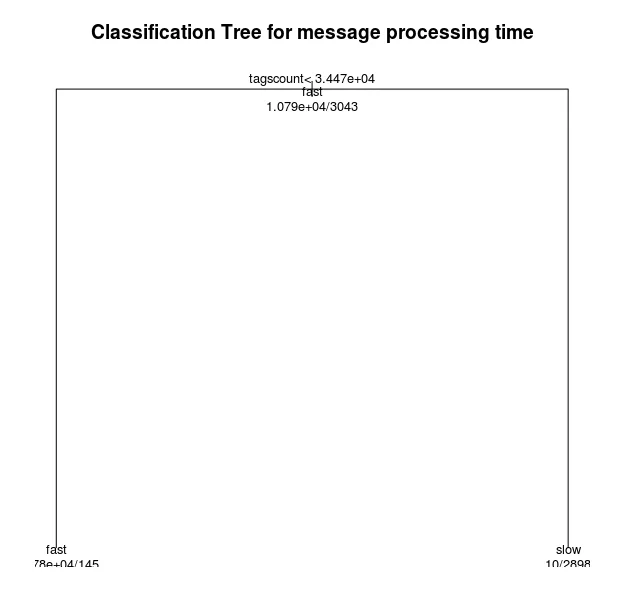
Et voici à quoi ressemble l’implémentation :
def html_too_big(s): rn return s.count('<') > _MAX_TAGS_COUNT
N’est-ce pas magnifique ? Toute la complexité de la recherche en une seule ligne !
Validation
Pour l’évaluation, nous avons pris le jeu de données de validation et essayé de prédire la classification à l’aide de notre modèle :
validate <- read.csv(file="messages080916.csv", sep=",", head=TRUE) rn validate <- subset(validate, select=-took) rn xv <- subset(validate, select=-cls) rn y <- predict(fit, xv, type="class") rn table(validate$cls, y)
Voici la matrice de confusion et quelques statistiques de classification courantes:
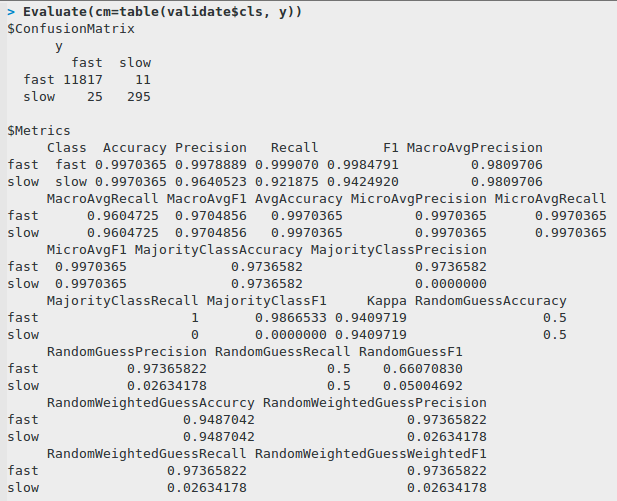
Leçons retenues
Le machine learning n’est pas réservé à l’équipe de data science. Même de simples décisions basées sur le machine learning peuvent vous être utiles. Connaissez vos données. Ne vous fiez pas aveuglément aux algorithmes et modèles scientifiques.
Liens utiles
- Excellente explication d’un train-validate-test flux de travail
- Guide rapide sur CART et Forêts aléatoires dans R
- Guide rapide sur L’analyse de clusters dans R
- Comment tracer dans R
- Quelques statistiques de classification courantes
- Précision et Rappel expliqués
Bon machine learning et bonne exploration de données !