IT & Engineering
Aprendizaje automático para tareas cotidianas

El aprendizaje automático suele considerarse demasiado complicado para las tareas de desarrollo cotidianas. A menudo lo asociamos con conceptos como los macrodatos, la minería de datos, la ciencia de datos y la inteligencia artificial. A veces, la sensación es esta:
El aprendizaje automático es difícil
Siempre he pensado que podemos beneficiarnos del aprendizaje automático para las tareas sencillas que realizamos a diario.
Ejemplo de la vida real
En Mailgun, trabajamos con emails y, como parte de nuestro servicio, analizamos las citas en HTML. Esto permite que un usuario extraiga la última respuesta en lugar de toda la conversación, que se devuelve como parte de nuestra respuesta de webhook. Puedes leer más sobre cómo gestionamos el procesamiento de los mensajes entrantes en nuestra documentación.
Para quienes no lo sepan, así es como se ve el análisis de HTML de internet pública:
Análisis de HTML de internet pública
Es un caos y a veces los procesos se quedan atascados.
Cambiar la biblioteca de análisis puede ayudar, pero no resolverá el problema por completo, ya que todas las bibliotecas tienen sus limitaciones. Tienes que restringir el análisis a algo razonable.
El análisis de clústeres al rescate
Pero ¿cuáles deberían ser los criterios y el límite? ¿Deberíamos limitarlo por la longitud del HTML o por el recuento de etiquetas? ¿Quizás ambos? ¿Tal vez por algo más? Obviamente, el objetivo es procesar la mayor cantidad de mensajes posible sin que resulte contraproducente, pero el camino a seguir no está muy claro.
Ahí es donde el análisis de clústeres y la clasificación estadística resultan útiles. Para la investigación utilicé R, pero, dependiendo de tu tarea y tus preferencias personales, puedes usar otra cosa: scikit-learn, Weka, MOA, etc.
Recopila un conjunto de datos
Primero, registramos la longitud del HTML, el recuento de etiquetas y el tiempo de procesamiento de los mensajes, y los guardamos en un archivo csv:
htmllen,tagscount,took rn2893762,85527,34.300139904 rn31378,518,0.0368919372559 rn19105,413,0.0545339584351 rn...
La inmensa mayoría de los mensajes tardan fracciones de segundo en procesarse. Por tanto, al recopilar el conjunto de datos, tuvimos que asegurarnos de tener suficientes mensajes “lentos”.
Terminamos con dos archivos csv, recopilados en días distintos. Uno tenía 13 831 líneas y se reservó para el análisis y el entrenamiento del modelo (el conjunto de datos de entrenamiento). El otro tenía 12 149 líneas y se reservó para la validación del modelo (el conjunto de datos de validación).
Por lo general, conviene tener al menos dos conjuntos de datos: uno para el entrenamiento y otro para la validación. De lo contrario, podrías encontrarte con el problema del sobreajuste (overfitting), en el que tu modelo se ajusta bien a los datos de entrenamiento pero fracasa en el mundo real.
Determina el número de clústeres
Para visualizar los datos y buscar patrones, el agrupamiento k-means fue lo primero que probamos:
messages <- read.csv(file="messages080816.csv", sep=",", head=TRUE) rn mydata <- matrix(messages$took, ncol=1) rnrn ## Determine the number of clusters rn wss <- (nrow(mydata)-1)*sum(apply(mydata,2,var)) rn for (i in 2:15) wss[i] <- sum(kmeans(mydata, rn centers=i)$withinss) rn plot(1:15, wss, type="b", xlab="Number of Clusters", rn ylab="Within groups sum of squares")
Como puedes ver, hay una mejora de rendimiento significativa hasta los cuatro clústeres. A partir de ahí, no hay una mejora real.
Agrupamiento
El siguiente paso era averiguar cómo se distribuyen los puntos de datos entre los clústeres:
## K-Means Clustering with 4 clustersrn fit <- kmeans(mydata, 4) rnrn ## Cluster Plot against 1st 2 principal components rn ## vary parameters for most readable graph rn library(cluster) rn clusplot(mydata, fit$cluster, color=TRUE,rn shade=TRUE, labels=2, lines=0)
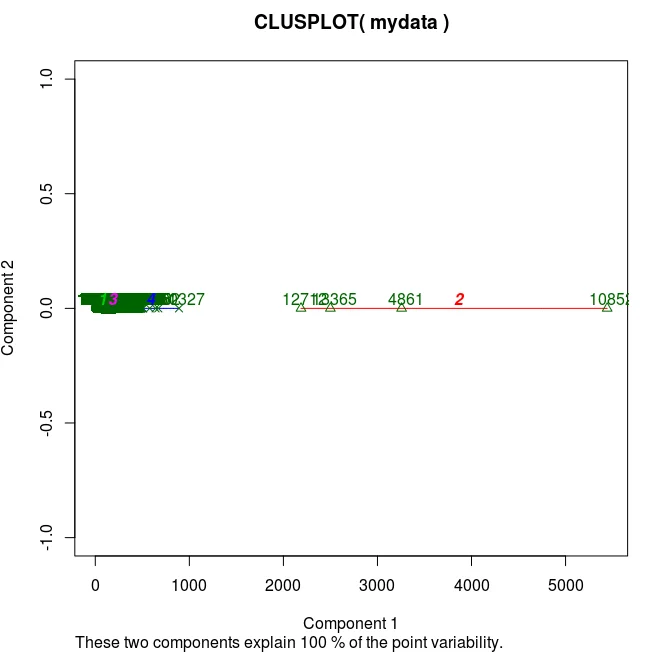
Y hasta cierto punto ya puedes anticipar el problema: los clústeres se forman separando los puntos de datos más lejanos, mientras que el intervalo que nos interesa (1-20 s) está justo en el medio. El problema persiste al aumentar el número de clústeres.
Además, existe una superposición importante entre los clústeres en el intervalo:
## get clusters mean, min, max rn mean <- aggregate(mydata,by=list(fit$cluster),FUN=mean) rn min <- aggregate(mydata,by=list(fit$cluster),FUN=min) rn max <- aggregate(mydata,by=list(fit$cluster),FUN=max)
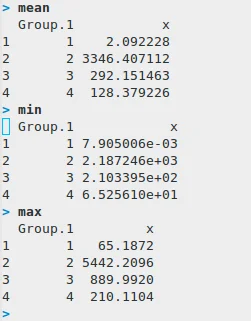
Compara los clústeres 1 y 4. El problema persiste al aumentar el número de clústeres.
En este punto, decidimos probar un enfoque distinto y analizar los percentiles del tiempo de procesamiento de los mensajes:
percentiles <- quantile(messages$took, seq(0.5, 0.99, 0.01)) rn plot(seq(0.5, 0.99, 0.01), percentile)
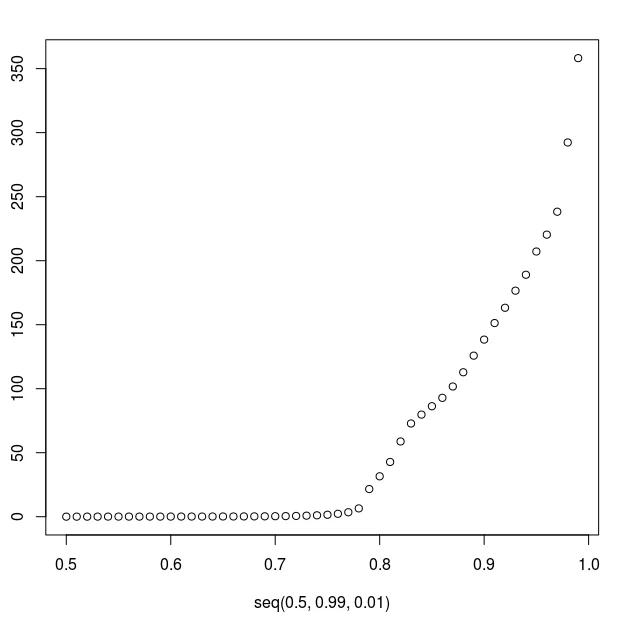
Como puedes ver, a partir del percentil 78 el tiempo de procesamiento se dispara rápidamente. Aquí teníamos nuestro primer límite: el percentil 78, que correspondía a 6,5 segundos.
Todos los puntos de datos que tardaban menos de 6,5 s se marcaron como “rápidos” y los demás como “lentos”.
Clasificación
Para la clasificación, probamos SVM (máquinas de vectores de soporte), Random Forests y CART(árboles de clasificación y regresión).
CART mostró resultados ligeramente mejores para esta tarea, pero su principal ventaja es que ofrece un árbol de decisión fácil de entender, explicar e implementar frente a las SVM o los Random Forests, que funcionan como una caja negra y requieren el uso de bibliotecas pesadas de aprendizaje automático en producción.
Así es como se clasifica usando CART:
x <- subset(messages, select=-took) rnlibrary(rpart) rnrn# grow tree rnfit <- rpart(x$cls ~., method="class", data=x) rnrn## display the results rnprintcp(fit)rnrn# detailed summary of splits rnsummary(fit) rnrn# plot tree rnplot(fit, uniform=TRUE, rn main="Classification Tree for message processing time") rntext(fit, use.n=TRUE, all=TRUE, cex=.8)
Este es el árbol de decisión:
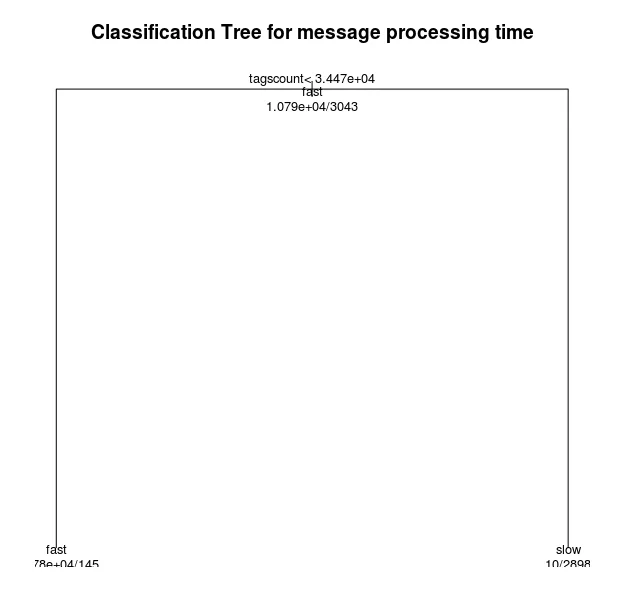
Y este es el aspecto de la implementación:
def html_too_big(s): rn return s.count('<') > _MAX_TAGS_COUNT
¿No es una maravilla? ¡Toda la complejidad de la investigación en una sola línea!
Validación
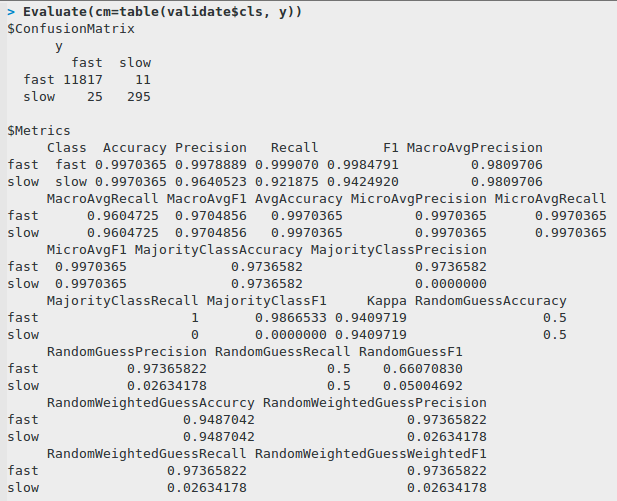
Para la evaluación tomamos el conjunto de datos de validación e intentamos predecir la clasificación usando nuestro modelo:
validate <- read.csv(file="messages080916.csv", sep=",", head=TRUE) rn validate <- subset(validate, select=-took) rn xv <- subset(validate, select=-cls) rn y <- predict(fit, xv, type="class") rn table(validate$cls, y)
Esta es la matriz de confusión y algunas métricas de clasificación comunes:
Lecciones aprendidas
El aprendizaje automático no es solo para los científicos de datos. Incluso las decisiones sencillas impulsadas por el aprendizaje automático pueden beneficiarte. Conoce tus datos. No confíes ciegamente en los algoritmos ni en los modelos científicos.
Enlaces útiles
- Gran explicación de un entrenamiento-validación-prueba como flujo de trabajo
- Guía rápida sobre CART y Random Forests en R
- Guía rápida sobre el análisis de clústeres en R
- Cómo trazar gráficos en R
- El concepto de métricas de clasificación comunes
- precisión y Recall explicado
¡Feliz aprendizaje automático y minería de datos!