IT & Engineering
Was Toaster und verteilte Systeme gemeinsam haben könnten

Vor einigen Monaten haben wir das automatische IP-Warm-up veröffentlicht, aber wir sind nie dazu gekommen, über dessen Implementierung zu sprechen. Heute werfen wir einen Blick unter die Haube und versuchen zu verstehen, wie unser IP-Warm-up funktioniert. Wir beginnen mit etwas Kontext und tauchen später im Beitrag in die interessanten technischen Details ein.
Warum das IP-Warm-up so wichtig ist
Seien wir ehrlich – niemand erhält gerne eine Unmenge an Informationen auf einmal. Das Gleiche gilt für E-Mail-Anbieter, die Ihre E-Mails empfangen. Spammer versenden ihre Kampagnen in der Regel über einen sehr kurzen Zeitraum, daher mögen die Anbieter dieses Verhalten nicht. Um sich vor Missbrauch zu schützen, blockieren sie Nachrichten, die von einer IP-Adresse stammen, über die noch nie zuvor eine E-Mail versendet wurde. Einige Anbieter akzeptieren die Nachrichten vielleicht noch, aber diese landen dann direkt im Spam. Das nützt niemandem.
Damit diese Nachrichten im Posteingang landen, sollten wir zunächst weniger davon zustellen und das Volumen im Laufe der Zeit erhöhen, um eine Reputation aufzubauen; daher kommt der Begriff „Warm-up“. Denken Sie daran, wie Sie einen Motor warmlaufen lassen, bevor Sie Vollgas geben, oder sich im Fitnessstudio aufwärmen, bevor Sie Gewichte heben – es ist in etwa so ähnlich.
Wenn Sie sich Registrieren für ein Mailgun-Konto registrieren, erhalten Sie eine geteilte IP-Adresse. Eine geteilte IP-Adresse wird von mehreren Kunden genutzt, sie ist also bereits aufgewärmt und hat eine gute Reputation. Sie müssen sich darüber keine Gedanken machen, es sei denn, ein anderer Absender sorgt dafür, dass ihre Reputation sinkt. Nun möchten Sie eine dedizierte IP-Adressehinzufügen, und wir haben bereits darüber gesprochen, warum dies sinnvoll ist , wenn Ihr Versandvolumen steigt. Die dedizierte IP-Adresse, die Sie erhalten, ist neu und hat keine Reputation, daher wissen E-Mail-Anbieter nichts darüber. Wir wärmen sie nicht vor, da wir möchten, dass Ihre IP-Adresse an Ihren Versand geknüpft ist und Sie im Laufe der Zeit Ihre eigene Reputation aufbauen können. Das führt zu besseren Ergebnissen. Bedeutet das, dass Sie von Anfang an nur wenige Nachrichten versenden sollten? Ja, wir wissen, dass das nicht optimal ist.
Hier kommt das automatische IP-Warm-up ins Spiel. Wenn eine dedizierte IP-Adresse hinzugefügt wird, bleibt die geteilte IP-Adresse weiterhin in Ihrem Konto, sodass wir den Traffic während des Warm-ups dorthin umleiten können. Im Laufe der Zeit erhöhen wir das Volumen schrittweise, um immer mehr Nachrichten zu versenden, bis die dedizierte IP-Adresse vollständig aufgewärmt ist und Sie startklar sind.
Ein sehr wichtiger Punkt ist jedoch, dass der Warm-up-Prozess allein keine hervorragende Zustellbarkeit garantiert. Ihre Praktiken als Absender bestimmen die Zustellbarkeit. Übernehmen Sie daher die Verantwortung für die von Ihnen versendeten Nachrichten und die Empfänger, die diese erhalten. Andernfalls verschlechtern Sie die IP-Reputation nur langsam, anstatt sie sofort zu ruinieren.
Warm-up-Plan
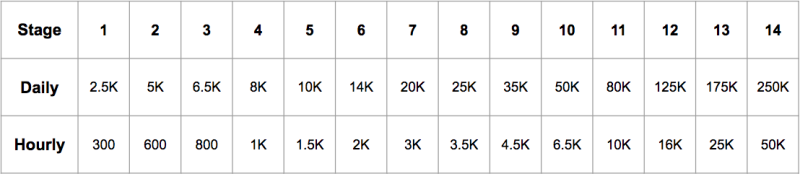
Wir haben festgestellt, dass E-Mail-Anbieter in der Regel sowohl auf stündliche als auch auf tägliche Volumen achten. Das Volumen könnte jeden Tag um einige Prozent erhöht werden. Das ist sehr praktisch, da dieser Zinseszinseffekt zu exponentiellem Wachstum und der Möglichkeit führt, das Volumen in relativ wenigen Schritten zu erhöhen. Wir nennen diese Schritte „Stufen“. Diese Stufen bilden einen „Warm-up-Plan“, der wie folgt aussieht:
Wenn wir die täglichen Mengen grafisch darstellen, ergibt sich folgendes Bild:
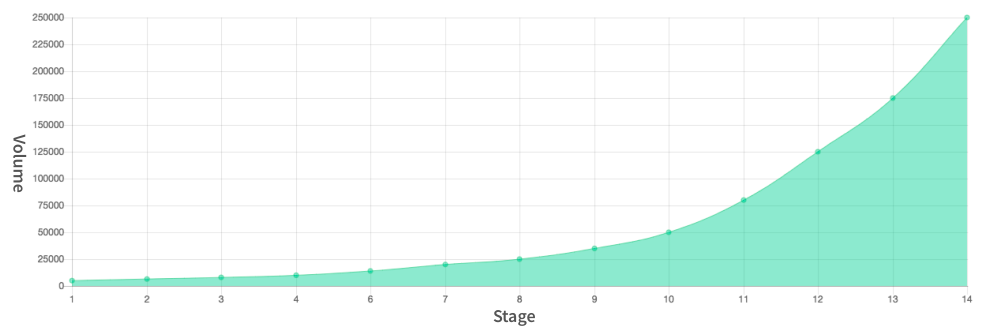
Er besteht aus 14 Stufen, und in jeder Stufe versenden wir eine bestimmte Menge an Nachrichten von einer dedizierten IP-Adresse. Dieses Volumen wurde von unserem Team für Zustellbarkeit durch Recherchen sorgfältig ermittelt und wird regelmäßig aktualisiert, sobald neue Erkenntnisse vorliegen. Es hat sich herausgestellt, dass der Versand der richtigen Menge an Nachrichten ein interessantes technisches Problem darstellt, und wir möchten einige Details zu unserer Lösung teilen.
Ein bestimmtes Volumen aufrechterhalten
Werfen wir einen genaueren Blick auf die Implementierung eines Algorithmus, mit dem wir eine vorgegebene Menge an Nachrichten versenden können. Da wir nun eine geteilte und eine dedizierte IP-Adresse zusammen haben, sollten wir uns überlegen, wie wir den Traffic zwischen den beiden aufteilen. Der einfachste Weg dazu ist die Implementierung eines zufälligen Load-Balancing-Algorithmus. Stellen Sie sich vor, wir werfen eine Münze, um zu bestimmen, von welcher IP-Adresse eine Nachricht gesendet wird, wobei die geteilte IP-Adresse „Kopf“ und die dedizierte IP-Adresse „Zahl“ ist. Wenn wir die Anzahl der von der dedizierten IP-Adresse gesendeten Nachrichten verringern wollten, würden wir die Wahrscheinlichkeit ändern, dass das Ergebnis „Zahl“ lautet. Das würde unsere Münze zwar verfälschen, aber es ist zu unserem Vorteil. So könnte das in Golang aussehen:
var rnd = rand.New(rand.NewSource(98))trnvar probabilityOfDedicated = 0.2rnif rnd.Float64() < probabilityOfDedicated {rn return "dedicated"rn}rnreturn "shared"
Die probabilityOfDedicated kann jeden Float-Wert von 0 bis 1,0 annehmen. Bei einem Wert von 1,0 werden alle Nachrichten über die dedizierte IP-Adresse gesendet, und bei null gehen alle über die geteilte IP-Adresse. Wenn wir den Wert auf 0,5 setzen, ist die Wahrscheinlichkeit für den Versand über die dedizierte oder die geteilte IP-Adresse gleich hoch. Es ist im Wesentlichen ein Regler, der den Versand steuert. Sehen wir uns an, wie wir eine Rate von 350 Nachrichten pro Stunde von der dedizierten IP-Adresse aufrechterhalten können, indem wir diesen Wert aktualisieren. Die einfachste Lösung wäre, die probabilityOfDedicated auf eins zu setzen und sie nach Erreichen der Grenze von 350 Nachrichten wieder auf null zurückzusetzen. Das ist ein wenig abrupt, sollte aber funktionieren.
const cap = 350rnfunc getProbabilityOfDedicated(sentMessages int) float64 {rn if sentMessages < cap {rn return 1rn }rn return 0rn}
Ist es wirklich so einfach?
Wenn wir ein Programm auf Hunderten von Servern ausführen möchten, das Hunderttausende Anfragen pro Sekunde verarbeitet, können wir nicht erwarten, dass alles immer in Echtzeit aktualisiert wird. Optimierungstechniken wie Batch-Verarbeitung und Caching werden zu unseren besten Freunden. Sie erfüllen ihren Zweck hervorragend, verursachen aber zwangsläufig eine Verzögerung zwischen der Berechnung, der Aktualisierung und der Verteilung eines Wertes über alle Knoten eines Clusters. Nennen wir diese Verzögerung im Folgenden Trägheit.
In unserem Beispiel gibt es viele Faktoren, die zur Trägheit beitragen. Erstens erfolgen die Aktualisierungen der Statistiken aufgrund von Optimierungen im Dienst zum Zählen der Nachrichten möglicherweise nicht wirklich in Echtzeit. Zweitens gibt es durch das Caching eine Verzögerung zwischen der Berechnung und der Verteilung unseres Wertes für die Wahrscheinlichkeit der Auswahl einer dedizierten IP-Adresse. Bis wir bemerken, dass die 350. Nachricht versendet wurde und es Zeit ist, anzuhalten, könnten weitere Nachrichten durchrutschen, bevor die Aktualisierung wirksam wird.
Dies ist ein funktionierendes Beispiel. Sie können es gerne in den Go Playground einfügen und damit experimentieren:
package mainrnrnimport (rn "fmt"rn "math/rand"rn "sync"rn "time"rn)rnrnvar (rn mutex = &sync.Mutex{}rn rnd = rand.New(rand.NewSource(99))rn messagesSent = 0 // keep track of the messages that IP sendsrn probability = 0.0 // probability of picking a dedicated IPrn)rnrnconst (rn sampleRateMsec = 50.0 // how often the system is being refreshedrn cap = 350.0 // this is how many messages we want to sendrn)rnrn// deliverySimulator will emulate the message sending process.rn// It will pick the dedicated IP based on the probability.rnfunc deliverySimulator() {rn for {rn mutex.Lock()rn if rnd.Float64() < probability {rn // We don't know how fast the messages arern // being submitted, let's throw somern // randomness in there to make it unpredictable.rn messagesSent += rnd.Intn(10)rn } else {rn // Shared IP will be picked here.rn }rn mutex.Unlock()rn time.Sleep(time.Millisecond)rn }rn}rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn if sent < cap {rn return 1rn }rn return 0rn}rnrnfunc main() {rn go deliverySimulator()rnrn // Control loop.rn for i := 0; i < 8; i++ {rn mutex.Lock()rnrn // Get messages.rn sent := messagesSentrnrn // Calculate probability.rn probability = calcProbabilityOfDedicated(sent)rnrn fmt.Println("sent:", sent, "probability:", probability)rn mutex.Unlock()rnrn time.Sleep(time.Duration(sampleRateMsec) * time.Millisecond)rn }rn}
Hier ist die Ausgabe, die wir erhalten:
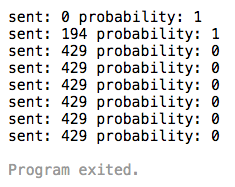
Huch, es sieht so aus, als hätten wir viel mehr Nachrichten versendet als geplant; fast 25 % mehr, um genau zu sein. Was können wir dagegen tun? Wir könnten einen Schwellenwert festlegen, um den Vorgang im Voraus zu stoppen, aber dieser müsste für alle Kunden unterschiedlich sein, da sie Nachrichten in unterschiedlichen Raten einreichen.
Was wäre, wenn wir uns die Trägheit zunutze machen könnten? Was wäre, wenn wir schrittweise abbremsen könnten?
Physische Systeme
Trägheit ist in der physischen Welt sehr verbreitet. Um mechanische Systeme zu steuern, muss die Trägheit stets berücksichtigt werden. Können wir daraus etwas lernen?
Die ersten Versuche, einen automatischen Regler für physische Systeme zu entwickeln, gehen auf das 17. Jahrhundert zurück, und zwar mit dem Fliehkraftregler. Dieser war damals ein wesentlicher Bestandteil jeder Dampfmaschine. Spulen wir vor ins frühe 20. Jahrhundert, wo die Theorie hinter dem Proportional-Integral-Derivative-Regler (PID-Regler) entwickelt wurde, nachdem man beobachtet hatte, wie Schiffe gesteuert werden, indem verschiedene Umwelt- und Systemfaktoren berücksichtigt werden. Heutzutage werden PID-Regler überall eingesetzt, von Quadcoptern bis hin zu Toastern, denn sie sind sehr einfach und effektiv. Natürlich gibt es noch viele andere Steueralgorithmen, aber die meisten sind nicht annähernd so elegant.
Ein wenig Regelungstechnik
Sprechen wir über die Theorie hinter PID-Reglern. Zunächst einmal funktionieren sie nur, wenn es eine Rückkopplungsschleife gibt. Rückkopplungsschleifen sind recht einfach, da das Ergebnis der Aktion wieder in den Eingang des Reglers eingespeist wird. Das ist wie ein Ouroboros falls diese Symbolik aus der Mythologie weiterhilft, und falls nicht, gibt es dieses Diagramm.
+------------+Diagramm 1
input | | output
+------> | | +------>
| system |
control | | feedback
+------> | | +------+
| +------------+ |
| |
| +------------+ |
+------+ | controller | <------+
+------------+
Sehen wir uns den Controller-Block genauer an und öffnen ihn.
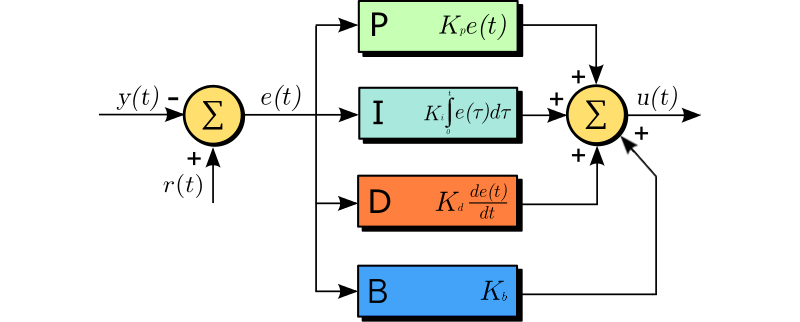
Wow, das ist eine Menge. Das ist ein wenig überwältigend, also schlüsseln wir es etwas auf. Zunächst müssen wir die Terminologie klären. Hier sind einige Begriffe, mit denen Sie vertraut sein sollten:
Prozessvariable – y(t), der aktuelle Wert dessen, was wir steuern möchten. In unserem Fall wäre das die Anzahl der von einer IP-Adresse versendeten Nachrichten, die als Rückkopplung dient.
Sollwert – r(t), der Wert, den wir erreichen möchten. In unserem Beispiel ist es die Obergrenze von 350 Nachrichten.
Fehler – e(t), die aktuelle Differenz zwischen einem Sollwert und einer Prozessvariable. e(t) = r(t) – y(t).
Stellgröße – u(t), die Ausgabe des Reglers. Diese steuert unsere Wahrscheinlichkeit für die Auswahl einer dedizierten IP-Adresse.
Alle Variablen werden als Funktion f(t) geschrieben. Das bedeutet, dass sich ihr Wert in Bezug auf die Zeit t ändert. Es handelt sich also um einen Wert zu genau diesem Zeitpunkt. Das Diagramm lässt sich durch die klassische Formel aus jedem Lehrbuch der Regelungstechnik beschreiben:
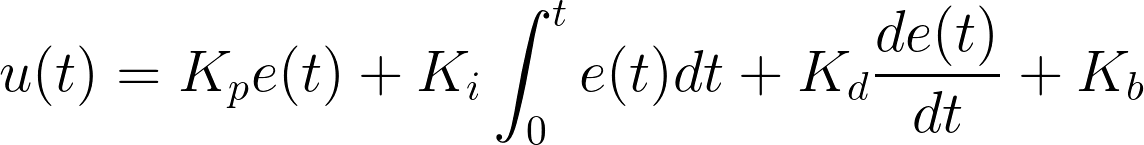
Es gibt vier Terme in dieser Gleichung – proportional + integral + derivativ + Bias. Jeder von ihnen trägt zum Steuersignal bei, und die Gewichtung ihrer Beiträge kann durch die entsprechenden Koeffizienten festgelegt werden: Kp, Ki, Kd und Kb.
Der proportionale Term (Block P in Diagramm 2) ist der wichtigste Bestandteil der Gleichung. Wie der Name schon sagt, ist er proportional zum Fehler. Je größer der Fehler, desto mehr Steuerkraft wird auf das System ausgeübt.
Der integrale Term (Block I in Diagramm 2) ist nützlich, um den Sollwert schneller zu erreichen. Er summiert die Fehler im Laufe der Zeit und versucht, dem proportionalen Term bei deren Korrektur zu helfen. Für unseren Anwendungsfall hat er jedoch einen sehr wichtigen Nachteil – ein potenzielles Überschwingen. Die Eigenschaft des integralen Terms besteht darin, dass er anfangs nur langsam greift. Wenn sich jedoch mit der Zeit genügend Fehler angesammelt haben, kann er das System übersteuern und über den Sollwert hinausschießen. Im extremsten Fall kann dies zu dem sogenannten Integral Windup.
Der derivative Term (Block D in Diagramm 2) ist proportional zur Änderungsrate. Während wir den Fehler reduzieren, wird der derivative Term tatsächlich negativ. Wir können uns das so vorstellen: Wenn wir uns dem Sollwert zu schnell nähern, bremst er uns ab. Dies führt in der Regel zu einer allmählicheren Änderung der Prozessvariable.
Der Bias-Term (Block B in Diagramm 2) ist lediglich eine Konstante. Er wird nicht oft verwendet, kann aber nützlich sein, um den Wert weiter anzutreiben, wenn er sich nah am Sollwert befindet. An diesem Punkt ist der Fehler klein und der proportionale Term nicht besonders ausgeprägt.
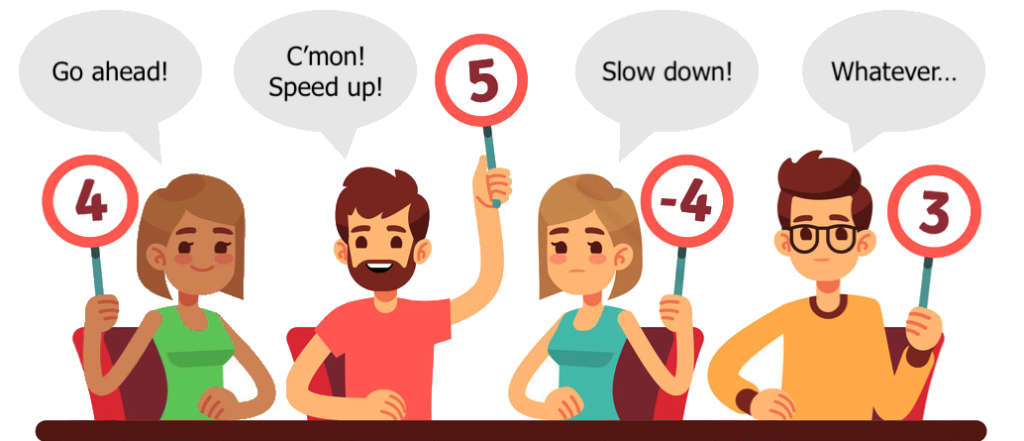
Stellen Sie sich diese Terme wie eine Jury vor, die darüber abstimmt, was der nächste Schritt sein sollte. Der Regler handelt auf Grundlage der vergebenen Punkte. Da sie unterschiedliche Persönlichkeiten haben, bewerten sie alle etwas unterschiedlich. Der Proportionale ist das vernünftigste Jurymitglied und vergibt immer eine höhere Punktzahl, je weiter wir vom Sollwert entfernt sind. Der Integrale wird ungeduldig, wenn wir den Fehler zu lange nicht reduzieren, sodass er mit der Zeit eine höhere Punktzahl vergibt. Der Derivative ist immer nervös und vergibt Minuspunkte, wenn der Fehler zu schnell reduziert wird. Der Bias vergibt immer dieselbe Punktzahl, egal was passiert.
Die Theorie auf unser Problem anwenden
Da wir nun mit der Theorie vertraut sind, wenden wir sie an. Wir können den bestehenden Regelkreis aus dem vorherigen Beispiel verwenden. Eines der schwierigsten Dinge bei der Implementierung ist die Auswahl geeigneter Steuerkoeffizienten. Das Einstellen des PID-Prozesses ist nicht einfach, und es gibt einige Techniken , die uns dabei helfen können. Wir haben jedoch festgestellt, dass der schnellste Weg darin besteht, ein Simulationsskript zu erstellen und mit den Parametern zu experimentieren. Sie sind vielleicht nicht perfekt, aber sie reichen aus, um das Problem zu lösen.
So können wir uns die Koeffizienten in Bezug auf unser Problem vorstellen.
Proportional verringert die Wahrscheinlichkeit für die Auswahl einer dedizierten IP-Adresse, je näher wir der gewünschten Obergrenze kommen. Zu Beginn ist der Wert dieses Terms also groß und sinkt auf null, während wir immer mehr Nachrichten versenden.
Integral ist knifflig und wir brauchen es vielleicht nicht einmal, da wir nicht korrigieren können: das Überschwingen. Die Nachrichten können nach dem Versand nicht gelöscht werden.
Derivativ ist ein sehr wichtiger Aspekt. Er hilft uns dabei, die Situation zu korrigieren, wenn die Nachrichten zu schnell übermittelt werden. Wenn das passiert, wird der Term groß genug und beginnt, anderen Termen entgegenzuwirken. Da er in diesem Fall negativ ist, verringert er die Wahrscheinlichkeit und damit auch die Menge der Nachrichten, die über eine dedizierte IP-Adresse versendet werden.
Bias kann sehr nützlich sein, wenn wir nicht vorhaben, uns auf den integralen Term zu verlassen. Wenn wir uns der gewünschten Obergrenze stark nähern, ist der proportionale Term klein und kann den Wert nicht mehr so stark in diese Richtung treiben. In diesem Moment könnte der Bias für einen kleinen Schub sorgen.
Da wir nun all das wissen, können wir calcProbabilityOfDedicated durch folgenden Code ersetzen:
const (rn // These coefficients has been picked by trial-and-error.rn Kp = 0.42 // proportional coefficientrn Ki = 0.000001 // can be removed to simplify the algorn Kd = 1.2 // derivative coefficientrn Kb = 0.1 // fairly small in this examplern)rnrnvar (rn errorVal = 0.0rn prevError = 0.0rn integral = 0.0rn)rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn prevError = errorValrnrn // Calculate terms.rn errorVal = cap - float64(sent)rn integral = integral + (errorVal * float64(sampleRateMsec))rn derivative := (errorVal - prevError) / float64(sampleRateMsec)rnrn // Calculate PID control responsern probability := Kp*errorVal + Ki*integral + Kd*derivative + Kbrnrn // With given parameters the output is roughly within [0: 100]rn // Let's shape it to [0: 1]rn probability /= 100rn if probability > 1 {rn return 1rn }rn if probability < 0 {rn return 0rn }rnrn return probabilityrn}
So erhalten wir Folgendes:
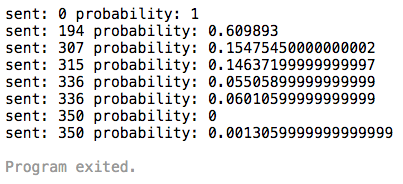
Wie Sie sehen, funktioniert es reibungslos. Wir haben schnell auf 300 erhöht, dann verlangsamt und schließlich 350 erreicht, woraufhin die Wahrscheinlichkeit auf natürliche Weise auf fast null gesunken ist. Wie fantastisch ist das denn?
Ergebnisse
In der Realität stellt der Algorithmus den Wert vielleicht nicht präzise ein, aber er hat einen großen Vorteil – er lässt sich leicht verteilen. Stellen Sie sich vor, einer der Worker wählt eine IP-Adresse aus und sperrt sie, berechnet die Wahrscheinlichkeit, speichert sie und geht dann zur nächsten über. Dadurch können wir das Volumen von Tausenden von IP-Adressen gleichzeitig steuern.
Nachdem wir das geklärt haben, können wir einen Warm-up-Plan erstellen. Er besteht aus Stufen, wobei jeder Stufe eine maximale Anzahl an Nachrichten zugewiesen ist. Während wir die Stufen durchlaufen, erhöht sich dieses maximale Volumen und Sie können immer mehr Nachrichten versenden. So können Sie genauso schnell versenden, wie Sie es von einer geteilten IP-Adresse gewohnt sind, während wir nach und nach eine neue, dedizierte aufwärmen.
Sehen wir uns an, wie es in der Produktionsumgebung funktioniert. Hier haben wir das Volumen für jede Stufe grafisch dargestellt. Die Zielwerte stammen aus dem Warm-up-Plan, und die tatsächlichen Werte entsprechen dem, was versendet wurde.
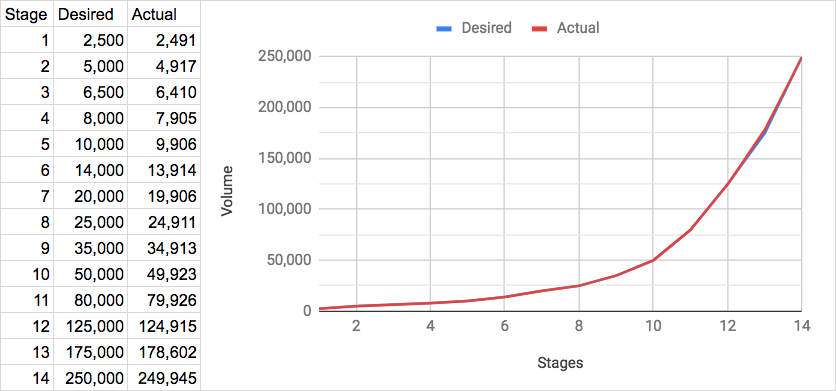
Sieht gut aus. Vor der Einführung haben wir eine Simulationsumgebung erstellt, mit der wir verschiedene Szenarien testen konnten. So ist es uns gelungen, die Werte für die Koeffizienten aufeinander abzustimmen. Zu unserer großen Überraschung hat es beim ersten Deployment in der Produktionsumgebung direkt funktioniert… Wenn das doch nur bei jedem Deployment so wäre.