IT & Engineering
O que torradeiras e sistemas distribuídos podem ter em comum

Há alguns meses lançamos o aquecimento automático de IP, mas nunca chegamos a falar sobre como ele é implementado. Hoje, vamos dar uma olhada nos bastidores e tentar entender como o nosso aquecimento de IP funciona. Vamos começar com um pouco de contexto e depois mergulharemos nos detalhes técnicos interessantes mais adiante neste post.
Por que o aquecimento de IP é tão importante?
Sejamos sinceros — ninguém gosta de receber um monte de informações de uma só vez. O mesmo vale para os provedores de caixas de correio ao receberem os seus e-mails. Os spammers costumam disparar suas campanhas em um curto período, e os provedores não gostam desse comportamento. Para se protegerem de abusos, eles bloquearão mensagens que venham de um IP que nunca tenha enviado um e-mail antes. Alguns provedores ainda podem aceitar as mensagens, mas elas irão direto para o spam. Isso não é bom para ninguém.
Para que essas mensagens cheguem à caixa de entrada, é melhor começar entregando menos e aumentar o volume ao longo do tempo para construir uma reputação; é por isso que chamamos isso de “aquecimento”. Pense em aquecer o motor de um carro antes de pisar fundo ou fazer exercícios leves antes de levantar peso na academia. É mais ou menos assim.
Quando você se cadastra para uma conta do Mailgun, você recebe um IP compartilhado. Um IP compartilhado significa que ele é usado por vários clientes, ou seja, já está aquecido e tem uma boa reputação. Você não precisa se preocupar com isso, a menos que outro remetente faça a reputação dele cair. Agora você quer adicionar um IP dedicado, e já falamos sobre por que você pode querer isso conforme o seu volume de envios cresce. O IP dedicado que você recebe é novo e não tem reputação, portanto, os provedores de caixas de correio não sabem nada sobre ele. Não os aquecemos previamente porque queremos que seu IP esteja vinculado ao que você está enviando, para que você possa construir sua própria reputação ao longo do tempo. Isso levará a resultados melhores. Isso significa que você ainda deve enviar apenas algumas mensagens no começo? Sim, sabemos que isso não é o ideal.
É aí que entra o aquecimento automático de IP. Quando um IP dedicado é adicionado, o IP compartilhado continua na sua conta, de modo que podemos desviar o tráfego para ele durante o aquecimento. Com o tempo, podemos aumentar o volume gradativamente para enviar cada vez mais mensagens até que o IP dedicado esteja totalmente aquecido e pronto para uso.
Um ponto muito importante a lembrar, no entanto, é que o processo de aquecimento não garantirá uma ótima entregabilidade! As práticas que você adota como remetente são o que impulsiona a entregabilidade, então certifique-se de assumir a responsabilidade pelas mensagens que você envia e pelos destinatários que as recebem. Caso contrário, você estará apenas deteriorando lentamente a reputação de IP em vez de queimá-la instantaneamente!
Plano de aquecimento
Descobrimos que os provedores de caixas de correio costumam se importar com os volumes por hora e diários. A cada dia, o volume pode ser aumentado em uma pequena porcentagem. Isso é muito útil porque esse efeito composto leva a um crescimento exponencial e à capacidade de aumentar o volume em uma quantidade relativamente pequena de etapas. Chamamos essas etapas de “estágios”. Os estágios compõem um “plano de aquecimento”, que se parece com isto:
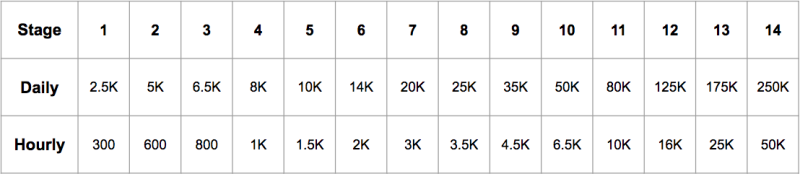
Se plotarmos os valores diários, teremos o seguinte gráfico:

Ele consiste em 14 estágios e, em cada estágio, enviamos uma certa quantidade de mensagens de um IP dedicado. Esse volume foi determinado cuidadosamente por nossa equipe de entregabilidade por meio de pesquisas e é atualizado periodicamente quando coletamos novas evidências. Acabou que enviar uma quantidade adequada de mensagens é um problema de engenharia interessante, e gostaríamos de compartilhar alguns detalhes sobre como o resolvemos.
Como manter um certo volume
Vamos nos aprofundar e analisar melhor a implementação de um algoritmo que nos permite enviar uma dada quantidade de mensagens. Agora que temos um IP compartilhado e um IP dedicado juntos, devemos pensar em como balancear o tráfego entre eles. A maneira mais fácil de fazer isso é implementar um algoritmo aleatório de balanceamento de carga. Imagine que jogamos uma moeda para determinar de qual IP uma mensagem será enviada, sendo o IP compartilhado “cara” e o IP dedicado “coroa”. Se quiséssemos diminuir o número de mensagens provenientes do IP dedicado, alteraríamos a probabilidade de obter “coroa” como nosso resultado. Isso deixaria a nossa moeda viciada, mas funciona a nosso favor. Veja como isso ficaria em Golang:
var rnd = rand.New(rand.NewSource(98))trnvar probabilityOfDedicated = 0.2rnif rnd.Float64() < probabilityOfDedicated {rn return "dedicated"rn}rnreturn "shared"
O probabilityOfDedicated pode ter qualquer valor float entre 0 e 1,0. Quando for 1,0, todas as mensagens passam pelo IP dedicado e, quando for 0, tudo passa pelo IP compartilhado. Defini-lo como 0,5 nos dará as mesmas chances de envio pelo IP dedicado ou pelo IP compartilhado. É basicamente um botão giratório que controla o fluxo de envios. Vamos ver como podemos manter uma taxa de 350 mensagens por hora pelo IP dedicado atualizando esse valor. A ideia mais simples que vem à mente é definir o probabilityOfDedicated como 1 e, assim que a marca de 350 mensagens for alcançada, redefini-lo para 0. É um pouco brusco, mas deve resolver o problema.
const cap = 350rnfunc getProbabilityOfDedicated(sentMessages int) float64 {rn if sentMessages < cap {rn return 1rn }rn return 0rn}
É realmente tão simples?
Quando queremos executar um programa em centenas de servidores processando centenas de milhares de solicitações por segundo, não podemos esperar que tudo seja atualizado em tempo real sempre. Técnicas de otimização, como processamento em lote e armazenamento em cache, tornam-se nossos melhores amigos. Elas são ótimas para o que foram projetadas, mas acabam gerando um atraso entre o momento em que um valor é calculado, atualizado e compartilhado entre todos os nós em um cluster. Vamos chamar esse atraso de inércia de agora em diante.
Falando do nosso exemplo, há muitas coisas que contribuem para a inércia. Em primeiro lugar, as atualizações de estatísticas podem não ser totalmente em tempo real devido a otimizações no serviço de contagem de mensagens. Em segundo lugar, existe um atraso entre o momento em que nosso valor da probabilidade de escolha de IP dedicado é calculado e distribuído em função do cache. No momento em que percebermos que a 350ª mensagem foi enviada e que é hora de parar, outras mais podem ter passado antes que a atualização tenha efeito.
Este é um exemplo prático, então sinta-se à vontade para colá-lo no go playground e fazer testes:
package mainrnrnimport (rn "fmt"rn "math/rand"rn "sync"rn "time"rn)rnrnvar (rn mutex = &sync.Mutex{}rn rnd = rand.New(rand.NewSource(99))rn messagesSent = 0 // keep track of the messages that IP sendsrn probability = 0.0 // probability of picking a dedicated IPrn)rnrnconst (rn sampleRateMsec = 50.0 // how often the system is being refreshedrn cap = 350.0 // this is how many messages we want to sendrn)rnrn// deliverySimulator will emulate the message sending process.rn// It will pick the dedicated IP based on the probability.rnfunc deliverySimulator() {rn for {rn mutex.Lock()rn if rnd.Float64() < probability {rn // We don't know how fast the messages arern // being submitted, let's throw somern // randomness in there to make it unpredictable.rn messagesSent += rnd.Intn(10)rn } else {rn // Shared IP will be picked here.rn }rn mutex.Unlock()rn time.Sleep(time.Millisecond)rn }rn}rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn if sent < cap {rn return 1rn }rn return 0rn}rnrnfunc main() {rn go deliverySimulator()rnrn // Control loop.rn for i := 0; i < 8; i++ {rn mutex.Lock()rnrn // Get messages.rn sent := messagesSentrnrn // Calculate probability.rn probability = calcProbabilityOfDedicated(sent)rnrn fmt.Println("sent:", sent, "probability:", probability)rn mutex.Unlock()rnrn time.Sleep(time.Duration(sampleRateMsec) * time.Millisecond)rn }rn}
Esta é a saída que obtemos:
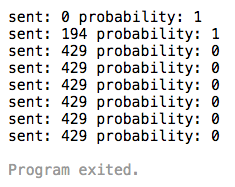
Ops, parece que enviamos muito mais mensagens do que queríamos; quase 25% a mais, na verdade. O que podemos fazer em relação a isso? Bem, podemos definir um limite para interrompê-lo com antecedência, mas isso precisaria ser diferente para cada cliente, já que todos eles enviam mensagens em taxas diferentes.
E se pudermos aceitar a inércia? E se pudéssemos desacelerar gradativamente?
Sistemas físicos
A inércia é muito comum no mundo físico. Para controlar sistemas mecânicos, a engenharia deve sempre levar a inércia em conta. Podemos aprender alguma coisa com eles?
As primeiras tentativas de criar um controlador automático para sistemas físicos datam do século 17 com o regulador centrífugo. Ele era uma peça essencial em qualquer máquina a vapor da época. Avançando para o início do século 20, a teoria por trás do controlador Proporcional, Integral e Derivativo (PID) foi desenvolvida após observar como os timoneiros controlavam navios levando em conta diversos fatores do ambiente e do sistema. Hoje em dia, os controladores PID são usados em todos os lugares, de drones quadricópteros a torradeiras, tudo isso porque são simples e muito eficazes. Obviamente, existem muitos outros algoritmos de controle, mas a maioria não é nem de perto tão elegante.
Um pouco de Teoria de Controle
Vamos falar sobre a teoria por trás dos controladores PID. Para começar, eles só funcionam quando existe um ciclo de feedback. Os ciclos de feedback são bem diretos, no sentido em que o resultado da ação de controle é redirecionado para a entrada do controlador. É como um ouroboros se o simbolismo mitológico ajudar, mas, se não ajudar, temos este diagrama.
+------------+Diagrama 1
input | | output
+------> | | +------>
| system |
control | | feedback
+------> | | +------+
| +------------+ |
| |
| +------------+ |
+------+ | controller | <------+
+------------+
Vamos dar uma olhada mais de perto no bloco do controlador e abri-lo.
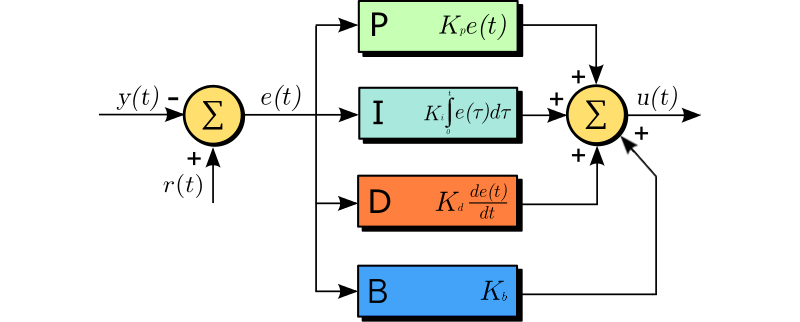
Nossa, é muita coisa. É um pouco complexo, então vamos por partes. Primeiro, precisamos entrar em acordo quanto à terminologia. Abaixo, alguns termos com os quais você precisa se familiarizar desde o início:
Variável de processo – y(t), o valor atual daquilo que queremos controlar. Em nosso caso, seria o número de mensagens enviadas por um IP e funcionará como o feedback.
Setpoint – r(t), o valor em que queremos chegar. No nosso exemplo, é o limite de 350 mensagens.
Erro – e(t), a diferença atual entre o setpoint e uma variável de processo. e(t) = r(t) – y(t).
Variável de controle – u(t), a saída do controlador, que impulsionará a nossa probabilidade de escolha de um IP dedicado.
Todas as variáveis são escritas como uma função f(t), ou seja, o valor delas muda em relação ao tempo t, portanto, é um valor exatamente naquele instante no tempo. O diagrama pode ser descrito pela clássica fórmula encontrada em qualquer livro didático sobre teoria de controle:
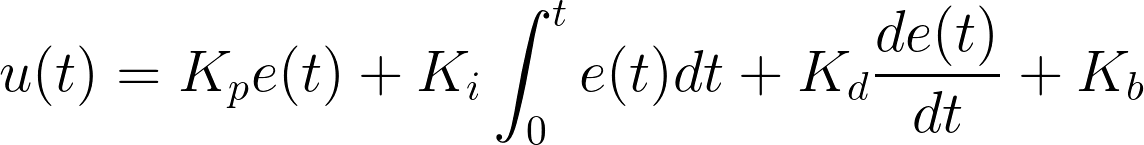
Há 4 termos nessa equação — proporcional + integral + derivativo + viés. Cada um deles contribui para o sinal de controle e o peso de suas contribuições pode ser definido pelos respectivos coeficientes: Kp, Ki, Kd e Kb.
O termo proporcional (bloco P do diagrama 2) é o termo mais importante da equação. Como o nome indica, ele é proporcional ao erro. Quanto maior o erro, maior será a força de controle aplicada ao sistema.
O termo integral (bloco I do diagrama 2) é útil para se chegar ao setpoint mais rapidamente. Ele acumula os erros ao longo do tempo e tenta ajudar o termo proporcional a corrigi-los. Mas ele tem uma desvantagem muito importante para o nosso caso de uso: a possibilidade de ultrapassar o limite (overshoot). A natureza do termo integral é de que ele demora a entrar em ação no começo, mas, quando há um acúmulo de erro suficiente ao longo do tempo, ele pode sobrecarregar o sistema e ultrapassar o setpoint. No cenário mais extremo, ele pode levar ao que chamamos de windup integral.
O termo derivativo (bloco D do diagrama 2) é proporcional à taxa de mudança. Conforme reduzimos o erro, o termo derivativo se torna, na verdade, negativo. Podemos pensar nisso como algo que vai nos desacelerar, caso nos aproximemos rápido demais do setpoint. Normalmente, ele resulta em uma mudança mais gradual da variável de processo.
O termo de viés (bloco B do diagrama 2) é apenas uma constante; não é usado com frequência, mas pode ser útil para continuar conduzindo o valor quando este estiver próximo ao setpoint. Nesse momento, o erro é pequeno e o termo proporcional não é tão acentuado.
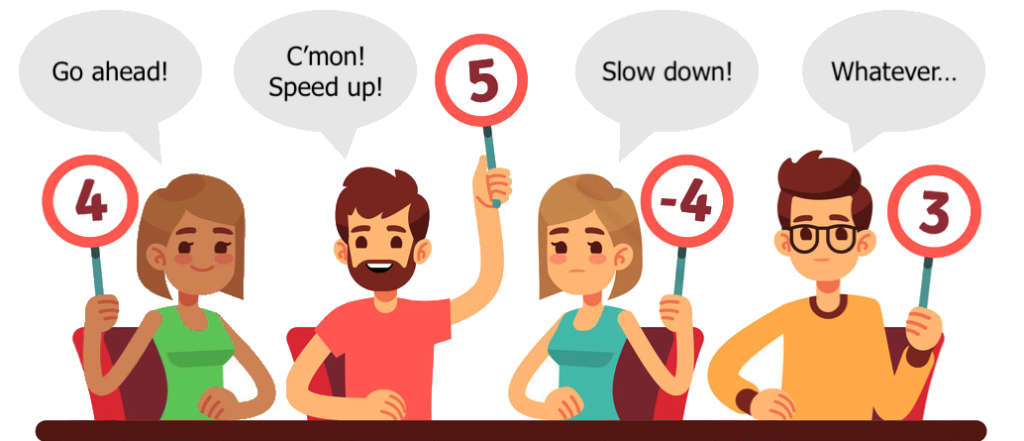
Pense nesses termos como se todos estivessem em um painel de jurados, votando para decidir qual deveria ser o próximo passo. O controlador age de acordo com as notas dadas por eles. Como possuem personalidades distintas, eles dão notas de formas um pouco diferentes. O proporcional é o juiz mais sensato e sempre dá uma nota maior quanto mais distantes estamos do setpoint. O integral fica impaciente caso não consigamos reduzir o erro por muito tempo, portanto ele dá uma nota maior com o passar do tempo. O derivativo é mais ansioso e dá uma nota negativa se o erro for reduzido rápido demais. O viés sempre dá a mesma nota, não importa o que aconteça.
Aplicando a teoria ao nosso problema
Agora que estamos familiarizados com a teoria, vamos aplicá-la. Podemos usar o ciclo de controle do exemplo anterior. Uma das coisas mais difíceis na hora de implementar isso é escolher os coeficientes de controle adequados. Ajustar o processo PID não é simples, e existem algumas técnicas disponíveis que podem nos ajudar com isso. Porém, descobrimos que a maneira mais rápida é criar um script de simulação e testar os parâmetros na prática. Eles podem não ser perfeitos, mas serão bons o suficiente para resolver o problema.
Veja como podemos pensar nos coeficientes em relação ao nosso problema.
O proporcional diminuirá a probabilidade de escolha de um IP dedicado quanto mais próximos estivermos do limite desejado. Portanto, no começo, o valor do termo é grande e cai para 0 à medida que enviamos mais mensagens.
O integral é delicado e pode nem ser necessário, visto que não temos como corrigir a ultrapassagem do limite. As mensagens não podem ser apagadas depois de serem enviadas.
O derivativo é muito importante. Ele nos ajudará a corrigir a situação em que as mensagens são enviadas rápido demais. Quando isso acontece, o termo fica grande o suficiente e passa a neutralizar outros termos. Como ele se torna negativo quando isso acontece, ele vai reduzir a probabilidade e, consequentemente, a quantidade de mensagens enviadas por um IP dedicado.
O viés pode ser muito útil se não pretendemos depender do termo integral. Quando chegamos muito perto do limite desejado, o termo proporcional ficará pequeno e não conseguirá impulsionar tanto o valor em direção a ele. É aí que o viés pode dar um empurrãozinho.
Agora que sabemos de tudo isso, podemos substituir calcProbabilityOfDedicated pelo seguinte código:
const (rn // These coefficients has been picked by trial-and-error.rn Kp = 0.42 // proportional coefficientrn Ki = 0.000001 // can be removed to simplify the algorn Kd = 1.2 // derivative coefficientrn Kb = 0.1 // fairly small in this examplern)rnrnvar (rn errorVal = 0.0rn prevError = 0.0rn integral = 0.0rn)rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn prevError = errorValrnrn // Calculate terms.rn errorVal = cap - float64(sent)rn integral = integral + (errorVal * float64(sampleRateMsec))rn derivative := (errorVal - prevError) / float64(sampleRateMsec)rnrn // Calculate PID control responsern probability := Kp*errorVal + Ki*integral + Kd*derivative + Kbrnrn // With given parameters the output is roughly within [0: 100]rn // Let's shape it to [0: 1]rn probability /= 100rn if probability > 1 {rn return 1rn }rn if probability < 0 {rn return 0rn }rnrn return probabilityrn}
Dessa forma, o resultado é o seguinte:
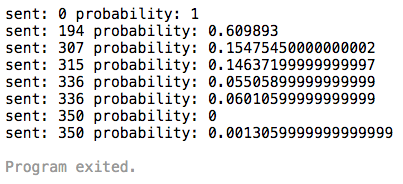
Como você pode ver, funciona perfeitamente. Aumentamos rapidamente para 300, diminuímos o ritmo, e logo chegamos a 350; depois, a probabilidade caiu para quase 0 naturalmente. Legal demais, né?!
Resultados
Na realidade, o algoritmo pode não definir o valor com tanta precisão, mas ele tem uma grande vantagem: pode ser distribuído facilmente. Imagine se um dos workers pega e bloqueia um IP, calcula a probabilidade, salva tudo e então passa para o próximo. Isso nos permite controlar o volume de milhares de IPs de forma simultânea.
Agora que resolvemos isso, podemos criar um plano de aquecimento. Ele consistiria em estágios, sendo que cada estágio tem uma quantidade máxima de mensagens atribuída a ele. À medida que avançamos nos estágios, esse volume máximo cresce e você tem liberdade para enviar cada vez mais mensagens. Isso permite enviar mensagens com a mesma velocidade a que você já se acostumou usando um IP compartilhado, enquanto vamos gradualmente aquecendo um IP dedicado novo.
Vamos ver como ele funciona em produção. Aqui plotamos o volume a cada estágio. Os valores desejados vêm do plano, e os reais (actual) são o que foi enviado.
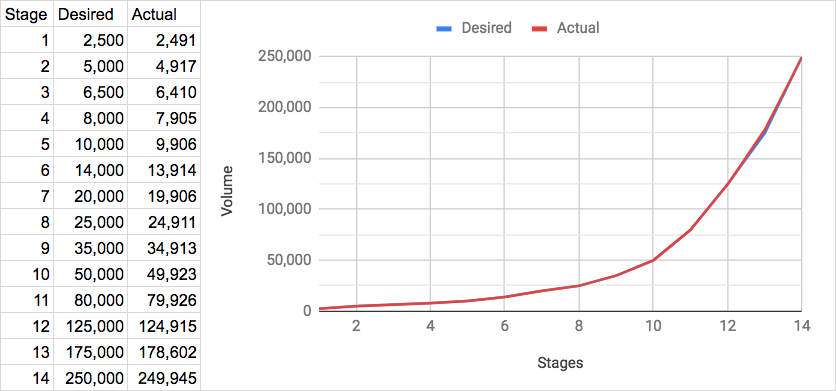
Tudo parece bem! Antes do lançamento, criamos um ambiente de simulação que nos permitiu testar diferentes cenários. Foi assim que conseguimos alinhar os valores dos coeficientes. Para nossa grande surpresa, tudo funcionou quando fizemos a implantação em produção pela primeira vez… Ah, se isso acontecesse em todas as implantações!