IT & Engineering
Qué podrían tener en común las tostadoras y los sistemas distribuidos

Hace unos meses lanzamos el calentamiento automático de IP, pero nunca llegamos a hablar de cómo se implementa. Hoy, vamos a echar un vistazo bajo el capó y tratar de entender qué hace funcionar a nuestro calentamiento de IP. Vamos a empezar con un poco de contexto, y luego nos sumergiremos en los detalles técnicos interesantes más adelante en la publicación.
¿Por qué es tan importante el calentamiento de IP?
Seamos realistas: a nadie le gusta recibir toneladas de información de golpe. Lo mismo puede decirse de los proveedores de servicios de email que reciben tus emails. Los spammers suelen lanzar sus campañas en un periodo corto de tiempo, por lo que a los proveedores no les gusta ese comportamiento. Para protegerse de abusos, bloquean los mensajes que provienen de una IP que nunca antes ha enviado un email. Algunos proveedores pueden seguir aceptando los mensajes, pero estos irán directos a spam. Eso no es bueno para nadie.
Para que esos mensajes lleguen a la bandeja de entrada, es mejor empezar enviando menos cantidad y aumentar el volumen con el tiempo para crear una reputación; por eso se llama “calentamiento”. Piensa en calentar el motor de un coche antes de pisar a fondo o en hacer ejercicios ligeros antes de levantar pesas en el gimnasio; es un poco así.
Cuando te registras regístrate para obtener una cuenta de Mailgun, recibes una IP compartida. Una IP compartida significa que la utilizan múltiples clientes, por lo que ya está calentada y tiene una buena reputación. No tienes que preocuparte por ello a menos que otro remitente haga que su reputación disminuya. Ahora quieres añadir una IP dedicada, y hemos hablado sobre por qué podrías querer eso a medida que crece tu volumen de envío. La IP dedicada que obtienes es nueva y no tiene reputación, por lo tanto, los proveedores de servicios de email no saben nada sobre ella. No las precalentamos porque queremos que tu IP esté vinculada a lo que envías y para que puedas construir tu propia reputación con el tiempo. Eso dará mejores resultados. ¿Significa eso que todavía tienes que enviar solo unos pocos mensajes desde el principio? Sí, sabemos que no es lo ideal.
Ahí es donde entra en juego el calentamiento automático de IP. Cuando se añade una IP dedicada, la IP compartida sigue permaneciendo en tu cuenta, por lo que podemos desviar el tráfico hacia ella durante el calentamiento. Con el tiempo, podemos aumentar el volumen poco a poco para enviar más y más mensajes hasta que la IP dedicada esté totalmente calentada y tengas todo listo para empezar.
Sin embargo, algo muy importante que debes recordar es que el proceso de calentamiento no te garantizará una gran entregabilidad. Las prácticas que incorporas como remitente son las que impulsan la entregabilidad, así que asegúrate de responsabilizarte de los mensajes que envías y de los destinatarios que los reciben. De lo contrario, solo estarás deteriorando lentamente la reputación de la dirección IP en lugar de quemarla al instante.
Plan de calentamiento
Hemos descubierto que los proveedores de servicios de email suelen preocuparse tanto por los volúmenes horarios como por los diarios. Cada día el volumen podría incrementarse un pequeño porcentaje. Esto resulta muy práctico porque este efecto compuesto conduce a un crecimiento exponencial y a la capacidad de aumentar el volumen en una cantidad de pasos relativamente pequeña. A estos pasos los llamamos “fases”. Las fases conforman un “plan de calentamiento”, que tiene este aspecto:
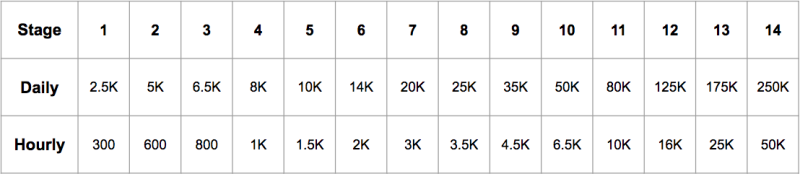
Si representamos las cantidades diarias, obtendremos la siguiente imagen:
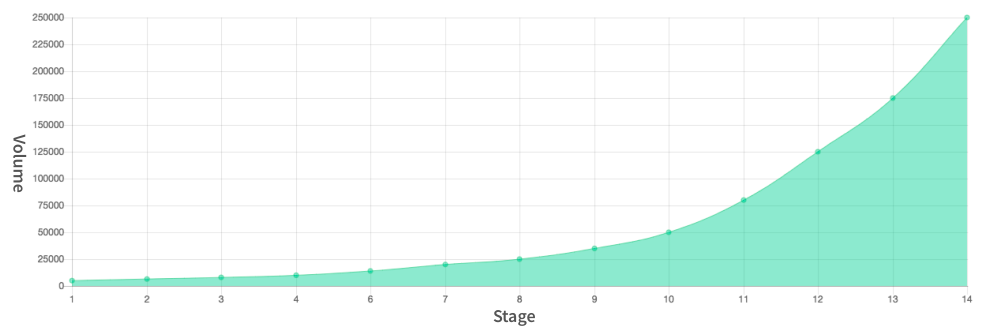
Consta de 14 fases y, en cada fase, enviamos una cierta cantidad de mensajes desde una IP dedicada. Ese volumen lo determinó cuidadosamente nuestro equipo de Entregabilidad a través de investigaciones y se actualiza periódicamente a medida que recopilamos nuevas pruebas. Resultó que enviar una cantidad adecuada de mensajes es un problema de ingeniería interesante, y nos gustaría compartir algunos detalles sobre cómo lo resolvimos.
Cómo mantener un volumen determinado
Sumerjámonos y echemos un vistazo más de cerca a la implementación de un algoritmo que nos permite enviar una cantidad determinada de mensajes. Ahora que tenemos una IP compartida y una IP dedicada juntas, debemos pensar en cómo equilibrar el tráfico entre ambas. La forma más fácil de hacerlo es implementar un algoritmo de equilibrio de carga aleatorio. Imagina que lanzamos una moneda para determinar desde qué IP se envía un mensaje: la IP compartida es “cara” y la IP dedicada es “cruz”. Si quisiéramos disminuir el número de mensajes procedentes de la IP dedicada, cambiaríamos la probabilidad de obtener “cruz” como resultado. Esto haría que nuestra moneda estuviera trucada, pero juega a nuestro favor. Así es como se vería en golang:
var rnd = rand.New(rand.NewSource(98))trnvar probabilityOfDedicated = 0.2rnif rnd.Float64() < probabilityOfDedicated {rn return "dedicated"rn}rnreturn "shared"
La probabilityOfDedicated puede tomar cualquier valor de coma flotante entre 0 y 1,0. Cuando es 1,0 todos los mensajes pasan por la IP dedicada y cuando es 0 todo pasa por la compartida. Ajustarlo a 0,5 nos dará las mismas probabilidades de enviarlo a través de la IP dedicada o de la IP compartida. En esencia, es un mando que controla el flujo de envío. Veamos cómo podemos mantener una tasa de 350 mensajes por hora desde la IP dedicada al actualizar ese valor. Lo más sencillo que se nos ocurre es ajustar la probabilityOfDedicated a 1 y, una vez que se alcance la marca de 350 mensajes, restablecer el valor a 0. Es un poco brusco, pero debería funcionar.
const cap = 350rnfunc getProbabilityOfDedicated(sentMessages int) float64 {rn if sentMessages < cap {rn return 1rn }rn return 0rn}
¿Es realmente así de simple?
Cuando queremos ejecutar un programa en cientos de servidores procesando cientos de miles de solicitudes por segundo, no podemos esperar que todo se actualice siempre en tiempo real. Las técnicas de optimización como el procesamiento por lotes y el almacenamiento en caché se convierten en nuestros mejores amigos. Son excelentes para lo que se diseñaron, pero inevitablemente añaden un retraso entre el momento en que se calcula un valor, se actualiza y se comparte en todos los nodos de un clúster. Llamemos a ese retraso “inercia” a partir de ahora.
Hablando de nuestro ejemplo, hay muchas cosas que contribuyen a la inercia. En primer lugar, es posible que las actualizaciones de estadísticas no sean verdaderamente en tiempo real debido a las optimizaciones en el servicio de recuento de mensajes. En segundo lugar, hay un retraso entre el momento en que se calcula y se distribuye nuestro valor de la probabilidad de elegir una IP dedicada debido al almacenamiento en caché. Para cuando vemos que se ha enviado el mensaje número 350 y que es hora de parar, podrían colarse más antes de que la actualización surta efecto.
Este es un ejemplo funcional, así que no dudes en pegarlo en go playground y jugar con él:
package mainrnrnimport (rn "fmt"rn "math/rand"rn "sync"rn "time"rn)rnrnvar (rn mutex = &sync.Mutex{}rn rnd = rand.New(rand.NewSource(99))rn messagesSent = 0 // keep track of the messages that IP sendsrn probability = 0.0 // probability of picking a dedicated IPrn)rnrnconst (rn sampleRateMsec = 50.0 // how often the system is being refreshedrn cap = 350.0 // this is how many messages we want to sendrn)rnrn// deliverySimulator will emulate the message sending process.rn// It will pick the dedicated IP based on the probability.rnfunc deliverySimulator() {rn for {rn mutex.Lock()rn if rnd.Float64() < probability {rn // We don't know how fast the messages arern // being submitted, let's throw somern // randomness in there to make it unpredictable.rn messagesSent += rnd.Intn(10)rn } else {rn // Shared IP will be picked here.rn }rn mutex.Unlock()rn time.Sleep(time.Millisecond)rn }rn}rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn if sent < cap {rn return 1rn }rn return 0rn}rnrnfunc main() {rn go deliverySimulator()rnrn // Control loop.rn for i := 0; i < 8; i++ {rn mutex.Lock()rnrn // Get messages.rn sent := messagesSentrnrn // Calculate probability.rn probability = calcProbabilityOfDedicated(sent)rnrn fmt.Println("sent:", sent, "probability:", probability)rn mutex.Unlock()rnrn time.Sleep(time.Duration(sampleRateMsec) * time.Millisecond)rn }rn}
Este es el resultado que obtenemos:
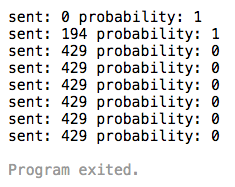
Vaya, parece que enviamos muchos más mensajes de los que queríamos; casi un 25 % más, de hecho. ¿Qué podemos hacer al respecto? Bueno, podemos idear un umbral para detenerlo con antelación, pero tendría que ser diferente para cada cliente, ya que envían mensajes a diferentes ritmos.
¿Y si pudiéramos sacar partido de la inercia? ¿Y si pudiéramos reducir la velocidad gradualmente?
Sistemas físicos
La inercia es muy común en el mundo físico. Para controlar los sistemas mecánicos, el personal de ingeniería siempre tiene que tener en cuenta la inercia. ¿Podemos aprender algo de ello?
Los primeros intentos de crear un controlador automático para sistemas físicos se remontan al siglo XVII con el regulador centrífugo. Era una parte esencial de cualquier máquina de vapor en esa época. Avanzamos rápido hasta principios del siglo XX, cuando la teoría detrás del controlador proporcional, integral y derivativo (PID) se desarrolló tras observar cómo las personas al timón controlan los barcos teniendo en cuenta diferentes factores ambientales y del sistema. Hoy en día los controladores PID se utilizan en todas partes, desde cuadricópteros hasta tostadoras, y es porque son muy simples y eficaces. Por supuesto, existen muchos otros algoritmos de control, pero la mayoría no son ni de lejos tan elegantes.
Un poco de teoría de control
Hablemos de la teoría que hay detrás de los controladores PID. Para empezar, solo funcionan cuando hay un bucle de retroalimentación. Los bucles de retroalimentación son bastante sencillos, en el sentido de que el resultado de la acción de control se reenvía a la entrada del controlador. Es como un uróboros si el simbolismo mitológico ayuda, y si no, aquí tienes este diagrama.
+------------+Diagrama 1
input | | output
+------> | | +------>
| system |
control | | feedback
+------> | | +------+
| +------------+ |
| |
| +------------+ |
+------+ | controller | <------+
+------------+
Echemos un vistazo más de cerca al bloque del controlador y abrámoslo.
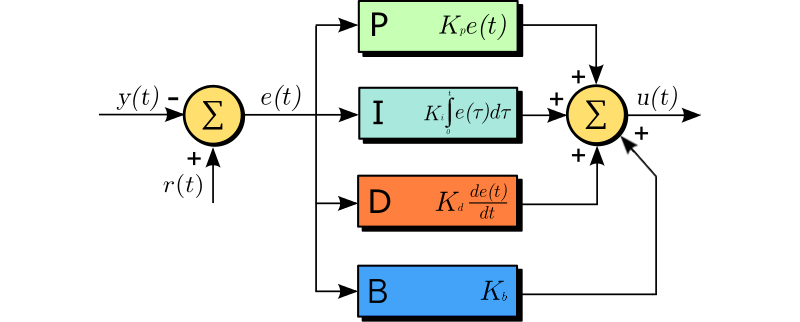
Vaya, eso es mucho. Es un poco abrumador, así que vamos a desglosarlo un poco. Primero, tenemos que ponernos de acuerdo sobre la terminología. Aquí tienes algunos términos con los que conviene familiarizarse antes de empezar:
Variable de proceso – y(t), el valor actual de lo que queremos controlar. En nuestro caso, sería el número de mensajes enviados desde una IP y servirá como retroalimentación.
Punto de consigna – r(t), el valor que queremos alcanzar. En nuestro ejemplo, es el límite de 350 mensajes.
Error – e(t), la diferencia actual entre un punto de consigna y una variable de proceso. e(t) = r(t) – y(t).
Variable de control – u(t), la salida del controlador; esto impulsará nuestra probabilidad de elegir una IP dedicada.
Todas las variables se escriben como una función f(t), lo que significa que su valor cambia en relación con el tiempo t, por lo que es un valor en ese preciso instante de tiempo. El diagrama puede describirse mediante la fórmula clásica de cualquier libro de texto sobre teoría de control:
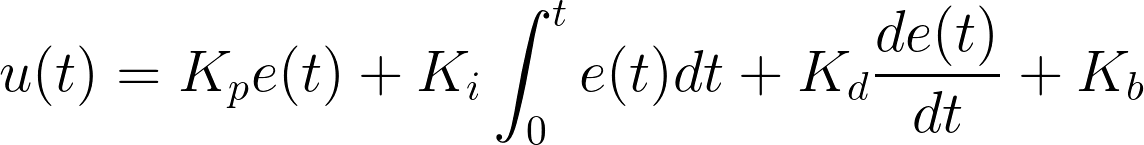
Hay cuatro términos en esta ecuación: proporcional + integral + derivativo + sesgo. Cada uno de ellos contribuye a la señal de control y el peso de sus contribuciones puede establecerse mediante los coeficientes respectivos: Kp, Ki, Kd y Kb.
El término proporcional (bloque P del diagrama 2) es el término más importante de la ecuación. Como su nombre indica, es proporcional al error. Cuanto mayor sea el error, mayor fuerza de control se aplicará al sistema.
El término integral (bloque I del diagrama 2) es útil para llegar más rápido al punto de consigna. Acumula los errores con el tiempo e intenta ayudar al término proporcional a corregirlos. Sin embargo, tiene un inconveniente muy importante para nuestro caso de uso: el posible sobreimpulso. La naturaleza del término integral es que tarda en entrar en acción al principio, pero cuando se acumula suficiente error a lo largo del tiempo puede poner el sistema a toda marcha superando el punto de consigna. En el caso más extremo, puede dar lugar a lo que se conoce como saturación integral.
El término derivativo (bloque D del diagrama 2) es proporcional a la tasa de cambio. A medida que reducimos el error, el término derivativo se vuelve realmente negativo. Podemos pensar en ello como si, al acercarnos demasiado rápido al punto de consigna, nos frenara. Por lo general, da lugar a un cambio más gradual de la variable de proceso.
El término de sesgo (bloque B del diagrama 2) es solo una constante; no se usa a menudo, pero puede ser útil para seguir impulsando el valor cuando está cerca del punto de consigna. En ese momento, el error es pequeño y el término proporcional no es tan pronunciado.
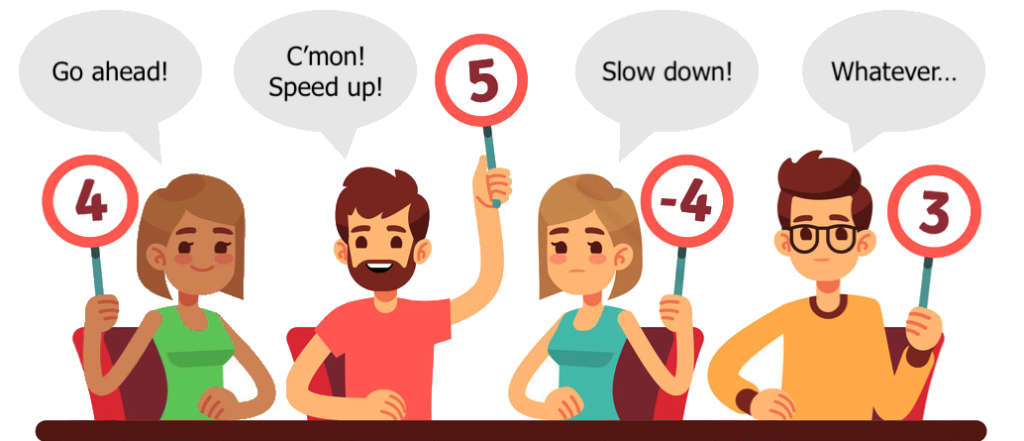
Piensa en estos términos como si estuvieran todos en un jurado votando la decisión de cuál debería ser el siguiente paso. El controlador actúa basándose en las puntuaciones que otorgan. Como tienen personalidades diferentes, todos puntúan de forma un poco distinta. El proporcional es el juez más razonable y siempre da una puntuación mayor cuanto más lejos estemos del punto de consigna. El integral se impacienta si no reducimos el error durante demasiado tiempo, por lo que su puntuación aumenta a medida que pasa el tiempo. El derivativo siempre está nervioso y puntúa negativamente si el error se reduce demasiado deprisa. El sesgo siempre da la misma puntuación pase lo que pase.
Aplicación de la teoría a nuestro problema
Ahora que ya conocemos la teoría, vamos a aplicarla. Podemos utilizar el bucle de control existente del ejemplo anterior. Una de las cosas más difíciles al implementar esto es elegir los coeficientes de control adecuados. Ajustar el proceso PID no es sencillo, y hay algunas técnicas disponibles que pueden ayudarnos con eso. Sin embargo, hemos descubierto que la forma más rápida es crear un script de simulación y jugar con los parámetros. Puede que no sean perfectos, pero serán lo bastante buenos para resolver el problema.
Así es como podríamos enfocar los coeficientes con respecto a nuestro problema.
El proporcional reducirá la probabilidad de elegir una IP dedicada cuanto más cerca estemos del límite deseado. Por tanto, cuando empezamos, el valor del término es grande y se reduce a 0 a medida que enviamos más y más mensajes.
El integral es complicado y es posible que ni siquiera lo necesitemos, ya que no podemos corregir el sobreimpulso. Los mensajes no se pueden eliminar una vez que se envían.
El derivativo es muy importante. Nos ayudará a corregir la situación en la que los mensajes se envían demasiado rápido. Cuando eso ocurre, el término se hace lo suficientemente grande y empieza a contrarrestar a otros términos. Dado que es negativo cuando eso sucede, reducirá la probabilidad y, a su vez, reducirá la cantidad de mensajes que se envían desde una IP dedicada.
El sesgo podría ser muy útil si no planeamos depender del término integral. Cuando nos acerquemos mucho al límite deseado, el término proporcional será pequeño y no podrá empujar el valor hacia él con tanta fuerza. Ahí es cuando el sesgo podría darle un pequeño empujón.
Ahora que sabemos todo eso, podemos reemplazar calcProbabilityOfDedicated con el siguiente código:
const (rn // These coefficients has been picked by trial-and-error.rn Kp = 0.42 // proportional coefficientrn Ki = 0.000001 // can be removed to simplify the algorn Kd = 1.2 // derivative coefficientrn Kb = 0.1 // fairly small in this examplern)rnrnvar (rn errorVal = 0.0rn prevError = 0.0rn integral = 0.0rn)rnrnfunc calcProbabilityOfDedicated(sent int) float64 {rn prevError = errorValrnrn // Calculate terms.rn errorVal = cap - float64(sent)rn integral = integral + (errorVal * float64(sampleRateMsec))rn derivative := (errorVal - prevError) / float64(sampleRateMsec)rnrn // Calculate PID control responsern probability := Kp*errorVal + Ki*integral + Kd*derivative + Kbrnrn // With given parameters the output is roughly within [0: 100]rn // Let's shape it to [0: 1]rn probability /= 100rn if probability > 1 {rn return 1rn }rn if probability < 0 {rn return 0rn }rnrn return probabilityrn}
Así que obtenemos esto:
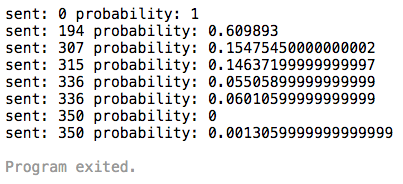
Como puedes ver, funciona a las mil maravillas. Rápidamente aumentamos a 300, redujimos la velocidad y, finalmente, llegamos a 350; luego la probabilidad bajó cerca de 0 de forma natural. ¿No es genial?
Resultados
En realidad, puede que el algoritmo no establezca el valor con precisión, pero tiene una gran ventaja: se puede distribuir fácilmente. Imagina que uno de los workers toma y bloquea una IP, calcula la probabilidad, la guarda y luego pasa a la siguiente. Esto nos permite controlar el volumen de miles de IP simultáneamente.
Ahora que tenemos eso resuelto, podemos crear un plan de calentamiento. Consistiría en fases, donde cada fase tiene asignada una cantidad máxima de mensajes. A medida que avanzamos por las fases, este volumen máximo aumenta y tienes la libertad de enviar cada vez más mensajes. Esto te brinda la capacidad de enviar tan rápido como acostumbras desde una IP compartida, mientras nosotros calentamos gradualmente una IP dedicada nueva.
Veamos cómo funciona en producción. Aquí representamos el volumen en cada fase. Los valores deseados proceden del plan y los reales son los que se enviaron.
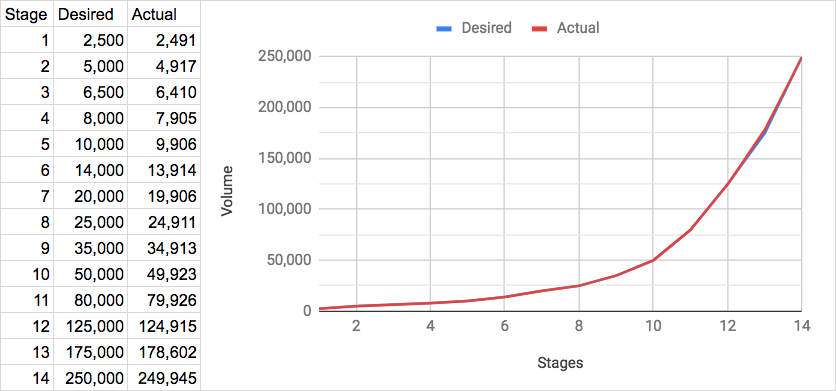
¡Tiene buena pinta! Antes de lanzarlo, creamos un entorno de simulación que nos permitió probar diferentes escenarios. Así es como logramos cuadrar los valores de los coeficientes. Para nuestra gran sorpresa, funcionó cuando lo desplegamos en producción por primera vez… ¡ojalá ocurriera lo mismo con todos los despliegues!