Product
Unsere E-Mail-Signatur-Parsing-Bibliothek ist jetzt Open Source

Bereits im Jahr 2011 baten uns mehrere Kunden um eine High-Level-API zum Parsen von Nachrichten, mit der sie Signaturen und Zitate aus einer E-Mail entfernen konnten, wie Sie unten sehen:
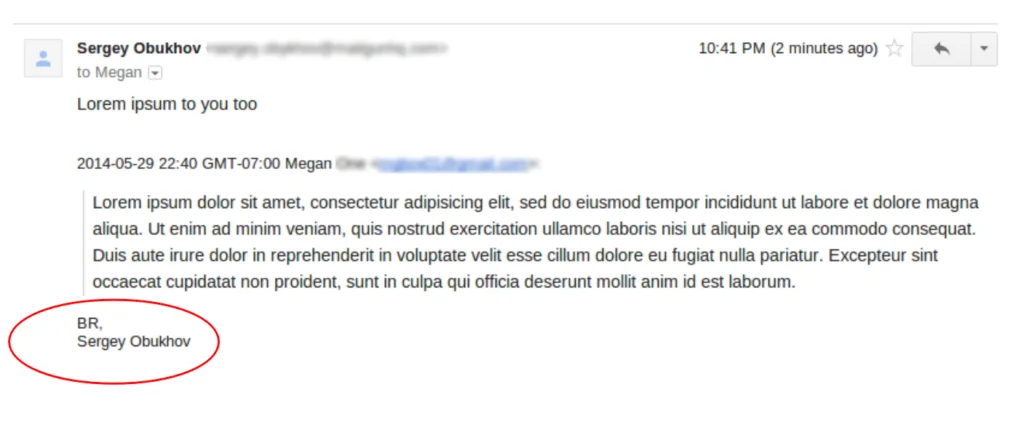
Das Problem
Was für Menschen einfach ist, stellt für Maschinen eine ziemliche Herausforderung dar. Einer der Hauptgründe dafür ist, dass es kein Standardformat für eine E-Mail-Nachricht gibt. Verschiedene E-Mail-Clients verfassen Antworten auf unterschiedliche Weise, und selbst innerhalb desselben E-Mail-Clients ändern Absender das Format nach Belieben. So platzieren Nutzer ihre Antwort beispielsweise nach dem Zitat der ursprünglichen Nachricht (Bottom-Posting):
Am Mittwoch um 10:01 Uhr schrieb Danny:
> Übrigens, welche Systeme werden aktualisiert? Ich hatte einige Netzwerk-
> probleme nach dem Update von letzter Woche.  Muss ich neu starten?
Nein, Sie müssen nicht neu starten.
vor der zitierten Originalnachricht (Top-Posting):
Nein, Sie müssen nicht neu starten.

-------- Originalnachricht --------

Von: Danny

Gesendet: Dienstag, 16. Oktober 2007 10:01 Uhr

An: Jim

Betreff: AW: Job

Übrigens, welche Systeme werden aktualisiert? Ich hatte einige Netzwerk-

probleme nach dem Update von letzter Woche.  Muss ich neu starten?
oder verschachteln ihre Antwort sogar:
> Können Sie Ihren Bericht eine Stunde später präsentieren?
Ja, das ist möglich. Die Zusammenfassung wird bis spätestens 17:00 Uhr verschickt.
Jim
Am Mittwoch um 10:01 Uhr schrieb Danny:
>> 14:00 Uhr: Bericht präsentieren
> Jim, ich habe zu dieser Zeit ein Meeting. Können Sie Ihren Bericht eine Stunde später präsentieren?
Tatsächlich gibt es so viele verschiedene Möglichkeiten zu antworten, dass es sogar einen Wikipedia-Artikel darüber gibt. All dies macht das Parsen des Textkörpers einer E-Mail zu einer anspruchsvollen Aufgabe.
Selbst mit maschinellem Lernen mussten wir die Dinge ständig anpassen. Die E-Mail-Formatierung ändert sich ständig, E-Mail-Clients auf Smartphones führen neue Signaturen wie „Von meinem XXX-Telefon gesendet“ ein, neue Sonderfälle werden entdeckt usw.
Hier ist ein einfaches Beispiel. Früher wurden alle E-Mail-Signaturen durch Bindestriche getrennt:
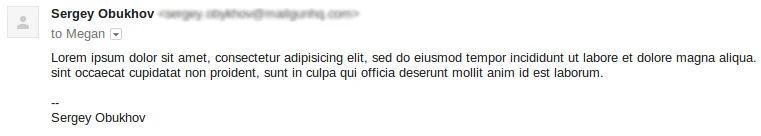
Das Erste, was einem also in den Sinn kommt, ist das Schreiben eines regulären Ausdrucks (Regex), um Bindestriche als Signaturtrenner zu erkennen und die Zeilen danach als Signatur zu extrahieren:
>>> signature = regex.match("^[s]*--*[s]*[a-z .]*$).*", message)
Doch ehe man sich versieht, erhält man eine E-Mail wie diese:
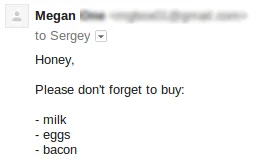
Und der Parser schneidet den wichtigsten Teil der E-Mail ab. Dies ist ein sehr einfaches Beispiel und lässt sich leicht umgehen. Aber in der Praxis werden die Dinge viel komplizierter und kniffliger.
Unsere Lösung
Wir haben intensiv recherchiert, uns alle E-Mail-Variationen angesehen, die Mailgun durchlaufen, und eine Lösung entwickelt, die auf Techniken des maschinellen Lernens basiert. Diese Lösung ist nun seit einigen Jahren in der Produktion und wird ständig um Fehlerbehebungen und Verbesserungen ergänzt. Insgesamt haben wir positives Feedback von unserer Kundschaft erhalten, obwohl Entwickelnde natürlich gerne auf Verbesserungspotenzial hinweisen.
Jetzt haben Sie alle die Möglichkeit, zur Verbesserung dieser Lösung beizutragen. Aufgrund der sich ständig verändernden und dezentralen E-Mail-Landschaft haben wir beschlossen, dieses Problem mit einer dezentralisierten Lösung anzugehen: Wir machen unsere Bibliothek Open Source, damit wir gemeinsam daran arbeiten können.
Wir nennen unsere neue Bibliothek talon nach einem Mehrzweckroboter, der für Missionen von der Aufklärung bis zum Kampf konzipiert ist und in zahlreichen feindlichen Umgebungen eingesetzt wird.
Falls Sie sofort mit dem Testen beginnen möchten, haben wir eine einfache Demo-App und eine Schnellstart-Anleitung für Sie vorbereitet. Andernfalls lesen Sie weiter, um einen allgemeineren Überblick, unsere Ansätze und Bewertungsergebnisse zu erhalten.
So sehen die gängigsten Workflows aus:
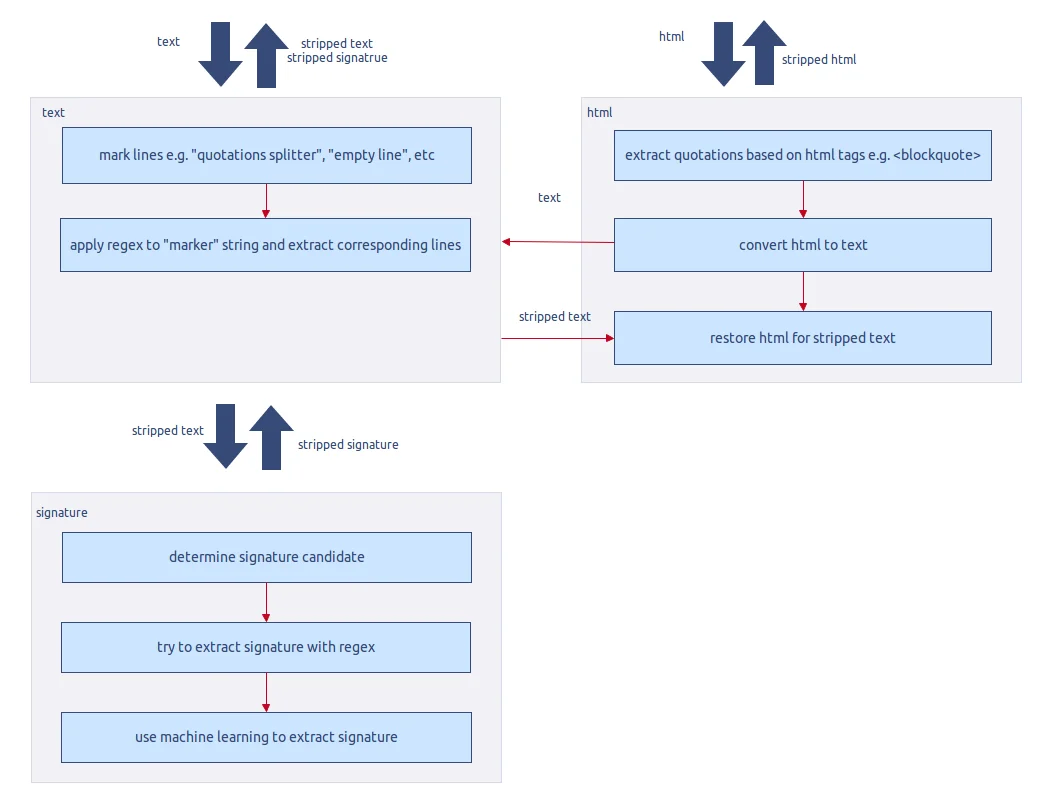
Derzeit nutzen wir maschinelles Lernen nur zur Klassifizierung von Signaturzeilen. Der Rest der Bibliothek besteht aus verschiedenen Heuristiken und Plausibilitätsprüfungen, die wir bei der Bearbeitung von Support-Tickets und der Analyse von Nachrichtenformatierungsmustern und -trends entwickelt haben.
Der Teil der Bibliothek für maschinelles Lernen ist von den folgenden Forschungsarbeiten inspiriert:
- http://www.cs.cmu.edu/~vitor/papers/sigFilePaper_finalversion.pdf
- http://www.cs.cornell.edu/people/tj/publications/joachims_01a.pdf
Zur Klassifizierung von Signaturzeilen haben wir SVM mit linearem Kernel verwendet. Zur Bewertung unserer Klassifikatoren nutzten wir die 5-fache Kreuzvalidierung:
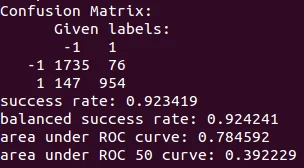
Der Datensatz bestand aus 2.912 E-Mail-Zeilen. Von 1.030 Signaturzeilen wurden 954 korrekt klassifiziert. Von 1.882 Nicht-Signaturzeilen wurden 147 fälschlicherweise als Signatur eingestuft. Insgesamt ergibt dies eine Erfolgsquote von 92 % und eine Fläche unter der ROC-Kurve von 78 %. Dies lässt sich entsprechend als hervorragend beziehungsweise angemessen bewerten.
Als wir die Bibliothek für das Outsourcing modifizierten, versuchten wir, ein stabiles Grundgerüst bereitzustellen und gleichzeitig die Möglichkeit zu bieten, problemlos weitere Funktionen hinzuzufügen. Aus Erfahrung wissen wir, dass reguläre Ausdrücke für Zitate / Signaturtrenner und die Extraktion von HTML-Zitaten durch HTML-Tags die Bereiche sind, die am meisten Aufmerksamkeit erfordern. Sie sind jedoch herzlich eingeladen, zu jedem beliebigen Teil der Bibliothek beizutragen.
Wir hoffen, dass Sie die Bibliothek nützlich finden und sie Ihren Alltag erleichtert.
Viel Spaß beim Versenden.