Product
Passage en open source de notre bibliothèque d’analyse de signatures d’email

En 2011, plusieurs clients nous ont demandé une API d’analyse de messages de haut niveau pour extraire les signatures et les citations d’un email, comme ci-dessous :
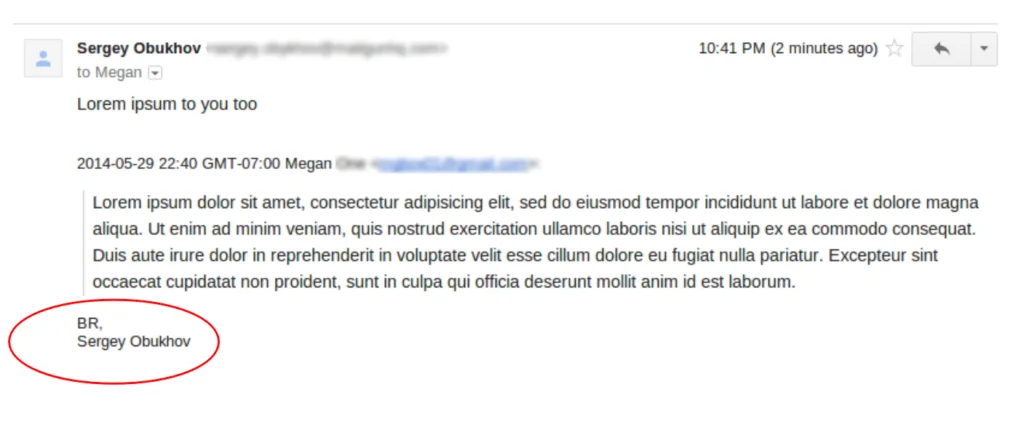
Le problème
Bien que simple pour les humains, il s’agit en réalité d’une tâche assez complexe pour les machines. L’une des raisons principales est qu’il n’existe aucun format standard pour un message d’email. Les différents clients de messagerie rédigent les réponses de différentes manières et, même au sein d’un même client de messagerie, l’expéditeur peut modifier le format comme bon lui semble. Par exemple, les utilisateurs peuvent placer leur réponse après avoir cité le message d’origine (réponse en bas) :
À 10 h 01 mercredi, Danny a écrit :
> Au fait, quels systèmes seront mis à jour ? J'ai eu quelques problèmes
> de réseau après la mise à jour de la semaine dernière.  Devrai-je redémarrer ?
Non, vous n'aurez pas besoin de redémarrer.
avant le message d’origine cité (réponse en haut) :
Non, vous n'aurez pas besoin de redémarrer.

-------- Message d'origine --------

De : Danny

Envoyé : mardi 16 octobre 2007 à 10 h 01

À : Jim

Objet : RE: Emploi

Au fait, quels systèmes seront mis à jour ? J'ai eu quelques problèmes

de réseau après la mise à jour de la semaine dernière.  Devrai-je redémarrer ?
ou même intercaler leur réponse :
> Pouvez-vous présenter votre rapport une heure plus tard ?
Oui, c'est possible. Le résumé sera envoyé au plus tard à 17 h.
Jim
À 10 h 01 mercredi, Danny a écrit :
>> 14 h : Présenter le rapport
> Jim, j'ai une réunion à cette heure-là. Pouvez-vous présenter votre rapport une heure plus tard ?
En fait, il existe tellement de manières différentes de répondre qu’il y a même un article Wikipédia à ce sujet ! Tout cela rend l’analyse du corps d’un email particulièrement complexe.
Même avec l’apprentissage automatique, nous avons dû constamment faire des ajustements. Le formatage des emails change en permanence, les clients de messagerie pour mobiles introduisent de nouvelles signatures telles que « Envoyé depuis votre téléphone XXX », de nouveaux cas particuliers sont découverts, etc.
Voici un exemple simple. À l’époque, toutes les signatures d’emails étaient séparées par des tirets :
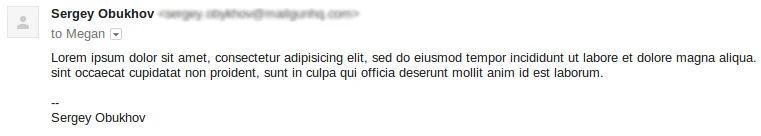
La première chose qui vient donc à l’esprit est d’écrire une expression régulière pour détecter les tirets comme séparateurs de signature et d’extraire les lignes suivantes en tant que signature :
>>> signature = regex.match("^[s]*--*[s]*[a-z .]*$).*", message)
Mais l’instant d’après, vous recevez un email comme celui-ci :
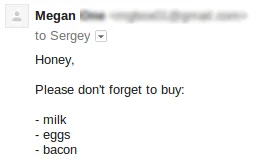
Et votre analyseur supprime la partie la plus importante de l’email. C’est un exemple très simple que vous pourriez facilement contourner. Mais dans la réalité, les choses deviennent beaucoup plus complexes et délicates.
Notre solution
Nous avons effectué de nombreuses recherches, examiné toutes les variations d’emails qui transitent par Mailgun et avons élaboré une solution basée sur des techniques d’apprentissage automatique. Cette solution est en production depuis plusieurs années maintenant, et fait l’objet de corrections de bugs et d’améliorations. Dans l’ensemble, les retours des clients sont positifs, bien que les développeurs aient naturellement tendance à souligner les points à améliorer.
Désormais, vous avez l’occasion de contribuer à l’amélioration de cette solution. En raison du paysage de l’email qui évolue constamment et de manière décentralisée, nous avons décidé d’aborder ce problème avec une approche collaborative : nous passons notre bibliothèque en open source afin de pouvoir y travailler ensemble !
Nous avons baptisé notre nouvelle bibliothèque talon en référence à un robot polyvalent conçu pour effectuer des missions allant de la reconnaissance au combat, et pour opérer dans un certain nombre d’environnements hostiles.
Si vous souhaitez commencer à la tester immédiatement, nous avons préparé une simple application de démonstration ainsi qu’un guide de démarrage rapide rien que pour vous. Sinon, poursuivez votre lecture pour obtenir un aperçu plus général, découvrir les approches que nous avons adoptées et consulter les résultats de l’évaluation.
Voici à quoi ressemblent les flux de travail les plus courants :
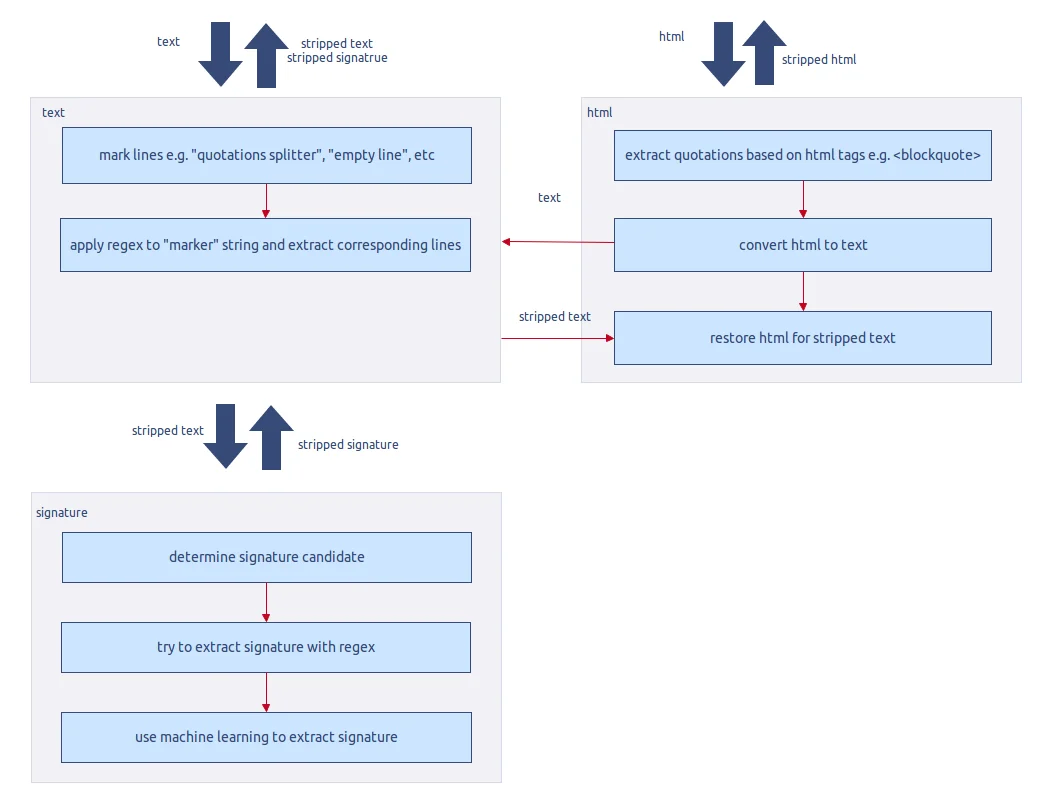
Actuellement, nous n’utilisons l’apprentissage automatique que pour classifier les lignes de signature. Le reste de la bibliothèque se compose de diverses méthodes heuristiques et vérifications de cohérence que nous avons élaborées en traitant des tickets de support et en analysant les modèles et tendances de formatage des messages.
La partie apprentissage automatique de la bibliothèque s’inspire des travaux de recherche suivants :
- http://www.cs.cmu.edu/~vitor/papers/sigFilePaper_finalversion.pdf
- http://www.cs.cornell.edu/people/tj/publications/joachims_01a.pdf
Pour classifier les lignes de signature, nous avons utilisé les SVM avec un noyau linéaire. Pour évaluer nos classificateurs, nous avons utilisé la validation croisée à 5 blocs:
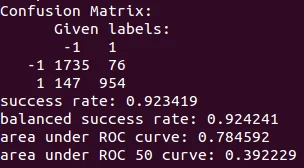
Le jeu de données comprenait 2 912 lignes d’emails. Sur 1 030 lignes de signature, 954 ont été classées correctement. Sur 1 882 lignes sans signature, 147 ont été confondues avec des signatures. Dans l’ensemble, cela nous donne un taux de réussite de 92 % et une aire sous la courbe ROC de 78 %. Ce qui peut être considéré respectivement comme excellent et satisfaisant.
Lorsque nous avons modifié la bibliothèque pour la passer en open source, nous avons essayé de fournir une structure solide tout en facilitant l’ajout de nouveaux éléments. Par expérience, les parties qui nécessitent le plus d’attention sont les expressions régulières pour les séparateurs de citations et de signatures, ainsi que l’extraction de citations HTML via les balises HTML. Cependant, n’hésitez pas à contribuer à n’importe quelle partie de la bibliothèque de votre choix.
Nous espérons que vous trouverez cette bibliothèque utile et qu’elle vous facilitera la vie.
Bons envois !