Product
Cómo y por qué adoptamos una arquitectura service mesh con Vulcand y Nginx

Durante el último año, la arquitectura service mesh se ha consolidado gracias al lanzamiento de Istio (una colaboración conjunta entre IBM, Google y Lyft) y a la adopción de linkerd por parte de grandes empresas como PayPal y Ticketmaster.
Entonces, ¿qué es una arquitectura service mesh, por qué la hemos adoptado en Mailgun y cómo la utilizamos para ofrecer nuestro software?
Qué es una arquitectura service mesh y por qué usarla
En pocas palabras, una arquitectura service mesh es un componente de software (generalmente un proxy) que gestiona la comunicación entre servicios de forma rápida y resiliente. Supongamos que soy un servicio de usuarios basado en HTTP y quiero contactar con el servicio de cuentas para verificar a un usuario. En una arquitectura típica sin red de servicios, el servicio de usuarios haría una solicitud a , que enrutaría la solicitud directamente al balanceador de carga del servicio, que a su vez canaliza la solicitud al nodo de servicio de cuenta, satisfaciendo así la solicitud.
En una arquitectura service mesh, el servicio de usuarios hace una solicitud HTTP a , que gestiona el proxy local de service mesh. El proxy local sabe que las solicitudes a “/accounts” las gestiona el “account-service”, por lo que enruta la solicitud a un nodo de la malla que esté ejecutando una instancia de “account-service”.
La principal ventaja de la arquitectura service mesh es que permite una alta resiliencia (ningún balanceador de carga es un punto único de fallo), un descubrimiento de servicios integrado y lanzamientos sin tiempo de inactividad. La mayoría de las implementaciones modernas de service mesh ofrecen muchas más funciones, pero estos factores fueron nuestra principal motivación para adoptar una arquitectura service mesh.
Dónde entra en juego Vulcand
En 2014, nadie había oído hablar de la arquitectura service mesh. Cuando empezamos con vulcand, queríamos crear un proxy inverso de alto rendimiento que proporcionara un bloqueo inteligente de solicitudes y nos permitiera añadir y eliminar servicios backend dinámicamente sobre la marcha para conseguir implementaciones sin tiempo de inactividad. Desde luego, no nos propusimos crear un enrutador para service mesh.
Pero poco después, empezamos a preguntarnos qué pasaría si, en lugar de ejecutar vulcand como un balanceador de carga front-end tradicional, hiciéramos que todos nuestros servicios se comunicaran entre sí a través de la instancia local de vulcand.
Rápidamente nos dimos cuenta de la gran libertad que esto nos daría. Utilizar vulcand de este modo evitaría balanceadores de carga adicionales, proporcionaría lanzamientos sin tiempo de inactividad, aumentaría la resiliencia y facilitaría el descubrimiento de servicios. Habíamos creado sin darnos cuenta lo que la industria acabaría llamando service mesh.
Cómo gestiona Mailgun las rutas de service mesh
Existen dos enfoques para gestionar las rutas de service mesh. Un modelo de gobernanza centralizada y un modelo distribuido sin gobernanza.
En un modelo de gobernanza centralizada, la configuración de las rutas se almacena y gestiona de forma centralizada, generalmente por un arquitecto designado por la empresa cuyo trabajo es garantizar la coherencia de las rutas de API, resolver conflictos de enrutamiento en toda la red de servicios, establecer prioridades y enrutar destinos.
Con el modelo distribuido, cada propietario de servicio determina qué rutas ofrece su servicio, a menudo utilizando un prefijo de ruta para evitar conflictos (p. ej., “/service-1/users” no entraría en conflicto con “/service-2/users”).
En Mailgun, hemos adoptado el modelo distribuido sin gobernanza, por lo que cada servicio se encarga de informar a vulcand sobre las rutas que proporciona. Los servicios lo hacen registrando sus rutas en vulcand a través de etcd durante el inicio del servicio. Si mi servicio gestiona las solicitudes de “/users”, registraría esta ruta en vulcand. Con esta ruta configurada, las solicitudes realizadas a la instancia local de vulcand, , se enrutarán automáticamente a mi servicio.
Creemos que el modelo distribuido nos permite publicar y experimentar mucho más rápido que si hubiéramos adoptado un modelo de gobernanza centralizada. Al distribuir la propiedad de la configuración de rutas a cada servicio, reducimos las barreras para añadir nuevas funciones a los servicios y omitimos el paso de configuración adicional antes de las pruebas y la implementación.
Como vulcand almacena su configuración en [etcd, es fácil para los servicios añadir y actualizar nuevas rutas. Para reducir aún más las barreras, disponemos de bibliotecas en go y python que facilitan la publicación de rutas en etcd. Cualquier persona con acceso de lectura a etcd puede inspeccionar qué rutas pertenecen a un servicio, lo que ayuda a evitar conflictos de enrutamiento. Aun así, pueden producirse conflictos, pero es muy poco frecuente y suelen detectarse pronto en la fase de pruebas.
El modelo sin gobernanza otorga al equipo de desarrollo un gran poder y flexibilidad, pero si no se controla, podría dar a personas usuarias externas un acceso imprevisto a rutas y funciones que no queremos exponer. Para controlar a qué rutas y servicios tienen acceso las personas usuarias externas, utilizamos una capa de proxy adicional para que solo se expongan las rutas de servicio adecuadas.
Exposición de service mesh como API pública
Utilizamos [nginx](https://nginx.org/) para exponer rutas específicas dentro de nuestra arquitectura service mesh para uso público. La arquitectura resultante es algo así:
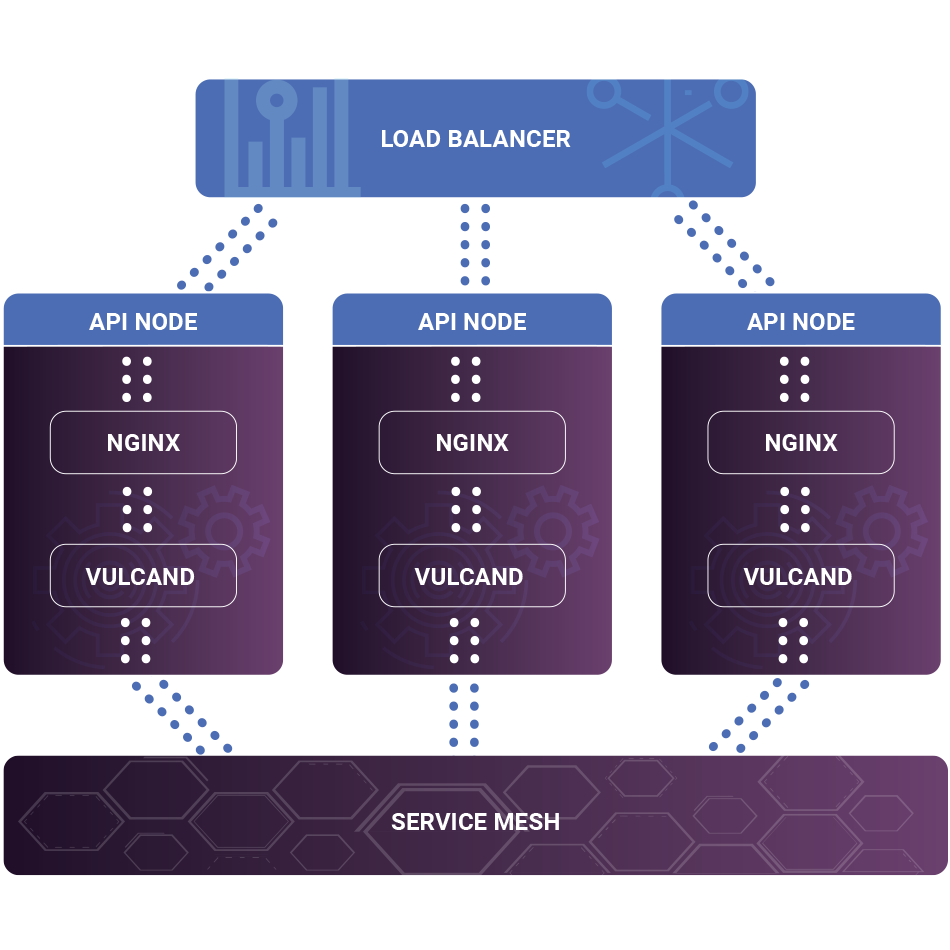
En el front-end, balanceamos la carga de un grupo de procesos de nginx que canalizan solicitudes específicas hacia nuestra arquitectura service mesh a través de instancias de vulcand que se ejecutan localmente. Ejecutar vulcand localmente en cada nodo de nginx permite que el nodo se convierta en miembro de la malla de servicios. Esto nos permite evitar un único punto de fallo en caso de que un nodo de nginx falle.
Dentro de nuestra configuración de nginx, añadimos directivas de ubicación para las rutas específicas de service mesh que queremos exponer. Por ejemplo, la siguiente directiva acepta rutas que empiecen por “/users” y las reenvía a vulcand para que las enrute al servicio adecuado.
location ~ ^/users/($|/.*$) {rn limit_req zone=api burst=280 nodelay;rn}rnupstream vulcand {rn server localhost:9003 fail_timeout=30s;rn }
Si un servicio interno utiliza un modelo de prefijo de ruta, podríamos hacer que nginx reescriba las solicitudes para dirigirse a servicios específicos según el prefijo. Por ejemplo, las solicitudes a “/users” podrían reescribirse a “/user-service/users” dentro de la arquitectura service mesh para que el servicio de usuarios (user-service) responda a dicha solicitud.
Utilizar nginx de este modo nos proporciona una especie de zona desmilitarizada (DMZ) para las solicitudes externas antes de que entren en la red service mesh. Esto nos aísla de las solicitudes HTTP inseguras y limita el acceso de nuestra clientela a la arquitectura service mesh.
Conclusión
El modelo service mesh nos permite crear pequeños equipos de desarrollo centrados en ofrecer productos de alto rendimiento a la clientela de forma rápida y fiable. Aprovechar una capa de proxy con nginx nos proporciona las herramientas necesarias para controlar y escalar nuestros servicios con el fin de satisfacer las necesidades de nuestra clientela.
¿Te interesa trabajar en Mailgun? ¡Buscamos gente! Y tenemos varias vacantes de desarrollo disponibles. Echa un vistazo a nuestras ofertas de trabajo actuales aquí!

