IT & Engineering
GroupCache : la solution de cache supérieure pour Golang
Le cache Golang rend la mise en cache distribuée et la synchronisation simples et faciles à déployer avec GroupCache. Mais pourquoi est-ce le meilleur outil ? Et quels problèmes résout-il ? Chez Mailgun, nous avons utilisé GroupCache pour réduire la latence de notre service de limitation de débit et avons profité des avantages de la synchronisation, tout en évitant les problèmes d’interblocage lors de la création et de la gestion de ressources uniques. Si vous n’êtes pas convaincu, ce n’est pas grave, nous sommes convaincus que vous le serez à la fin de cet article.
Qu’est-ce qu’un cache distribué ?
Un cache est une solution de stockage en mémoire à haut débit qui conserve les données très demandées pour accélérer leur récupération. Un cache distribué divise le cache en segments et les distribue de sorte que chaque nœud d’un cluster de serveurs ne contienne qu’un seul segment du cache entier. De cette façon, le cache peut continuer à évoluer en ajoutant simplement de nouveaux nœuds au cluster.
C’est important pour plusieurs raisons.
- Les caches distribués permettent au cache de croître en même temps que les données. Ils sont avantageux dans les environnements avec un volume de données et une charge élevés.
- Un cache distribué peut s’étendre sur plusieurs serveurs, ce qui lui confère une capacité de transaction beaucoup plus élevée.
Les systèmes de cache distribué comme Redis et les clients Memcached fonctionnent généralement de la manière suivante :
- L’App demande les données en cache au Client via une clé.
- Ensuite, le Client effectue un hachage cohérent sur la clé pour déterminer quel Node possède les données.
- Une fois que le Client a localisé les données, il effectue une requête réseau vers le Node.
- Le Node renvoie les données s’il les trouve.
- L’App vérifie si des données sont renvoyées, sinon elle génère ou récupère les données de la base de données.
- L’App indique au Client de stocker les données pour cette clé.
- Le Client effectue un hachage cohérent sur la clé pour déterminer quel Node doit posséder les données.
- Enfin, le Client stocke les données sur le Node.
En examinant ce flux, deux grandes implications se dégagent :
- Chaque requête de cache entraîne un aller-retour vers un Node, qu’il y ait un succès (hit) ou un échec (miss) de cache.
- Vous ne pouvez pas éviter l’aller-retour vers un Node en mettant la valeur en cache localement, car le Node distant pourrait invalider les données à tout moment sans que l’App ne le sache.
Bien qu’aucune de ces implications ne soit particulièrement gênante pour la plupart des applications, les allers-retours supplémentaires vers la base de données peuvent avoir un impact sur les applications à haute performance et à faible latence. Cependant, il y a une autre implication qui n’est peut-être pas immédiatement évidente : le problème du thundering herd !
Résoudre le problème du thundering herd : tempêtes de cache et haute simultanéité
Le problème du thundering herd est une avalanche de requêtes qui sature le système. Parfois appelé tempête de cache (cache stampede), dogpiling ou effet Slashdot, ce problème survient lorsque des instances simultanées d’une application tentent toutes d’accéder à des données en même temps.
Dans le cadre de cet article, notre thundering herd fait suite à un échec de cache, ce qui signifie que les données ont été soit supprimées, soit jamais placées dans le cache. Par exemple, en fonctionnement normal, une application reste responsive sous une forte charge tant que les données restent en cache.
Lorsque le cache ne contient pas les données, ce thundering herd de requêtes simultanées pourrait saturer le système et entraîner une congestion, voire un effondrement du système.
Pour lutter contre ce travail simultané, vous avez besoin d’un système pour synchroniser la récupération ou la génération des données. Heureusement, il existe une bibliothèque Golang appelée GroupCache qui peut être utilisée pour résoudre le problème du thundering herd et améliorer les implications du cache distant que nous avons mentionnées.
Qu’est-ce que GroupCache et comment se compare-t-il aux autres solutions de cache ?
Il existe de nombreuses solutions de cache sur le marché. GroupCache de Golang est une solution open source qui diffère des outils populaires comme BigCache, Redis et Memcache, car elle s’intègre directement à votre code en tant que cache distribué dans le code (ICDC). Cela signifie que chaque instance de l’App est un Node dans le cache distribué. L’avantage ? En tant que membre à part entière du cache distribué, chaque instance d’application connaît les structures de données, non seulement pour savoir comment stocker les données du nœud, mais aussi comment récupérer ou générer les données si elles sont manquantes.
Pour comprendre pourquoi cela est supérieur à Redis ou Memcached, examinons le flux de mise en cache distribuée lors de l’utilisation de GroupCache. En lisant le flux, gardez à l’esprit que GroupCache est une bibliothèque utilisée par l’application qui écoute également les requêtes entrantes provenant d’autres instances de l’application qui utilisent GroupCache.
- L’App demande les données à GroupCache via une clé.
- Ensuite, GroupCache vérifie le cache chaud en mémoire pour les données, s’il n’y a pas de données, il continue.
- GroupCache effectue un hachage cohérent sur la clé pour déterminer quelle instance GroupCache possède les données.
- Puis, GroupCache effectue une requête réseau vers l’instance GroupCache qui possède les données.
- GroupCache renvoie les données si elles existent en mémoire, sinon il demande à l’App de générer ou de récupérer les données.
- Enfin, GroupCache renvoie les données à l’instance GroupCache qui a initié la requête.
L’étape 5 est importante dans le contexte d’un événement de type thundering herd, car seule l’une des instances GroupCache effectuera la génération ou la récupération des données demandées. Toutes les autres instances de l’application – qui demandent également les données à l’instance GroupCache – seront bloquées jusqu’à ce que l’instance propriétaire de l’application génère ou récupère les données avec succès. Cela crée un point de synchronisation naturel pour l’accès aux données dans le système distribué et annule le problème du thundering herd.
L’étape 2 est également importante car la capacité de mettre en cache les données localement en mémoire évite le coût d’un aller-retour réseau, offrant un énorme avantage en termes de performances et réduisant la pression sur le réseau. Puisque GroupCache fait partie de l’application, nous évitons la possibilité que GroupCache supprime les données à l’insu de l’application, car tout événement de suppression de ce type est partagé par toutes les instances de l’application utilisant GroupCache.
Un avantage certes mineur – mais que ceux d’entre nous qui aiment la simplicité peuvent apprécier – est celui du déploiement. Bien qu’il ne soit pas très difficile de déployer et de sécuriser Redis et Memcached en tant qu’entités distinctes de l’application, le fait d’avoir une seule application à déployer signifie une chose de moins à gérer, à maintenir à jour et à sécuriser pour l’équipe opérationnelle.
Il vaut la peine de le mentionner à nouveau car c’est facile à négliger. La capacité de l’implémentation du cache à générer ou à récupérer les données d’une base de données lors d’un échec de cache, et la capacité à s’appuyer sur un cache chaud local en mémoire, font de GroupCache un choix supérieur parmi les caches distribués. Aucun cache distribué externe à votre application ne peut offrir ces avantages.
GroupCache comme outil de synchronisation
Étant donné que GroupCache fournit une excellente sémantique de synchronisation, nous avons trouvé que GroupCache est une alternative supérieure aux verrous distribués ou au niveau de la base de données lors de la création et de la gestion de ressources uniques.
À titre d’exemple, notre moteur de statistiques interne lit des milliers d’événements et ajoute dynamiquement des balises avec des statistiques attribuées. Comme nous avons de nombreuses instances du moteur en cours d’exécution, chaque nouvelle balise rencontrée doit être traitée comme une nouvelle balise possible. Normalement, cela générerait un flux constant de requêtes upsert vers notre base de données. En utilisant GroupCache, chaque instance peut interroger le cache avec la clé account:tag.
Si la balise existe déjà, elle est renvoyée avec les dernières données sur la balise. Cependant, si la balise n’existe pas, GroupCache relaie la requête à l’instance propriétaire et crée la balise. De cette manière, un seul upsert est envoyé à la base de données lorsque le système rencontre une nouvelle balise.
De la même manière, nous utilisons GroupCache pour compter les compteurs uniques lorsque le système ne doit enregistrer qu’une seule instance d’un compteur. Puisque nous utilisons GroupCache, nous évitons complètement d’utiliser un verrou distribué et les problèmes d’interblocage. Cela est particulièrement utile lorsque vous utilisez une base de données NoSQL avec peu ou pas de sémantique de verrouillage ou de synchronisation propre.
Utilisation de GroupCache
Mailgun utilise une version modifiée de l’œuvre de Brad Fitzpatrick (patrickmn), la bibliothèque GroupCache originale sur github.com.
Les modifications notables apportées à la bibliothèque sont les suivantes :
- Support de la suppression explicite de clés d’un groupe.
Remove() - Support des valeurs expirées.
SetBytes(),SetProto()etSetString()acceptent désormais un paramètre optionneltime.Time{}qui représente une heure dans le futur à laquelle la valeur expirera. - Support du standard Golang
context.Context - Remplit toujours le hotcache
- Pour utiliser GroupCache, vous créez un pool d’instances avec lequel chaque instance GroupCache communiquera, puis vous créez plusieurs groupes de cache indépendants qui utilisent le même pool d’instances.
- Gardez une trace des pairs dans notre cluster et ajoutez notre instance au pool `
http://localhost:8080` pool := groupcache.NewHTTPPoolOpts("http://localhost:8080", &groupcache.HTTPPoolOptions{}) - Ajoutez d’autres pairs
pool.Set("http://peer1:8080", "http://peer2:8080") - Créez un nouveau cache de groupe avec une taille de cache maximale de 3 Mo group: =
groupcache.NewGroup("users", 3000000, groupcache.GetterFunc( func(ctx context.Context, id string, dest groupcache.Sink) error { // Returns a protobuf struct `User` if user, err := fetchUserFromMongo(ctx, id); err != nil { return err } - Configurez l’utilisateur dans groupcache pour qu’il expire après 5 minutes
if err := dest.SetProto(&user, time.Now().Add(time.Minute*5)); err != nil { return err } return nil }, )) - var user User
- Récupérez la définition dans le cache de groupe ctx,
cancel := context.WithTimeout(context.Background(), time.Second*10) if err := group.Get(ctx, “key”, groupcache.ProtoSink(&user)); err != nil { return nil, err } cancel()
Comment l’implémenter avec HTTP/2 et TLS
GroupCache utilise HTTP pour communiquer entre les instances du cluster. Si votre application utilise également HTTP, GroupCache peut utiliser le même port HTTP que votre application. Ajoutez simplement le pool en tant que gestionnaire avec son propre chemin.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
Si votre application a configuré TLS, GroupCache bénéficiera de la même configuration TLS que celle utilisée par votre application, avec en plus la possibilité d’activer HTTP/2, ce qui améliore encore les performances des requêtes GroupCache. Vous pouvez également utiliser HTTP/2 sans TLS via H2C.
Mise à jour de Mailgun concernant la suppression de clés
Une différence notable de la version Mailgun de GroupCache est la possibilité de supprimer explicitement des clés du cache. Lorsqu’une instance souhaite supprimer une clé, elle supprime d’abord la clé de l’instance propriétaire, puis envoie les requêtes de suppression à toutes les autres instances du pool. Cela garantit que toutes les requêtes futures provenant d’instances non propriétaires du pool vers le propriétaire entraîneront une nouvelle récupération ou génération des données (ou une erreur si les données ne sont plus disponibles).
Comme pour tout système distribué, il est possible qu’une instance ne soit pas disponible, ou que la connectivité ait été perdue au moment où la demande de suppression a été effectuée. Dans ce scénario, group.Remove() renverra une erreur indiquant que certaines instances n’ont pas été contactées et précisant la nature de l’erreur.
Selon le cas d’utilisation, l’utilisateur a alors la possibilité de réessayer l’appel à group.Remove() ou d’ignorer l’erreur. Pour certains systèmes, il peut être acceptable d’ignorer l’erreur, en particulier si vous utilisez la fonctionnalité de valeurs expirées.
La fonctionnalité de valeurs expirées vous permet de fournir un délai d’expiration optionnel time.Time qui spécifie une heure future à laquelle les données doivent expirer.
1// Our application2http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {3 fmt.Fprint(w, "Hi there")4})5// Handle GroupCache requests6http.Handle("/_groupcache/", pool)7log.Fatal(http.ListenAndServe(":8080", nil))8
Dans le scénario ci-dessus où nous perdons temporairement la connectivité avec une instance, nous disons que le pool d’instances est dans un état incohérent. Cependant, lorsqu’elle est utilisée conjointement avec la fonction d’expiration des données, nous savons que le système redeviendra finalement cohérent lorsque les données sur les instances déconnectées expireront.
Il existe d’autres solutions beaucoup plus complexes pour résoudre ce problème, mais nous avons constaté dans la pratique que les solutions à cohérence à terme (eventually consistent) sont le moyen le plus simple et le moins sujet aux erreurs de faire face aux perturbations du réseau.
Améliorations des performances de Mailgun grâce à GroupCache
Chez Mailgun, notre première utilisation en production de GroupCache s’est faite dans notre service de limitation de débit (ratelimit). Étant donné que ce service doit fonctionner à un niveau de très haute performance et de faible latence, les systèmes de cache traditionnels posaient problème : plus nous introduisions d’allers-retours dans le pipeline de requêtes, plus nous avions d’occasions d’introduire une latence supplémentaire.
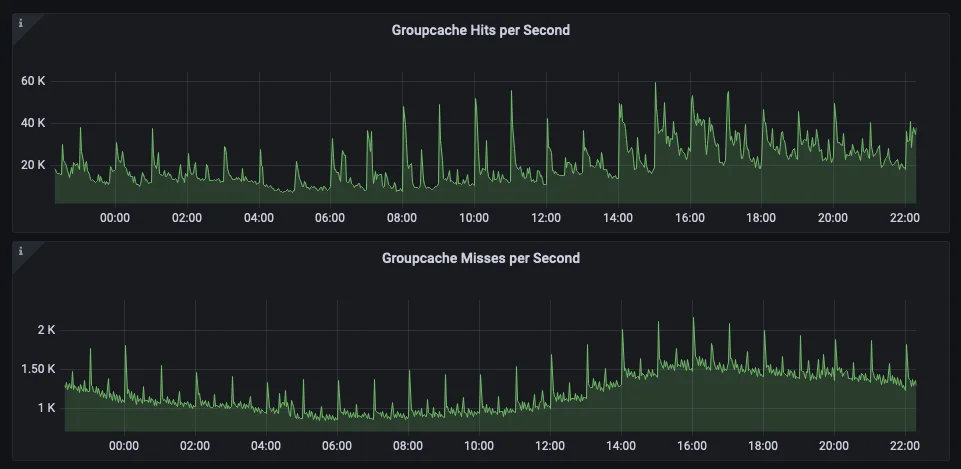
Les graphiques suivants montrent le nombre total de succès de cache (hits) et parmi ces succès, le nombre total de succès qui ont entraîné un aller-retour vers une autre instance GroupCache. Cela démontre exactement à quel point nous bénéficions du cache chaud local en mémoire, par opposition à un appel aller-retour à chaque requête.
Vous pouvez voir dans le graphique suivant à quel point MongoDB et notre application bénéficient de l’évitement du thundering herd lorsque de nouvelles clés sont récupérées du système.
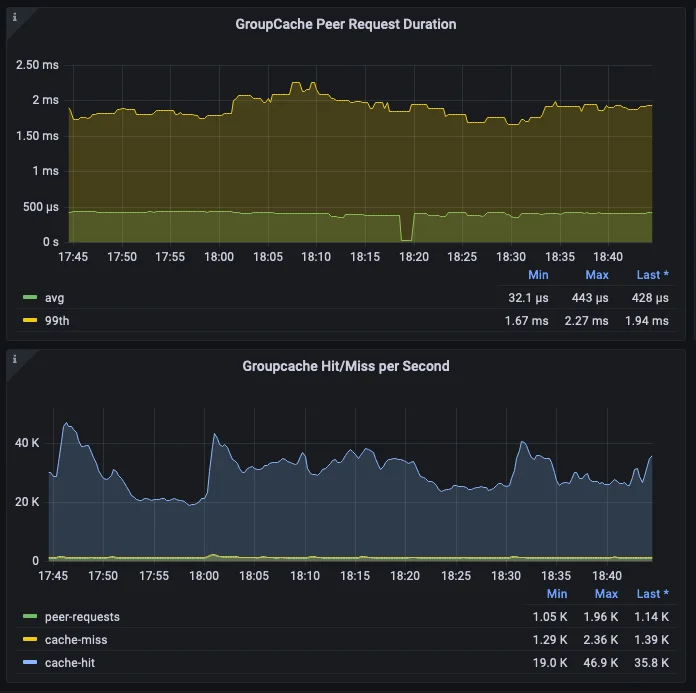
Les appels réels à MongoDB représentent une petite fraction du total des requêtes réellement adressées au service. C’est ce qui, ajouté à la vitesse de gubernator, permet à notre service de limitation de débit de fonctionner avec une faible latence, même en cas de forte charge.
Vous pouvez voir ici les statistiques de temps de réponse du service de limitation de débit. Gardez à l’esprit que pour chaque requête, nous effectuons un appel gubernator et une requête GroupCache qui peuvent ou non entraîner une requête HTTP GroupCache ou une requête MongoDB. (Ce graphique montre les réponses les plus lentes, pas la moyenne).
Conclusion : la mise en cache distribuée simplifiée
GroupCache a amélioré les performances de nos services chez Mailgun. Il rend la mise en cache distribuée et la synchronisation simples et faciles à déployer. J’espère que d’autres découvriront les mêmes avantages dont nous profitons et que cela inspirera d’autres implémentations d’ICDC dans d’autres langages.
Cet article vous a-t-il été utile ? Chez Mailgun, nous évaluons et implémentons constamment de nouvelles façons d’aider à faire évoluer nos services et d’améliorer nos performances. Ce n’est pas toujours facile. Nous aimerions que vous appreniez de nos expériences. Inscrivez-vous à notre newsletter pour plus de contenu de ce type.
Comment fonctionne la mise en cache distribuée ?