Deliverability
Comment empêcher le spam sortant

Le spam est un véritable fléau. Voilà qui résume bien la situation.
Nous avons vu comment identifier et empêcher le spam, mais que faire si vous faites partie du problème ?
Nous parlons du spam sortant qui quitte votre serveur d’email. Dans cet article, nous verrons ce qu’est le spam sortant et comment le combattre. Ensuite, nous plongerons dans notre tutoriel de machine learning pour apprendre à détecter et empêcher le spam sortant.
Qu’est-ce que le spam sortant ?
Le spam sortant est exactement ce que son nom indique : du spam qui quitte votre réseau et atterrit dans la boîte de réception de clients ou d’abonnés qui ne se doutent de rien. Cela se produit lorsque des spammeurs infiltrent votre réseau et l’exploitent pour envoyer du spam.
Les services d’emailing (ESP) comme Mailgun et les entreprises comme la vôtre doivent faire attention aux messages sortants considérés comme du spam, car cela peut détruire votre Réputation de l’adresse IP et entraîner une mise sur liste de blocage d’IP. Cela signifie que le fournisseur d’accès à Internet (FAI) d’un destinataire a détecté un comportement assimilé à du spam et a décidé de bloquer tous les messages, légitimes ou non, provenant de votre adresse IP.
C’est une très mauvaise nouvelle pour vos programmes d’emailing ou vos campagnes marketing. Après tout, vous avez besoin de vos emails pour atterrir dans la boîte de réception de vos abonnés afin qu’ils puissent ouvrir vos messages et interagir avec votre marque.
La lutte contre le spam sortant nécessite une vigilance constante. Vous pouvez par exemple utiliser des filtres anti-spam sortants. Ces filtres installés sur votre propre réseau peuvent être configurés pour identifier les expéditeurs individuels en fonction des protocoles d’authentification. De cette façon, vous pouvez suivre qui envoie des emails sur votre réseau et identifier les comportements apparentés au spam.
Comment empêcher le spam sortant grâce au machine learning ?
Les techniques d’identification et de prévention du spam reposent généralement sur des utilisateurs d’email vigilants ou sur des logiciels tiers. Cependant, le spam passe parfois entre les mailles du filet car il est déguisé. Le spam ne ressemble pas toujours à du spam.
Parfois, les escrocs se font passer pour des détaillants en ligne légitimes en utilisant un faux site Web ou une fausse publicité sur un vrai site d’achat. Dans ces cas, les messages d’email et les liens intégrés paraîtront légitimes, même s’ils ont leur place dans votre dossier de courrier indésirable.
Comment améliorer la détection du spam ? Chez Mailgun, nous croyons en l’utilisation du machine learning pour optimiser les tâches quotidiennes, comme l’analyse des citations HTML.
Ci-dessous, nous vous expliquerons comment appliquer le machine learning pour créer un modèle de détection du spam. Nous allons commencer par créer un jeu de données. Ensuite, nous essaierons d’adapter différents modèles à ces données. Enfin, nous validerons notre modèle. Nous avons utilisé pour notre analyse, mais vous pouvez utiliser un autre outil comme scikit-learn, Weka, ou MOA.
1. Créer un jeu de données
Tout d’abord, examinons le comportement des spammeurs. Nous utiliserons leur modèle comportemental pour créer un système capable d’identifier quand nos emails sortants s’apparentent à du spam.
Pour faire la différence entre le spam qui semble légitime et les messages réellement légitimes, nous nous sommes concentrés sur la vitesse à laquelle les spammeurs envoient une quantité donnée de spam.
Nous avons classé plus de 1 000 comptes d’email et collecté les données suivantes :
- timepassed : le temps écoulé avant qu’un compte ne commence à envoyer des messages
- time2send : le temps nécessaire à un compte pour envoyer un nombre précis de messages
- class : si un compte est légitime ou est considéré comme du spam
Voici un exemple d’entrée de notre jeu de données :
timepassed,time2send,class rn252202,961501,legitimate rn391006,11291,spam rn...
Il s’agit simplement d’un fichier CSV.
Pour l’analyse, j’utilisais mais selon votre tâche et vos préférences personnelles, vous pourriez utiliser autre chose – scikit-learn, Weka, MOA, etc.
Deux tiers du jeu de données ont été réservés à l’entraînement et un tiers à la validation :
x <- read.csv(file="firstXmessages.csv", sep=",", head=TRUE)rnrn## pick rows classified as spamrnspam <- x[x$class %in% c("spam"), ]rnrn## shuffle the data pointsrntotalspam <- nrow(spam) rnspam <- spam[sample(totalspam), ]rnrn## keep 1 / 3 for validation and 2 / 3 for trainingrnvalidatespamrows <- totalspam / 3 rnvalidatespam <- spam[sequence(validatespamrows), ] rntrainspam <- spam[validatespamrows + sequence(totalspam - validatespamrows), ]rnrn## repeat for legitimate domainsrnlegit <- x[x$class == "legitimate", ] rntotallegit <- nrow(legit) rnlegit <- legit[sample(totallegit), ] rnvalidatelegitrows <- totallegit / 3 rnvalidatelegit <- legit[sequence(validatelegitrows), ] rntrainlegit <- legit[validatelegitrows + sequence(totallegit - validatelegitrows), ]rnrn## merge legitimate and spam datapoints together and shufflerntrain <- rbind(trainspam, trainlegit) rntrain <- train[sample(nrow(train)), ]rnrnvalidate <- rbind(validatespam, validatelegit) rnvalidate <- validate[sample(nrow(validate)), ] rnvalidatex <- subset(validate, select=-class)
Nous sommes maintenant prêts à modéliser nos données.
2. Adapter différents modèles à nos données
Après avoir créé notre jeu de données, nous avons essayé différents modèles pour l’analyse de classification. L’analyse de classification identifie et attribue des catégories à une collecte de données pour permettre une analyse plus précise. Dans ce cas, nous essayons d’identifier le spam et les emails légitimes.
Tout d’abord, nous avons essayé le modèle de machines à vecteurs de support (SVM) avec un noyau linéaire qui transforme les données sous une forme linéaire. Le graphique de visualisation ci-dessous vous donne une bonne compréhension de la distribution des points de données :
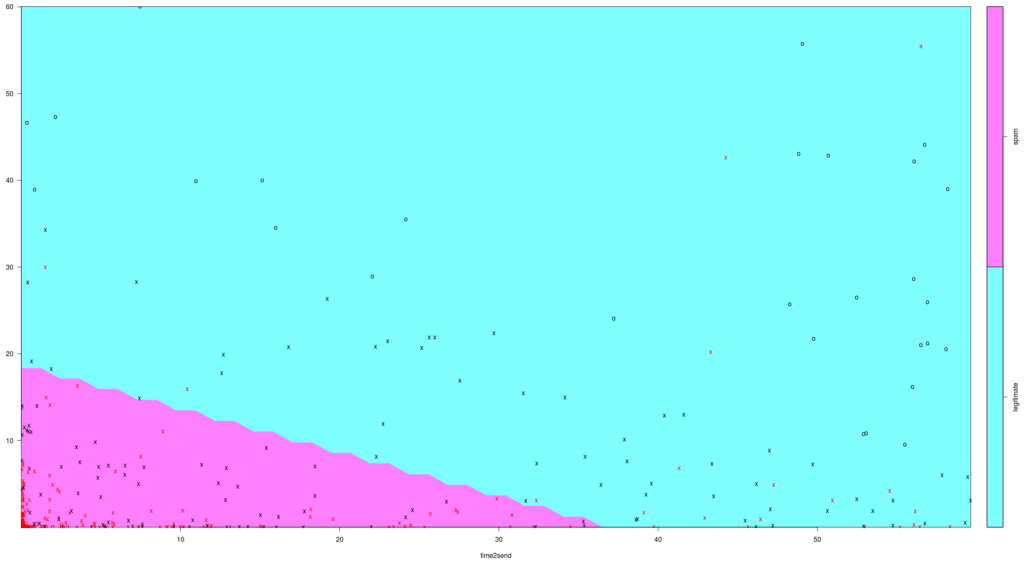
L’axe X est le « time to send » et l’axe Y est le « time lapsed before sending ». Les marques rouges indiquent les points de données des emails de spam, et les marques noires indiquent les points de données des emails légitimes. D’après ce graphique, il semble que les spammeurs commencent à envoyer plus tôt et envoient plus rapidement.
Cependant, ce modèle n’a pas passé la validation. Nous parlerons davantage de la validation dans la section suivante. Pour l’instant, parlons du deuxième modèle que nous avons essayé : Arbre de classification et de régression (CART).
library(rpart)rnrn## grow tree rnfit <- rpart(train$class ~., method="class", data=train)rnrn## plot tree rnplot(fit, uniform=TRUE, rn main="Classification Tree for how fast spammers send")rntext(fit, use.n=TRUE, all=TRUE, cex=.8)
Cela semble prometteur. Lorsque chaque condition énoncée est vraie, nous passons à la branche de gauche. Comme vous pouvez le voir, à mesure que time2send augmente, la proportion d’emails légitimes augmente également. L’inverse est vrai pour les emails de spam, de manière similaire à ce que nous avons observé dans le modèle SVM ci-dessus.
Validons notre modèle dans la section ci-dessous.
3. Valider notre modèle
Nous voulons évaluer notre modèle en utilisant la Précision et le Rappel comme statistiques de performances.
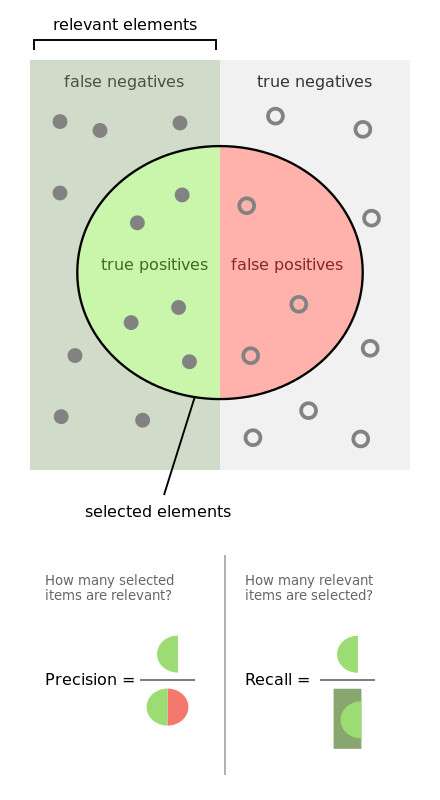
Explication de la Précision et du Rappel (source)
La « Précision » fait référence à la proportion d’instances pertinentes parmi les instances récupérées. Cela signifie que nous pouvons déterminer le niveau de précision du spam (Spam Precision) en fonction de la proportion de comptes de spam parmi tous les comptes récupérés par notre modèle.
Le « Rappel » fait référence à la proportion d’instances pertinentes qui ont été récupérées. Nous pouvons déterminer le niveau de rappel du spam (Spam Recall) en fonction de la proportion d’instances de spam récupérées.
Pour créer un bon filtre anti-spam, nous pouvons tolérer un message de spam occasionnel, mais nous ne devons pas empêcher la livraison d’emails légitimes. Nous voulons nous concentrer sur les statistiques suivantes pour notre modèle, afin de nous assurer de pouvoir distinguer avec précision le spam des emails légitimes :
- Une précision élevée du spam signifie que la plupart des comptes classés comme spam sont effectivement du spam.
- Un rappel élevé des emails légitimes signifie que nous ne classons pas par erreur des comptes légitimes comme étant du spam.
- Un rappel élevé du spam signifie que nous détectons la majorité des comptes de spam.
Vous trouverez ci-dessous les statistiques de précision et de rappel pour notre premier modèle linéaire SVM :
y <- predict(fit, validatex, type="class") rnconfusionmatrix <- table(validate$class, y) rnprint(Evaluate(cm=confusionmatrix))rnrnClass Precision Recall rnlegitimate 0.7031250 0.6000000 rnspam 0.8814229 0.9214876
Comme vous pouvez le voir, nous n’avons que 60 % de rappel des emails légitimes. C’est beaucoup trop bas.
Voyons la validation pour notre second modèle CART :
Class Precision Recall rnlegitimate 0.8333333 0.6666667 rnspam 0.9027237 0.9586777 rn
Les statistiques semblent meilleures, mais le rappel des emails légitimes n’est toujours pas très élevé.
Comme étape finale, nous avons décidé de voir comment notre modèle CART s’intègre dans un graphique de visualisation SVM, comme illustré ci-dessous :
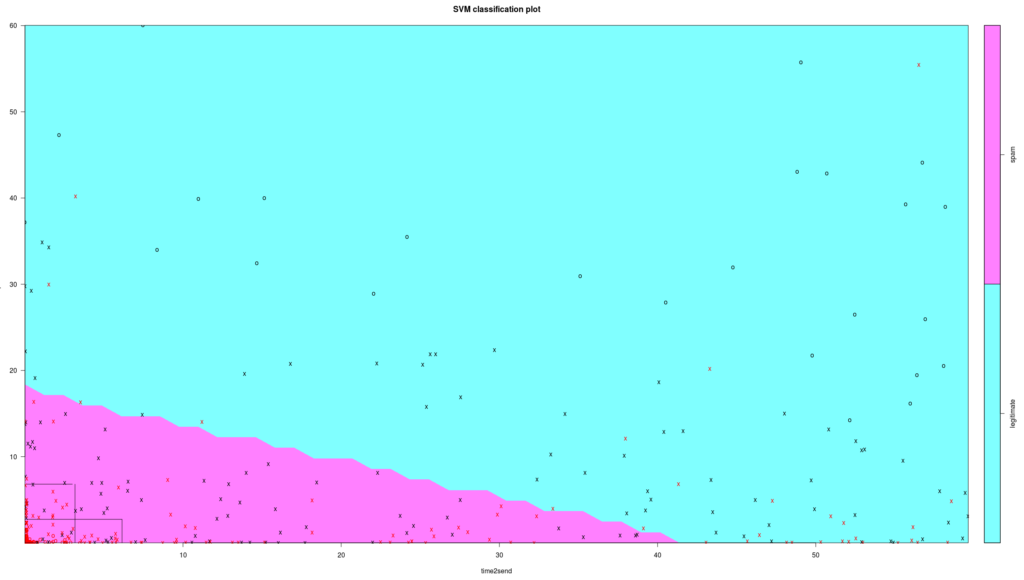
Les points de données dans les quadrants émergés sont presque tous du spam. C’est ce dont nous avions besoin : un modèle simple, logique, et qui ne détecterait que les spammeurs.
Ce modèle constitue une première étape sommaire de l’utilisation du machine learning pour détecter le spam. L’étape suivante consisterait à ajouter plus de caractéristiques à notre jeu de données. Nous vous encourageons à intégrer le machine learning dans vos tâches quotidiennes, comme dans cette présentation.
Conclusion
Nous vous avons donné quelques conseils sur la manière d’éviter que vos emails sortants ne deviennent du spam sortant. En bonus, nous avons également inclus une modélisation de détection du spam par machine learning pour les utilisateurs avancés.
De l’autre côté de l’équation du spam, et si vous constatez que vos campagnes d’emailing Mailgun se perdent dans les dossiers spam de vos abonnés ? Consultez notre article de blog sur comment conserver une bonne réputation auprès des services de messagerie.


Comment combattre le spam sortant ?