Product
Wie und warum wir Service Mesh mit Vulcand und Nginx eingeführt haben

Im vergangenen Jahr hat sich Service Mesh offiziell etabliert, dank der Einführung von Istio (einer Zusammenarbeit von IBM, Google und Lyft) sowie der Nutzung von linkerd durch große Unternehmen wie PayPal und Ticketmaster.
Was genau ist also ein Service Mesh, warum haben wir es bei Mailgun eingeführt und wie nutzen wir es, um unsere Software bereitzustellen?
Was ist ein Service Mesh und wofür wird es genutzt?
Einfach ausgedrückt ist ein Service Mesh eine Software (meist ein Proxy), die die Kommunikation zwischen Diensten schnell und ausfallsicher abwickelt. Angenommen, ich bin ein HTTP-basierter Nutzer-Dienst und möchte den Konto-Dienst kontaktieren, um einen Nutzer zu verifizieren. In einer typischen Non-Mesh-Architektur sendet der Nutzer-Dienst eine Anfrage an , wobei die Anfrage direkt an den Load Balancer des Dienstes weitergeleitet wird. Dieser leitet sie dann an den Konto-Dienst-Knoten weiter, um sie auszuführen.
In einem Service Mesh sendet der Nutzer-Dienst eine HTTP-Anfrage an , die vom lokalen Service-Mesh-Proxy verarbeitet wird. Der lokale Proxy weiß, dass Anfragen an „/accounts“ vom „account-service“ verarbeitet werden. Daher leitet er die Anfrage an einen Knoten im Mesh weiter, auf dem eine Instanz des „account-service“ läuft.
Der größte Vorteil eines Service Mesh ist die hohe Ausfallsicherheit (kein Load Balancer als Single Point of Failure), eine integrierte Service-Erkennung und Releases ohne Ausfallzeiten. Die meisten modernen Service-Mesh-Implementierungen bieten weitaus mehr Funktionen, aber diese Faktoren waren der Hauptgrund für unsere Einführung einer Service-Mesh-Architektur.
Welche Rolle Vulcand dabei spielt
Im Jahr 2014 hatte noch niemand etwas von einem Service Mesh gehört. Als wir mit vulcand begannen, wollten wir einen leistungsstarken Reverse Proxy entwickeln, der eine intelligente Anfrage-Drosselung bietet und es uns ermöglicht, Backend-Dienste dynamisch im laufenden Betrieb hinzuzufügen und zu entfernen. So konnten wir Deployments ohne Ausfallzeiten realisieren. Wir hatten definitiv nicht die Absicht, einen Service-Mesh-Router zu entwickeln.
Kurz darauf fragten wir uns jedoch, was passieren würde, wenn wir vulcand nicht als herkömmlichen Front-End Load Balancer einsetzen, sondern alle unsere Dienste über die lokale vulcand-Instanz miteinander kommunizieren lassen.
Wir haben schnell erkannt, wie viel Freiheit uns das bieten würde. Durch diese Nutzung von vulcand konnten wir auf zusätzliche Load Balancer verzichten, Releases ohne Ausfallzeiten durchführen, die Ausfallsicherheit erhöhen und die Service-Erkennung vereinfachen. Wir hatten versehentlich genau das erschaffen, was die Branche später als Service Mesh bezeichnen sollte.
Wie Mailgun Service-Mesh-Routen verwaltet
Es gibt zwei Ansätze zur Verwaltung von Service-Mesh-Routen. Ein zentrales Governance-Modell und das verteilte, unregulierte Modell.
In einem zentralen Governance-Modell wird die Routenkonfiguration zentral gespeichert und verwaltet. Dies übernimmt meist eine von der Firma ernannte Architektur-Fachkraft. Deren Aufgabe ist es, die Konsistenz der API-Routen sicherzustellen, Routenkonflikte im gesamten Service Mesh zu lösen sowie Gewichtungen und Routing-Ziele festzulegen.
Beim verteilten Modell bestimmen die für den Dienst verantwortlichen Personen, welche Routen ihr Dienst bereitstellt. Häufig wird dabei ein Routen-Präfix verwendet, um Konflikte zu vermeiden (z. B. steht „/service-1/users“ nicht in Konflikt mit „/service-2/users“).
Bei Mailgunhaben wir uns für das verteilte, unregulierte Modell entschieden. Somit ist jeder Dienst selbst dafür verantwortlich, vulcand über die bereitgestellten Routen zu informieren. Dies geschieht, indem die Dienste ihre Routen beim Start über etcd bei vulcand registrieren. Wenn mein Dienst Anfragen für „/users“ verarbeitet, registriert er diese Route bei vulcand. Wenn diese Route konfiguriert ist, werden Anfragen, die an die lokale vulcand-Instanz gerichtet sind, , automatisch an meinen Dienst weitergeleitet.
Wir sind der Meinung, dass wir mit dem verteilten Modell deutlich schneller ausliefern und experimentieren können, als es bei einem zentralen Governance-Modell der Fall wäre. Da die Verantwortung für die Routenkonfiguration bei jedem Dienst selbst liegt, senken wir die Hürde für das Hinzufügen neuer Funktionen. Zudem entfällt der zusätzliche Konfigurationsschritt vor dem Testen und Deployment.
Da vulcand seine Konfiguration in [etcd speichert, können Dienste problemlos neue Routen hinzufügen und aktualisieren. Um die Hürde noch weiter zu senken, bieten wir Bibliotheken in Go und Python an, mit denen sich Routen ganz einfach auf etcd veröffentlichen lassen. Alle mit Lesezugriff auf etcd können überprüfen, welche Routen zu einem Dienst gehören, was zur Vermeidung von Routenkonflikten beiträgt. Dennoch kann es zu Routenkonflikten kommen. Dies geschieht jedoch sehr selten und wird meist frühzeitig in der Testphase erkannt.
Das unregulierte Modell bietet unserem Entwicklungsteam große Leistung und Flexibilität. Ohne entsprechende Kontrolle könnten externe Nutzer jedoch unbeabsichtigt Zugriff auf Routen und Funktionen erhalten, die wir nicht freigeben möchten. Um zu kontrollieren, auf welche Routen und Dienste externe Nutzer zugreifen können, verwenden wir eine zusätzliche Proxy-Ebene. So werden nur die gewünschten Service-Routen freigegeben.
Bereitstellung des Service Mesh als öffentliche API
Wir nutzen [nginx](https://nginx.org/), um bestimmte Routen innerhalb unseres Service Mesh für die öffentliche Nutzung bereitzustellen. Die daraus resultierende Architektur sieht in etwa so aus:
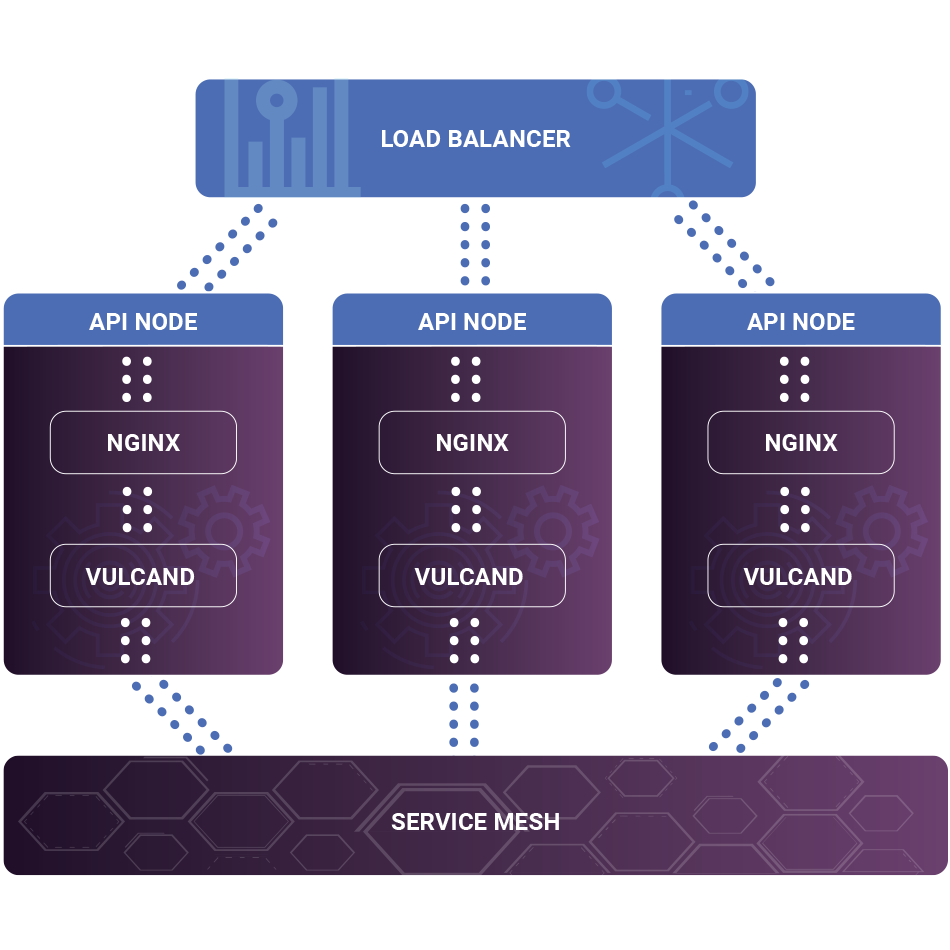
Im Front-End verteilen wir die Last auf einen Pool von nginx-Workern, die bestimmte Anfragen über lokal ausgeführte vulcand-Instanzen an unser Service Mesh weiterleiten. Da vulcand lokal auf jedem nginx-Knoten ausgeführt wird, kann der Knoten zu einem Teil des Service Mesh werden. Dadurch vermeiden wir einen Single Point of Failure, falls ein nginx-Knoten ausfallen sollte.
In unserer nginx-Konfiguration fügen wir Location-Direktiven für die spezifischen Service-Mesh-Routen hinzu, die wir freigeben möchten. Die folgende Direktive akzeptiert beispielsweise Routen, die mit „/users“ beginnen, und leitet sie an vulcand weiter, damit sie zum entsprechenden Dienst geroutet werden.
location ~ ^/users/($|/.*$) {rn limit_req zone=api burst=280 nodelay;rn}rnupstream vulcand {rn server localhost:9003 fail_timeout=30s;rn }
Wenn ein interner Dienst ein Pfad-Präfix-Modell verwendet, können wir Anfragen von nginx umschreiben lassen, um bestimmte Dienste anhand des Präfixes anzusteuern. So könnten etwa Anfragen an „/users“ innerhalb des Service Mesh in „/user-service/users“ umgeschrieben werden, damit der User-Service auf diese Anfrage antwortet.
Diese Einsatzweise von nginx verschafft uns eine Art DMZ für externe Anfragen, bevor sie in das Service Mesh gelangen. Das schützt uns vor unsicheren HTTP-Anfragen und beschränkt den Zugriff unserer Kunden auf das Service Mesh.
Fazit
Dank des Service-Mesh-Modells können wir kleine Entwicklungsteams aufbauen, die sich darauf konzentrieren, unseren Kunden schnell und zuverlässig leistungsstarke Produkte bereitzustellen. Die Nutzung einer nginx-Proxy-Ebene gibt uns die nötigen Werkzeuge an die Hand, um unsere Dienste zu steuern, zu skalieren und so die Anforderungen unserer Kunden zu erfüllen.
Möchten Sie bei Mailgun arbeiten? Wir stellen ein. Zudem sind aktuell mehrere Stellen im Entwicklungsbereich frei. Aktuelle Stellenangebote hier ansehen!

