Product
Como e por que adotamos o service mesh com Vulcand e Nginx

No último ano, o service mesh virou uma verdadeira tendência, graças ao lançamento do Istio (uma colaboração conjunta entre IBM, Google e Lyft) e à adoção do linkerd por grandes empresas, como PayPal e Ticketmaster.
Então, o que é um service mesh, por que o adotamos no Mailgun e como o usamos para entregar nosso software?
O que é um service mesh e por que usá-lo?
Em termos simples, um service mesh é um software (geralmente um proxy) que lida com a comunicação entre serviços de forma rápida e resiliente. Digamos que eu seja um serviço de usuário baseado em HTTP e quero entrar em contato com o serviço de conta para verificar um usuário. Em uma arquitetura comum sem service mesh, o serviço de usuário faria uma solicitação para , que faria o roteamento da solicitação direto para o balanceador de carga do serviço, que, por sua vez, serviria como proxy da solicitação para o nó de serviço de conta, processando-a.
Em um service mesh, o serviço de usuário faz uma solicitação HTTP para , que é tratada pelo proxy de service mesh local. O proxy local sabe que as solicitações para “/accounts” são tratadas pelo “account-service”, então, ele roteia a solicitação para um nó no mesh executando uma instância do “account-service”.
A grande vantagem do service mesh é possibilitar alta resiliência (sem um balanceador de carga como único ponto de falha), descoberta de serviços integrada e lançamentos com zero tempo de inatividade. A maioria das implementações modernas de service mesh oferece ainda mais recursos, mas esses fatores foram a grande motivação para adotarmos uma arquitetura de service mesh.
Onde o Vulcand entra
Em 2014, ninguém sequer tinha ouvido falar de um service mesh. Quando começamos o vulcand, queríamos construir um proxy reverso de alto desempenho que fornecesse um throttling inteligente de solicitações e nos permitisse adicionar e remover dinamicamente serviços de back-end em tempo real, possibilitando, assim, implantações com zero tempo de inatividade. Nossa intenção, definitivamente, não era criar um roteador de service mesh.
Mas, logo em seguida, começamos a imaginar o que aconteceria se, em vez de executar o vulcand como um balanceador de carga de front-end tradicional, fizéssemos com que todos os nossos serviços se comunicassem entre si por meio da instância local do vulcand.
Logo percebemos quanta liberdade isso proporcionaria. Usar o vulcand dessa forma evitaria balanceadores de carga adicionais, proporcionaria lançamentos sem tempo de inatividade, aumentaria a resiliência e facilitaria a descoberta de serviços. Sem querer, havíamos criado o que a indústria um dia chamaria de service mesh.
Como o Mailgun gerencia rotas de service mesh
Existem duas linhas de pensamento para o gerenciamento de rotas de service mesh. Um modelo de governança central e o modelo não governado distribuído.
No modelo de governança central, a configuração de rotas é armazenada e gerenciada de forma centralizada, geralmente por um arquiteto nomeado pela empresa, que tem como função garantir a consistência das rotas de API, solucionar conflitos de rota em todo o service mesh, além de definir os pesos e destinos de roteamento.
No modelo distribuído, cada responsável pelo serviço define as rotas que o serviço em questão fornece, muitas vezes usando um prefixo de rota para evitar conflitos (por exemplo, “/service-1/users” não entraria em conflito com “/service-2/users”).
Na Mailgun, adotamos o modelo não governado distribuído para que cada serviço fique responsável por informar ao vulcand sobre as rotas que fornece. Os serviços fazem isso ao registrarem suas rotas com o vulcand por meio do etcd, durante a inicialização do serviço. Se meu serviço tratar solicitações para “/users”, ele registrará essa rota no vulcand. Com a rota configurada, as solicitações feitas à instância local do vulcand, , serão roteadas automaticamente para o meu serviço.
Acreditamos que o modelo distribuído nos permite fazer entregas e experimentos de forma muito mais rápida do que se tivéssemos adotado um modelo de governança central. Ao distribuir a propriedade da configuração de rotas para cada serviço, diminuímos a dificuldade de adicionar novas capacidades aos serviços e pulamos a etapa de configuração extra antes de testes e implantações.
Como o vulcand armazena sua configuração no [etcd, os serviços conseguem adicionar e atualizar novas rotas com facilidade. Para diminuir ainda mais a dificuldade, temos bibliotecas em Go e Python que facilitam a publicação de rotas no etcd. Qualquer pessoa com acesso de leitura ao etcd pode inspecionar quais rotas pertencem a um serviço, algo que pode ajudar a evitar conflitos de rota. Mesmo assim, podem acontecer conflitos de rota, porém, isso é bem raro e, na maioria das vezes, logo percebido nos testes.
O modelo não governado dá um poder e uma flexibilidade enormes à nossa equipe de desenvolvimento, mas, sem o devido controle, pode conceder acesso indevido à nossa base de usuários externos, expondo rotas e funcionalidades que preferimos não revelar. Para controlar quais rotas e serviços a base de usuários externos pode acessar, usamos uma camada extra de proxy para que apenas as rotas de serviço adequadas fiquem expostas.
Exposição do service mesh como uma API pública
Usamos o [nginx](https://nginx.org/) para expor rotas específicas em nosso service mesh para uso público. A arquitetura resultante se parece com algo assim:
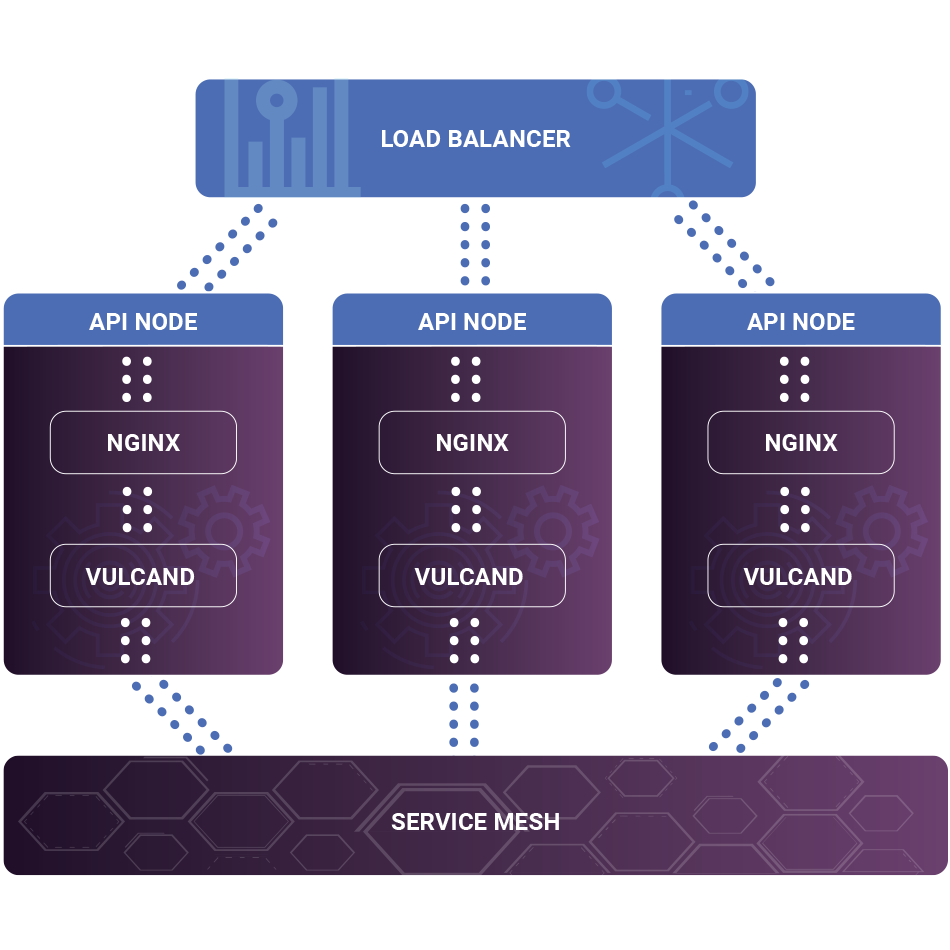
No front-end, fazemos o balanceamento de carga de um pool de workers do nginx, que atuam como proxy de solicitações específicas para o nosso service mesh por meio de instâncias locais do vulcand em execução. A execução do vulcand localmente em cada nó do nginx permite que o nó se torne um membro do service mesh. Isso nos ajuda a evitar um único ponto de falha, caso haja algum problema em um nó do nginx.
Em nossa configuração do nginx, adicionamos diretivas de localização para as rotas de service mesh específicas que queremos expor. Por exemplo, a seguinte diretiva aceita rotas iniciadas com “/users” e as encaminha ao vulcand para que o roteamento ao serviço adequado seja feito.
location ~ ^/users/($|/.*$) {rn limit_req zone=api burst=280 nodelay;rn}rnupstream vulcand {rn server localhost:9003 fail_timeout=30s;rn }
Se um serviço interno usar um modelo de prefixo de caminho, poderíamos fazer o nginx reescrever as solicitações para atingir serviços específicos pelo prefixo. Por exemplo, as solicitações para “/users” poderiam ser reescritas para “/user-service/users” dentro do service mesh, assim, o user-service responderia a tal solicitação.
Usar o nginx desse jeito nos dá uma espécie de DMZ para as solicitações externas, antes de entrarem no service mesh. Isso nos protege contra solicitações HTTP inseguras e limita o acesso dos clientes ao nosso service mesh.
Conclusão
O modelo de service mesh nos permite criar equipes de desenvolvimento pequenas focadas em entregar produtos de alto desempenho aos nossos clientes, de forma rápida e confiável. Aproveitar uma camada de proxy do nginx nos fornece as ferramentas necessárias para controlar e dimensionar nossos serviços, visando atender às necessidades dos nossos clientes.
Tem interesse em trabalhar no Mailgun? Estamos contratando! Além disso, há diversas vagas de desenvolvimento disponíveis. Confira nossas vagas atuais aqui!


