Product
Comment et pourquoi nous avons adopté le service mesh avec Vulcand et Nginx

Au cours de l’année écoulée, le service mesh est officiellement devenu incontournable, grâce au lancement d’ Istio (une collaboration conjointe entre IBM, Google et Lyft) et à l’adoption de linkerd par de grandes entreprises comme PayPal et Ticketmaster.
Alors qu’est-ce qu’un service mesh, pourquoi l’avons-nous adopté chez Mailgun et comment l’utilisons-nous pour distribuer nos logiciels ?
Qu’est-ce qu’un service mesh et pourquoi l’utiliser ?
En termes simples, un service mesh est un composant logiciel (généralement un proxy) qui gère la communication de service à service de manière rapide et résiliente. Supposons que je sois un service utilisateur basé sur HTTP et que je souhaite contacter le service de compte pour vérifier un utilisateur. Dans une architecture classique sans mesh, le service utilisateur ferait une requête à , qui acheminerait la requête directement vers l’équilibreur de charge du service, qui transmet ensuite la requête au nœud du service de compte, traitant ainsi la requête.
Dans un service mesh, le service utilisateur effectue une requête HTTP vers , qui est gérée par le proxy local du service mesh. Le proxy local sait que les requêtes vers « /accounts » sont gérées par le « account-service » ; il achemine donc la requête vers un nœud du mesh exécutant une instance de « account-service ».
Le principal avantage du service mesh est qu’il permet une haute résilience (aucun point de défaillance unique lié à un équilibreur de charge), une découverte de services intégrée et des déploiements sans temps d’arrêt. La plupart des implémentations modernes de service mesh offrent bien d’autres fonctionnalités, mais ces facteurs ont été la principale motivation de notre adoption d’une architecture de service mesh.
L’intervention de Vulcand
En 2014, personne n’avait encore entendu parler du service mesh. Lorsque nous avons commencé avec vulcand, nous voulions créer un proxy inverse ultra-performant qui offrirait une limitation intelligente des requêtes et nous permettrait d’ajouter ou de supprimer dynamiquement des services backend à la volée, permettant ainsi des déploiements sans temps d’arrêt. Nous n’avions absolument pas l’intention de créer un routeur de service mesh.
Mais peu de temps après, nous nous sommes demandé ce qui se passerait si, au lieu d’utiliser vulcand comme un équilibreur de charge front-end traditionnel, tous nos services communiquaient entre eux via l’instance vulcand locale.
Nous avons rapidement réalisé la liberté que cela offrirait. Utiliser vulcand de cette manière éviterait d’avoir recours à des équilibreurs de charge supplémentaires, permettrait des déploiements sans temps d’arrêt, augmenterait la résilience et faciliterait la découverte de services. Nous avions créé par inadvertance ce que l’industrie finirait par appeler un service mesh.
Il y a deux écoles de pensée pour gérer les routes du service mesh. Un modèle de gouvernance centralisée et le modèle distribué non gouverné.
Dans un modèle de gouvernance centralisée, la configuration des routes est stockée et gérée de manière centralisée, généralement par une personne désignée par l’entreprise dont le rôle est d’assurer la cohérence des routes d’API, de résoudre les conflits de routage sur l’ensemble du service mesh, de définir les pondérations et les destinations de routage.
Avec le modèle distribué, chaque responsable de service détermine quelles routes son service fournit, souvent en utilisant un préfixe de routage pour éviter les conflits (par ex. « /service-1/users » n’entrera pas en conflit avec « /service-2/users »).
Chez Mailgun, nous avons adopté le modèle distribué non gouverné afin que chaque service soit responsable d’informer vulcand des routes qu’il fournit. Les services le font en enregistrant leurs routes auprès de vulcand via etcd lors de leur démarrage. Si mon service gère les requêtes pour « /users », il enregistrera cette route auprès de vulcand. Avec cette configuration de routage, les requêtes effectuées vers l’instance locale de vulcand, , seront automatiquement acheminées vers mon service.
Nous avons le sentiment que le modèle distribué nous permet de livrer et d’expérimenter beaucoup plus rapidement que si nous avions opté pour un modèle de gouvernance centralisée. En répartissant la propriété de la configuration de routage à chaque service, nous réduisons les obstacles à l’ajout de nouvelles fonctionnalités aux services et contournons l’étape de configuration supplémentaire avant les tests et le déploiement.
Parce que vulcand stocke sa configuration dans [etcd, il est simple pour les services d’ajouter et de mettre à jour de nouvelles routes. Pour faciliter encore plus les choses, nous disposons de bibliothèques en Go et Python qui simplifient la publication des routes vers etcd. Toute personne disposant d’un accès en lecture à etcd peut inspecter quelles routes appartiennent à un service, ce qui peut aider à éviter les conflits de routage. Malgré cela, des conflits de routes peuvent survenir, mais cela reste très rare et est généralement détecté tôt lors des tests.
Le modèle non gouverné offre à notre équipe de développement une grande puissance et une grande flexibilité, mais s’il n’est pas contrôlé, il pourrait donner aux utilisateurs externes un accès involontaire à des routes et des fonctionnalités que nous ne souhaitons pas exposer. Pour contrôler les routes et les services auxquels les utilisateurs externes peuvent accéder, nous utilisons une couche de proxy supplémentaire afin que seules les routes de service appropriées soient exposées.
Exposer le service mesh comme une API publique
Nous utilisons [nginx](https://nginx.org/) pour exposer des routes spécifiques au sein de notre service mesh pour une utilisation publique. L’architecture qui en résulte ressemble à ceci :
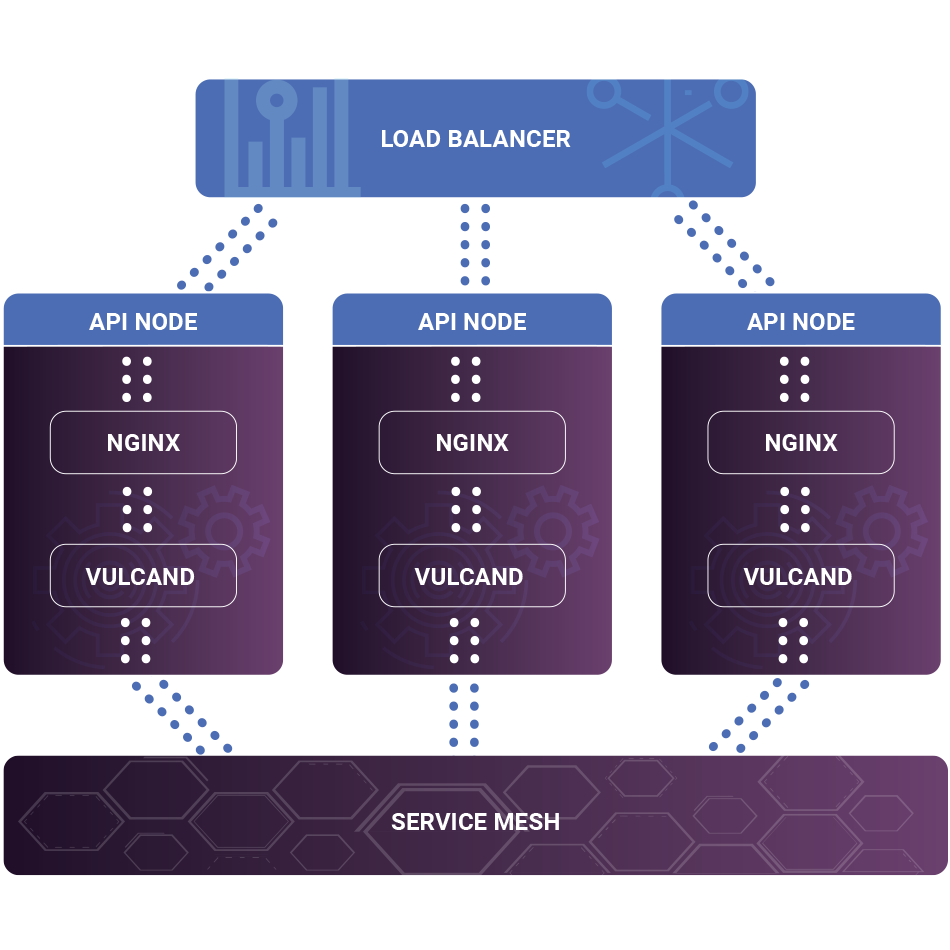
Sur le front-end, nous équilibrons la charge d’un pool de workers nginx qui relaient des requêtes spécifiques vers notre service mesh via des instances vulcand exécutées localement. L’exécution locale de vulcand sur chaque nœud nginx permet au nœud de devenir membre du service mesh. Cela nous permet d’éviter un point de défaillance unique si un nœud nginx tombe en panne.
Dans notre configuration nginx, nous ajoutons des directives d’emplacement pour les routes spécifiques du service mesh que nous souhaitons exposer. Par exemple, la directive suivante accepte les routes commençant par « /users » et les transfère à vulcand pour qu’elles soient acheminées vers le service approprié.
location ~ ^/users/($|/.*$) {rn limit_req zone=api burst=280 nodelay;rn}rnupstream vulcand {rn server localhost:9003 fail_timeout=30s;rn }
Si un service interne utilise un modèle de préfixe de chemin, nous pourrions faire en sorte que nginx réécrive les requêtes pour cibler des services spécifiques par préfixe. Par exemple, les requêtes vers « /users » pourraient être réécrites en « /user-service/users » au sein du service mesh afin que le user-service réponde à cette requête.
Utiliser nginx de cette manière nous offre une sorte de zone démilitarisée (DMZ) pour les requêtes externes avant qu’elles n’entrent dans le service mesh. Cela nous isole des requêtes HTTP non sécurisées et limite l’accès des clients à notre service mesh.
Conclusion
Le modèle de service mesh nous permet de former de petites équipes de développement concentrées sur la livraison de produits hautement performants à nos clients, et ce de manière rapide et fiable. L’exploitation d’une couche proxy nginx nous donne les outils nécessaires pour contrôler et faire évoluer nos services afin de répondre aux besoins de nos clients.
Envie de travailler chez Mailgun ? Nous recrutons ! Et plusieurs postes de développement sont à pourvoir. Découvrez nos offres d’emploi actuelles ici!



Comment Mailgun gère les routes du service mesh