IT & Engineering
Gubernator : limitation de débit distribuée cloud-native pour les microservices

Aujourd’hui, Mailgun a le plaisir de proposer en open source Gubernator, un microservice de limitation de débit distribué à haute performance. Que fait Gubernator ? Excellente question :
Fonctionnalités de Gubernator
- Gubernator répartit uniformément les requêtes de limitation de débit sur l’ensemble du cluster, ce qui permet de faire évoluer le système en ajoutant simplement des nœuds supplémentaires.
- Gubernator ne dépend pas de caches externes tels que Memcache ou Redis, ce qui évite toute synchronisation de déploiement avec un service dépendant. Il est donc très simple d’agrandir ou de réduire dynamiquement le cluster dans un système d’orchestration tel que Kubernetes ou Nomad.
- Gubernator ne conserve aucun état sur le disque, et sa configuration lui est transmise par le client à chaque requête.
- Gubernator offre un accès GRPC et HTTP à son API.
- Peut être exécuté en tant que sidecar pour les services nécessitant une limitation de débit, ou comme service distinct.
- Peut être utilisé comme bibliothèque pour implémenter un service de limitation de débit spécifique à un domaine.
- Prend en charge une distribution de limitation de débit optionnelle à cohérence éventuelle pour les environnements à très haut débit.
- Gubernator est la prononciation anglaise du mot gouverneur en russe, et ça sonne bien.
Nous sommes convaincus que vous vous demandez pourquoi nous avons décidé de proposer Gubernator en open source. Avant de détailler le fonctionnement de Gubernator, répondons d’abord à certaines de ces questions. La principale que vous vous posez est sans doute la suivante…
Pourquoi ne pas utiliser Redis ?
Plusieurs éléments nous ont interpellés lors de l’évaluation de Redis.
- L’utilisation de la mise en œuvre de base de la limitation de débit dans Redis entraînerait des allers-retours supplémentaires sur le réseau, même avec le pipelining.
- Nous pourrions réduire les allers-retours en utilisant https://redis.io/commands/eval et en écrivant un script LUA que nous devrions maintenir pour chaque algorithme implémenté.
- Chaque requête entraînerait au moins un aller-retour vers Redis. Si l’on ajoute à cela au moins un aller-retour vers notre microservice, on arrive à un minimum de deux allers-retours par requête vers notre service.
La solution optimale pour Redis consiste à écrire un script LUA qui implémente l’algorithme de limitation de débit. Ce script est ensuite stocké sur le serveur Redis et est appelé pour chaque requête de limitation de débit. Dans ce scénario, la majeure partie du travail est effectuée par Redis, et notre microservice sert essentiellement de proxy pour y accéder. Dans ce cas, deux options s’offrent à nous :
- Créer Gubernator en tant que bibliothèque de limitation de débit offrant un accès à Redis. Cette bibliothèque serait utilisée par tout service nécessitant une limitation de débit.
- Éliminer Redis et implémenter les algorithmes de distribution, de mise en cache et de limitation dans un microservice de limitation de débit, accompagné d’un client GRPC léger à utiliser par chaque service.
Pourquoi un microservice ?
Mailgun est une entreprise polyglotte, dont la majorité de la base de code est en Python et en Golang. Si nous choisissons d’implémenter la limitation de débit sous forme de bibliothèque, cela nécessite au minimum une version Python et une version Golang de cette bibliothèque. Nous avons déjà emprunté cette voie en interne, avec une version Python et Golang pour une même bibliothèque. D’après notre expérience, les bibliothèques partagées entre les services présentent les inconvénients suivants.
- Les correctifs de bugs et les nouvelles fonctionnalités de la bibliothèque impliquent, au mieux, une mise à jour de la dépendance. Au pire, il est nécessaire de modifier tous les services qui utilisent la bibliothèque dans tous les langages pris en charge.
- Il est rare que l’équipe de développement souhaite maintenir ou écrire de nouvelles fonctionnalités dans les deux langages. Cela conduit généralement à ce qu’une version de la bibliothèque comporte plus de fonctionnalités ou soit mieux maintenue que l’autre.
À mesure que le nombre de microservices et de langages de notre écosystème ne cesse de croître, ces problèmes s’accumulent et s’aggravent. En comparaison, les bibliothèques GRPC et HTTP sont faciles à créer et à maintenir pour chaque langage nécessitant un accès à Gubernator.
Pour les microservices, il est possible d’ajouter des correctifs et de nouvelles fonctionnalités sans perturber les services dépendants. Tant qu’aucune modification critique de l’API n’est autorisée, les services dépendants peuvent adopter de nouvelles fonctionnalités sans qu’il soit nécessaire de mettre à jour tous les services dépendants.
Le principal atout de Gubernator en tant que microservice est de créer un point de synchronisation pour les nombreuses requêtes qui entrent dans le système. Les requêtes reçues à quelques microsecondes d’intervalle peuvent être optimisées et coordonnées par lots, ce qui réduit la bande passante globale et la latence d’aller-retour utilisées par le service en cas de charge importante. Plusieurs services s’exécutant sur un seul hôte, avec la même bibliothèque fonctionnant dans leurs propres processus respectifs, ne disposent pas de cette capacité.
Pourquoi Gubernator est-il sans état ?
Gubernator est sans état dans la mesure où son fonctionnement ne nécessite pas d’espace disque. Aucune configuration ou donnée de cache n’est jamais synchronisée sur le disque, car chaque requête adressée à Gubernator inclut la configuration pour la limitation de débit.
À première vue, on pourrait penser qu’il s’agit d’une surcharge inutile pour chaque requête. Toutefois, en réalité, une configuration de limitation de débit n’est composée que de quatre entiers de 64 bits. La configuration se compose de Limit, Duration, Algorithm et Behavior (voir ci-dessous pour plus de détails sur le fonctionnement). C’est grâce à cette configuration simple que Gubernator peut fournir une grande variété de cas d’usage de limitation de débit exploitables par la clientèle. Voici quelques-uns de ces cas d’usage :
- Limitation en entrée – Limitation typique basée sur HTTP de type 402 Too Many Requests
- Délestage du trafic – Rejeter uniquement les requêtes nouvelles ou non authentifiées lorsque votre API est en mauvais état.
- Limitation en sortie – Bombarder des serveurs SMTP externes avec des millions de messages n’est pas une bonne idée.
- Traitement de la file d’attente – Savoir si une requête peut être traitée immédiatement, ou si elle doit être mise en file d’attente et traitée dans son ordre de réception.
- Gestion de la capacité des API – Imposer des limites globales sur le nombre total de requêtes qu’un système d’API collectif peut traiter. Rejeter ou mettre en file d’attente les requêtes qui dépassent la capacité de fonctionnement normale du système.
Outre les cas d’usage susmentionnés, une conception sans configuration a des implications majeures sur la conception et le déploiement des microservices :
- Aucune synchronisation de configuration lors du déploiement. Lorsqu’un service utilisant Gubernator est déployé, il n’est pas nécessaire de prédéployer une configuration de limitation de débit dans Gubernator.
- Les services utilisant Gubernator possèdent leur propre modèle de domaine de limitation de débit en fonction de leur problématique. Ainsi, les connaissances propres au domaine sont conservées en dehors de Gubernator, ce qui lui permet de se concentrer sur ce qu’il fait de mieux : limiter le débit !
Au-delà de ces questions, parlons davantage de Gubernator dans son ensemble, en commençant par son fonctionnement.
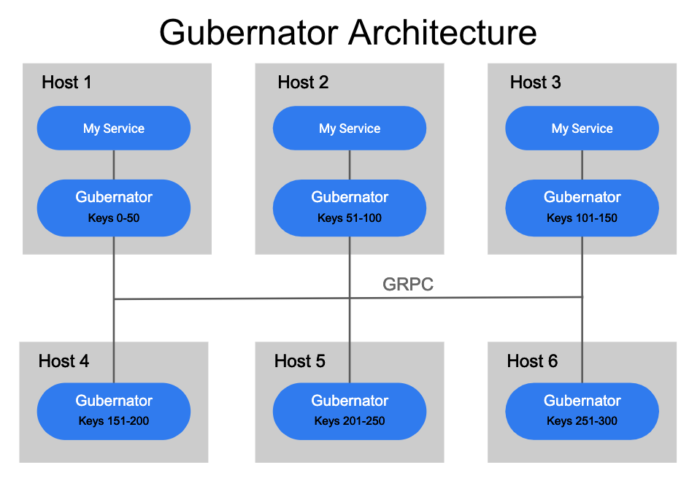
Gubernator est conçu pour fonctionner comme un cluster distribué de pairs utilisant un cache en mémoire de toutes les limitations de débit actives à ce moment-là. Ainsi, aucune donnée n’est jamais synchronisée sur le disque. Étant donné que la plupart des durées de limitation de débit sur le réseau ne durent que quelques secondes, la perte du cache en mémoire lors d’un redémarrage ou d’une indisponibilité planifiée n’est pas dramatique. Pour Gubernator, nous privilégions les performances à la précision. En effet, il est acceptable qu’un petit sous-ensemble du trafic effectue des requêtes excessives pendant une courte période (généralement quelques secondes) en cas de perte de cache.
Lorsqu’une requête de limitation de débit est adressée à Gubernator, elle est accompagnée d’une clé. Un algorithme de hachage cohérent est alors appliqué pour déterminer lequel des pairs sera le propriétaire de la requête de limitation de débit. Le choix d’un propriétaire unique pour une limitation de débit rend les incréments atomiques des comptages très rapides et évite la complexité et la latence liées à la distribution cohérente des comptages sur un cluster de pairs.
Bien que simple et performante, cette conception peut être exposée à un afflux massif de requêtes, car un seul coordinateur est responsable de potentiellement plusieurs centaines de milliers de requêtes vers une limitation de débit.
Pour y remédier, la clientèle peut exiger l’option `Behaviour=BATCHING`, qui permet aux pairs de prendre plusieurs requêtes dans une fenêtre donnée (500 microsecondes par défaut) et de les regrouper en un lot constituant une seule requête de pair, ce qui réduit considérablement le nombre total de requêtes réseau vers un seul pair Gubernator.
Afin de s’assurer que chaque pair du cluster calcule correctement le hachage d’une clé de limitation de débit, la liste des pairs du cluster doit être distribuée à chacun d’entre eux de manière opportune et cohérente. Actuellement, Gubernator prend en charge l’utilisation d’etcd ou de l’API de points de terminaison Kubernetes pour découvrir les pairs Gubernator.
Fonctionnement de Gubernator
Lorsqu’un client ou un service effectue une requête auprès de Gubernator, la configuration de la limitation de débit est fournie avec chaque requête par le client. La configuration de la limitation de débit est ensuite stockée avec l’état actuel de la limitation de débit dans le cache local du propriétaire de la limitation de débit. Les limitations de débit et leur configuration qui sont stockées dans le cache local n’existeront que pour la durée spécifiée dans la configuration de la limitation de débit.
Une fois la durée expirée, et si la limitation de débit n’a pas fait l’objet d’une nouvelle requête au cours de cette période, elle est supprimée du cache. Les requêtes ultérieures avec la même paire nom et unique_key recréeront la configuration et la limitation de débit dans le cache, et le cycle se répétera. En revanche, les requêtes ultérieures présentant des configurations différentes écraseront la configuration précédente et la nouvelle configuration s’appliquera immédiatement.
Voici un exemple de requête de limitation de débit envoyée via GRPC :
rate_limits:rn # Scopes the request to a specific rate limit rn - name: requests_per_secrn # A unique_key that identifies this rate limit requestrn unique_key: account_id=123|source_ip=172.0.0.1rn # The number of hits we are requestingrn hits: 1rn # The total number of requests allowed for this rate limitrn limit: 100rn # The duration of the rate limit in millisecondsrn duration: 1000rn # The algorithm used to calculate the rate limit rn # 0 = Token Bucketrn # 1 = Leaky Bucketrn algorithm: 0rn # The behavior of the rate limit in gubernator.rn # 0 = BATCHING (Enables batching of requests to peers)rn # 1 = NO_BATCHING (Disables batching)rn # 2 = GLOBAL (Enable global caching for this rate limit)rn behavior: 0
Et voici un exemple de réponse :
rate_limits:rn # The status of the rate limit. OK = 0, OVER_LIMIT = 1rn - status: 0,rn # The current configured limitrn limit: 10,rn # The number of requests remainingrn remaining: 7,rn # A unix timestamp in milliseconds of when the rate limit will reset,rn # or if OVER_LIMIT is set it is the time at which the rate limitrn # will no longer return OVER_LIMIT.rn reset_time: 1551309219226,rn # Additional metadata about the request the client might find usefulrn metadata:rn # This is the name of the node that owns this requestrn "owner": "api-n03.staging.us-east-1.mailgun.org:9041"
Comportement global
Étant donné que les limitations de débit de Gubernator sont hachées et gérées par un seul pair du cluster, les limitations de débit s’appliquant à chaque requête dans un centre de données entraîneraient la gestion de la requête de limitation de débit par un seul pair pour l’ensemble du centre de données.
Prenons l’exemple d’une limitation de débit avec name=requests_per_datacenter et unique_id=us-east-1. Imaginons maintenant qu’une requête soit adressée à Gubernator avec cette limitation de débit pour chaque requête HTTP qui entre dans le centre de données us-east-1. Il pourrait s’agir de centaines de milliers, voire potentiellement de millions de requêtes par seconde, toutes hachées et gérées par un seul pair du cluster. En raison de ce potentiel problème d’évolutivité, Gubernator introduit un behavior configurable appelé GLOBAL.
Lorsqu’une limitation de débit est configurée avec behavior=GLOBAL, la requête de limitation de débit reçue d’un client ne sera pas transmise au pair propriétaire. Au lieu de cela, la réponse proviendra d’un cache interne géré par le pair qui a reçu la requête. Les correspondances (Hits) liées à la limitation de débit seront regroupées par le pair récepteur et envoyées de manière asynchrone au pair propriétaire, où elles seront totalisées et la valeur OVER_LIMIT sera calculée. Il incombe alors au pair propriétaire de mettre à jour chaque pair du cluster avec le statut actuel de la limitation de débit, de sorte que les caches internes des pairs soient régulièrement mis à jour avec le statut de limitation de débit le plus récent provenant du propriétaire.
Effets secondaires du comportement global
Puisque les Hits sont regroupés et transmis au pair propriétaire de manière asynchrone, la réponse immédiate au client n’inclura pas les comptages remaining les plus précis. Ce comptage ne sera mis à jour qu’une fois l’appel asynchrone au pair propriétaire terminé et que ce dernier aura eu le temps de mettre à jour tous les pairs du cluster. Par conséquent, l’utilisation de GLOBAL permet une plus grande évolutivité, mais au prix de la cohérence. L’utilisation de GLOBAL peut augmenter le volume de trafic par requête de limitation de débit si le cluster est suffisamment grand. L’option GLOBAL ne devrait être utilisée que pour les limitations de débit à très haut volume qui ne s’adaptent pas bien au comportement classique sans l’option GLOBAL.
Performances de Gubernator
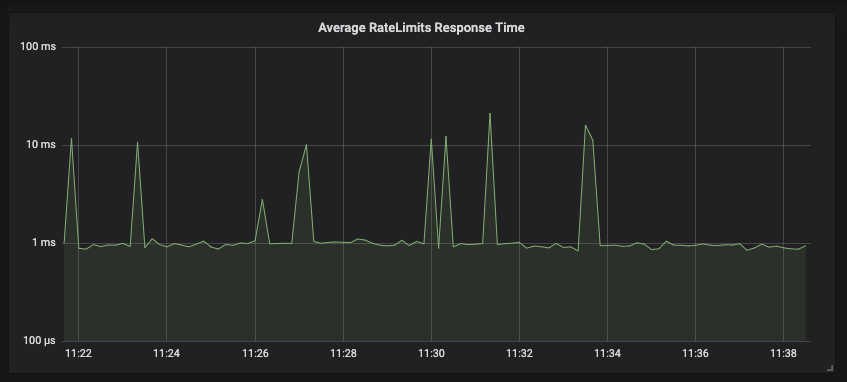
Dans notre environnement de production, pour chaque requête vers notre API, nous envoyons deux requêtes de limitation de débit à Gubernator pour évaluation de la limitation ; l’une pour évaluer la requête HTTP, et l’autre pour évaluer le nombre de destinataires auxquels une personne peut envoyer un email dans la durée impartie. Avec cette configuration, un seul nœud Gubernator traite plus de 2 000 requêtes par seconde, la plupart des réponses par lots étant renvoyées en moins d’une milliseconde.
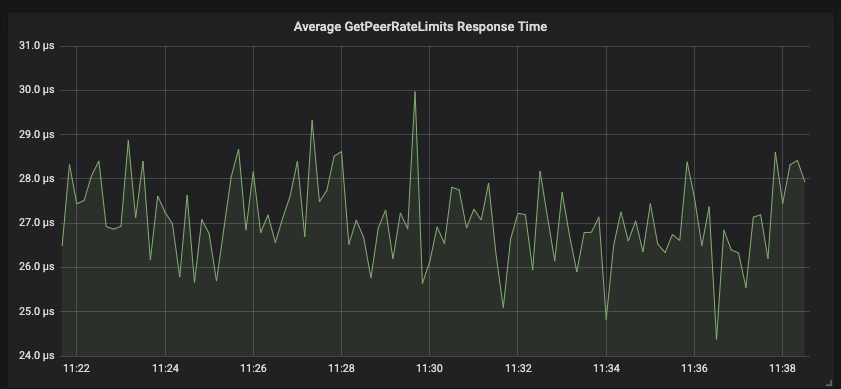
Les requêtes de pairs transmises aux nœuds propriétaires répondent généralement en moins de 30 microsecondes.
Comme nombre de nos API publiques sont écrites en Python, nous exécutons plusieurs instances de l’interpréteur Python sur un seul nœud. Ces instances Python transmettent les requêtes localement à l’instance Gubernator qui regroupe ensuite les requêtes en lots et les transmet aux nœuds propriétaires.
Gubernator permet de choisir un comportement sans regroupement par lots, ce qui réduirait encore la latence des requêtes de limitation de débit des clients. Toutefois, en raison de nos exigences de débit, notre environnement de production utilise Behaviour=BATCHING avec la fenêtre par défaut de 500 microsecondes. En production, nous avons observé des lots de 1 000 requêtes lors des pics d’utilisation de l’API. Pour les personnes qui n’ont pas des exigences de trafic aussi élevées, il est possible de désactiver le traitement par lots pour obtenir des latences plus faibles, mais au détriment du débit.
Gubernator en tant que bibliothèque
Si vous utilisez Golang, vous pouvez utiliser Gubernator en tant que bibliothèque. Cela s’avère utile si vous souhaitez implémenter un service de limitation de débit avec un modèle propre à votre entreprise. C’est ce que nous faisons en interne chez Mailgun avec un service que nous avons baptisé, avec beaucoup d’imagination, ratelimits, et qui assure le suivi des limites imposées par compte. Ainsi, vous pouvez exploiter la puissance et la rapidité de Gubernator, tout en superposant une logique métier et en intégrant des problèmes spécifiques à un domaine dans votre service de limitation de débit.
Lorsque vous utilisez la bibliothèque, votre service devient un membre à part entière du cluster participant au même hachage et à la même mise en cache cohérents qu’un serveur Gubernator autonome. Il vous suffit de fournir l’instance de serveur GRPC et d’indiquer à Gubernator l’emplacement des pairs dans votre cluster.
Conclusion
L’utilisation de Gubernator en tant que service universel de limitation de débit nous permet de nous appuyer sur une architecture de microservices sans compromettre l’indépendance des services, et d’éviter la duplication du travail requise par les solutions courantes de limitation de débit. En proposant ce projet en open source, nous espérons que d’autres personnes pourront collaborer et tirer parti du travail que nous avons initié ici.
Envie de travailler chez Mailgun ? Nous recrutons ! Et plusieurs postes de développement sont à pourvoir. Découvrez nos offres d’emploi actuelles ici.



Comment fonctionne Gubernator