IT & Engineering
Traitement des données : comprendre les méthodes

Nous vivons dans un monde où les données règnent en maître, mais si vous savez exploiter leur potentiel, elles peuvent tout booster, de votre SEO à votre évolutivité. Comprendre les méthodes de traitement des données n’est pas une mince affaire, mais nous avons le guide – et vous l’aurez deviné, les données – pour tout décortiquer octet par octet. Jeu de mots assumé.
Que sont les données ?
Outre le fait d’être un sujet de conversation…
Les données sont des informations (graphiques, faits et statistiques) générées par les actions et les transactions que nous effectuons en ligne. Essayez d’entrer dans un bureau, de rejoindre un appel Zoom ou même d’aller dans votre bar préféré sans que les données ne s’invitent dans la conversation. Vous entendrez peut-être « Je vous jure que mon smartphone m’écoute » ou « Avez-vous entendu parler de la nouvelle législation sur la conformité ? »
Pas de panique. Cet article ne traite pas des téléphones doués de conscience ni des droits relatifs aux données (mais si le sujet vous intéresse, consultez nos articles sur le RGPD et CCPA). Ce blog explique comment gérer et traiter les données qui font tourner votre entreprise.
Qu’est-ce que le traitement des données ?
Le traitement des données transforme les informations recueillies auprès de diverses sources en données exploitables. Lorsque nous parlons de traitement des données, nous faisons principalement référence au traitement électronique qui utilise l’apprentissage automatique, des algorithmes et des modèles statistiques pour transformer des données brutes en un format lisible par des machines, afin qu’elles puissent être facilement traitées et manipulées pour les prévisions et les rapports par des humains.
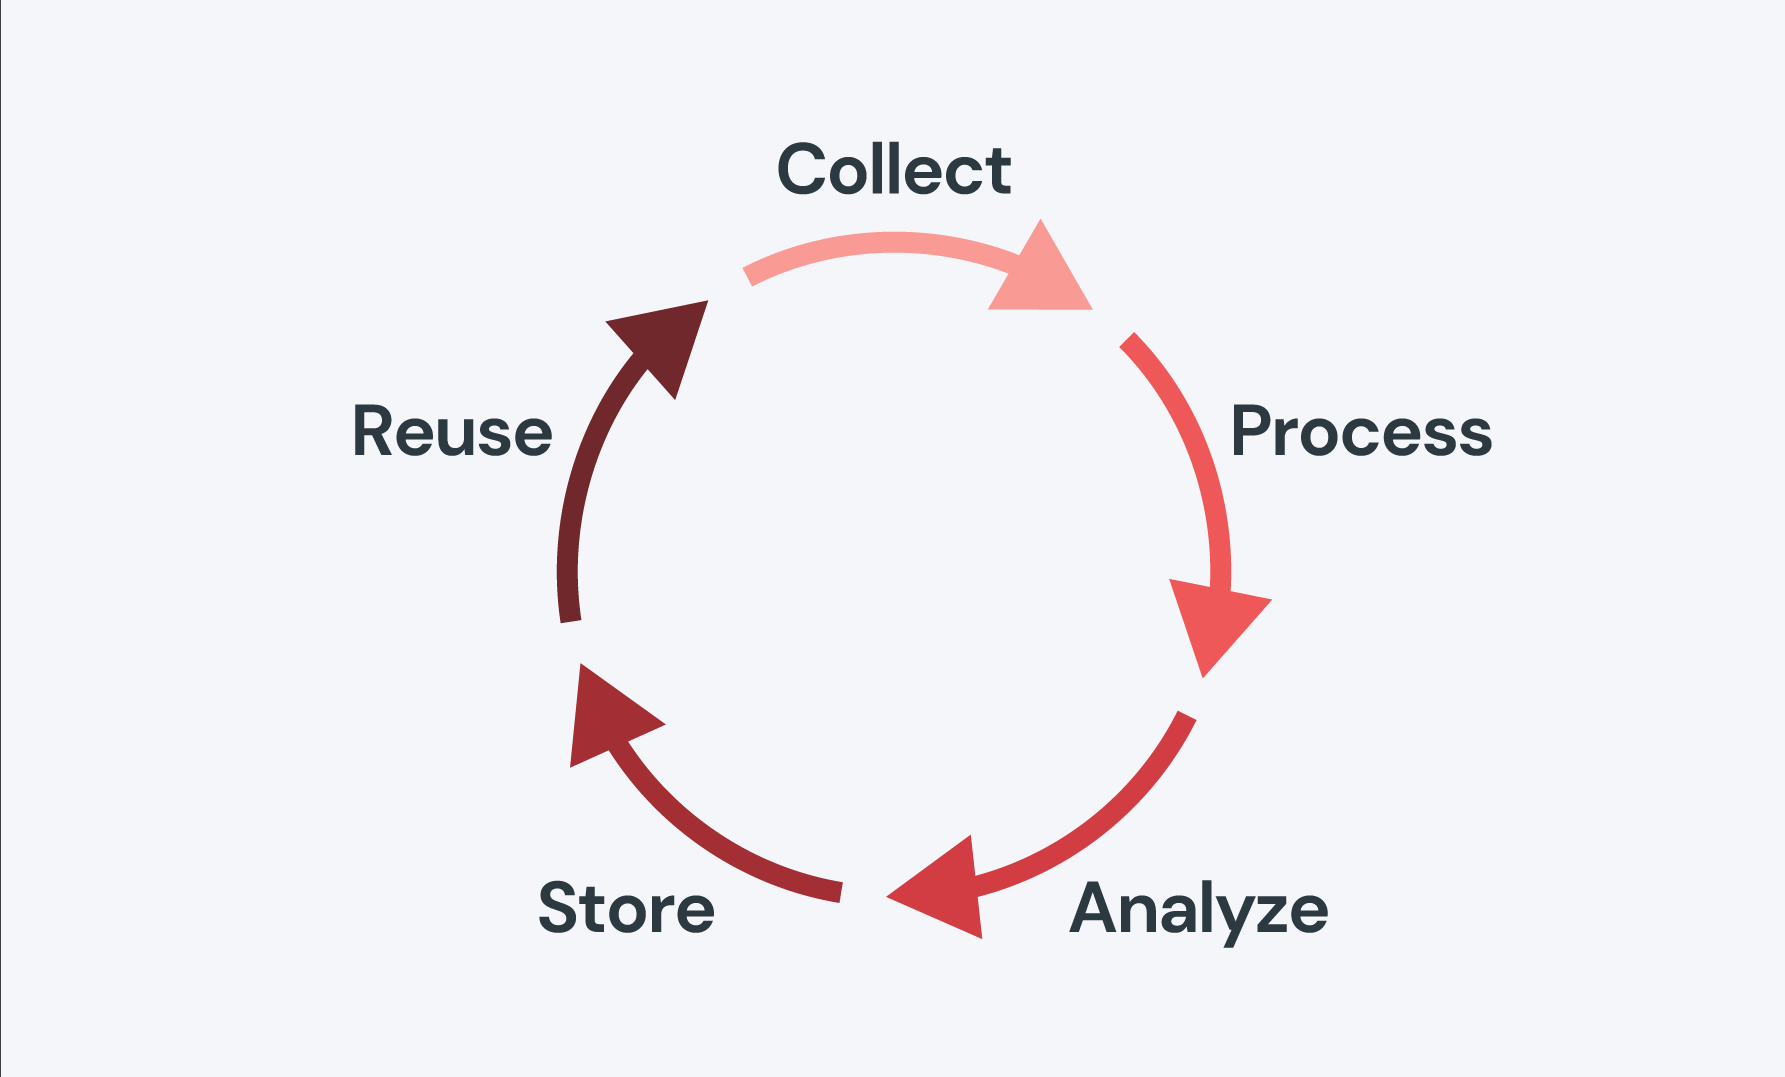
Vous vous souvenez de l’école primaire, quand vous avez appris la règle des trois R : réduire, réutiliser, recycler ? Eh bien, le traitement des données, c’est comme le recyclage. Les données sont collectées et « réduites » (ou décomposées) et traitées pour être interprétées par la machine. Ensuite, elles sont « réutilisées », c’est-à-dire analysées et stockées pour être interprétées et appliquées par l’être humain. Enfin, elles sont « recyclées », ou stockées dans une base de données active afin de pouvoir être utilisées pour élaborer des projections et des applications plus précises.
Pour bien comprendre la logistique du traitement des données, il faut le considérer presque comme une ressource naturelle plutôt que comme de simples informations collectées.
Types de traitement des données
Les données peuvent être traitées de diverses manières à l’aide de différents algorithmes. En fait, vous n’êtes vraiment limité que par la capacité de votre infrastructure. Jetons un coup d’œil aux trois principales méthodes de traitement des données.
Traitement par lots
Dans le traitement par lots, vos données sont collectées et traitées par lots. C’est l’analogie des cookies : vous pouvez préparer une énorme pâte à cookies, mais vous ne pouvez les cuire que par lots, selon la taille de votre four.
Vous avez plusieurs fours ? Super, cela signifie que vous pouvez traiter plus de lots, plus rapidement. Le traitement par lots est idéal pour les très grandes quantités de données.
Traitement en ligne
Avec le traitement en ligne, vos données alimentent directement votre processeur, ce qui en fait la méthode de traitement privilégiée pour les données qui doivent être disponibles immédiatement, comme lorsque vous passez à la caisse de l’épicerie et que l’employé·e de caisse scanne les codes-barres pour retrouver vos articles dans son système.
Traitement des données en temps partagé et en temps réel
Pour comprendre simplement la méthode du temps partagé, pensez à une location de vacances en multipropriété où la ressource (le logement) est répartie entre plusieurs familles. Cette méthode, également appelée traitement parallèle, consiste à décomposer les données en petites quantités et à les traiter entre plusieurs processeurs, soit en parallèle, soit consécutivement.
Le traitement en temps réel est similaire au temps partagé dans la façon dont les données sont traitées. La principale différence réside dans la façon dont le temps est interprété. Le traitement en temps réel fournit des données avec des temps de latence très courts (généralement de l’ordre de la milliseconde) à une seule application, tandis que le temps partagé traite plusieurs applications.
Qu’est-ce que la collecte de données ?
La collecte de données est la saisie de données effectuée par vos utilisateurs. Avant de pouvoir commencer le traitement, vous devez mettre la main sur suffisamment de données pour avoir un impact.
Il existe de nombreuses façons de collecter des données et vous pouvez (et devriez) utiliser plusieurs points de collecte. Les données proviennent de transactions, d’interactions, d’observations et d’activités de surveillance sur Internet. Voici quelques méthodes courantes :
| Méthode | Description |
|---|---|
| Suivi transactionnel | Données capturées après un événement tel qu’un achat en ligne, la soumission d’un formulaire ou une demande de réinitialisation de mot de passe. |
| Suivi en ligne | Analyse du comportement des utilisateurs en ligne (suivi du navigateur, suivi web, cookies). |
| Sondages et entretiens | Données collectées par la participation active et intentionnelle des utilisateurs. |
| Observation | La façon dont les visiteurs interagissent avec votre produit ou site. |
Collecte de données : conformité et stratégie
En général, la conformité des données est une question très politique lorsqu’il s’agit de protéger le grand public contre l’exploration de données (data mining) et autres violations de la confidentialité. En matière de collecte de données, le moment de la collecte est important. Par exemple, nous vous recommandons de toujours développer vos listes de contacts de manière organique plutôt que de les acheter. Non seulement pour la qualité des adresses, mais aussi pour votre réputation d’expéditeur.
Le point de collecte peut également être soumis à de nombreuses législations de conformité concernant les clauses de non-responsabilité et les politiques de données que vous devez fournir aux utilisateurs potentiels dès le début de leur parcours.
En ce qui concerne les stratégies de collecte de données, vous devez l’aborder dans l’optique de capturer les données les plus utiles et les plus actives possibles. Qu’entendons-nous par là ? Le point de collecte est l’endroit où vous pouvez impliquer les utilisateurs et ajouter un Captcha, exiger des emails de confirmation, des codes de vérification par SMS, etc., afin d’éviter d’accumuler une grande quantité de données de bots qui ne vous serviront à rien.
Types de données
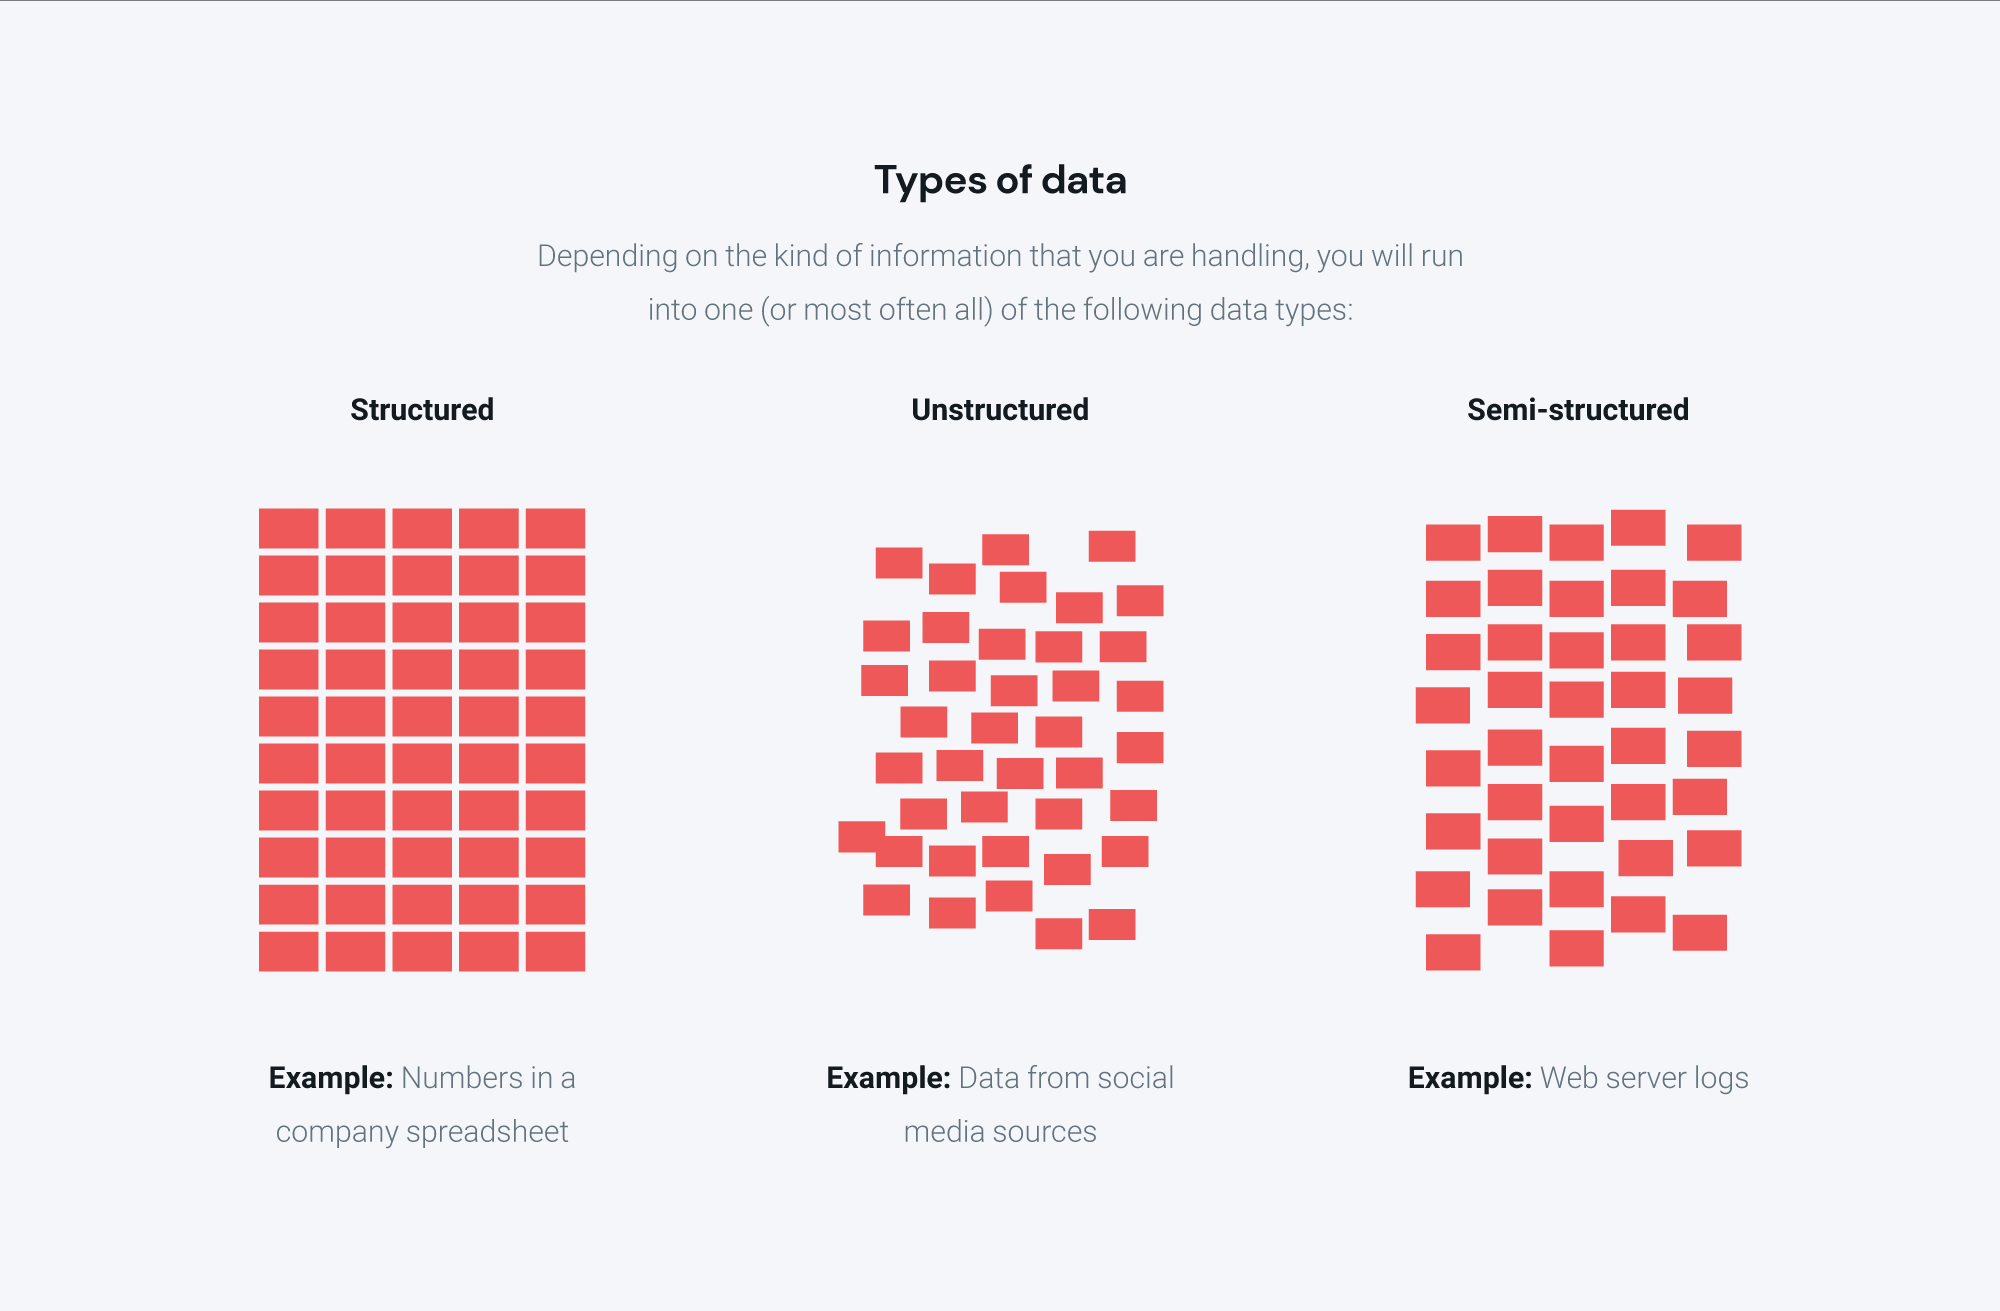
Les données que vous collectez ne se limiteront pas à des noms et des emails. Nous pouvons classer les données en trois catégories générales : structurées, semi-structurées et non structurées.
Données structurées
Les données structurées sont formatées pour être facilement comprises par le langage machine. Il s’agit d’un référentiel hautement formaté et organisé ou d’une base de données dédiée comme MySQL ou équivalent.
- Les données structurées sont incroyablement spécifiques.
- Les formats des données structurées sont prédéfinis à l’aide d’un schéma à l’écriture (schema-on-write).
- Les champs peuvent prendre en charge divers types d’informations, d’un nom à des données de géolocalisation.
Données semi-structurées
Les données semi-structurées sont organisées, mais pas dans une base de données relationnelle (une ou plusieurs tables/lignes liées entre elles).
Les données semi-structurées comportent des balises et sont catégorisées ou organisées, mais elles ne sont pas classées dans une base de données particulière. En d’autres termes, les données semi-structurées ne se conforment à aucun schéma ou format de données unique. Les données semi-structurées peuvent être intégrées à partir de nombreuses sources, allant des fichiers compressés aux paquets TCP ou au format XML.
Données non structurées
Les données non structurées n’ont pas d’organisation ni de modèle de données et peuvent se présenter sous divers formats tels que des images, du texte ou des médias.
Les données non structurées n’ont pas de format prédéterminé. Disons que les données structurées ressemblent à un rouleau de pièces de 1 centime : seules ces pièces peuvent être collectées, car elles seules correspondent au format. Les données non structurées, ce sont les petites pièces de monnaie qui traînent dans votre voiture. Cela va des sondages sur les réseaux sociaux aux fichiers texte, en passant par les fichiers audio, vidéo ou image.
Là où les données structurées utilisent un schéma à l’écriture, les données non structurées utilisent un schéma à la lecture (schema-on-read), ce qui signifie que le formatage des données s’effectue lors de l’analyse d’un ensemble de données individuel, car la collecte des données prime sur leur organisation. Pour en revenir à notre exemple sur la monnaie, toutes les pièces peuvent être quantifiées, mais vous devez d’abord déterminer si vous allez les trier par couleur, par valeur, par taille, etc.
Qu’est-ce que l’analyse de données ?
Prendre une décision avec quelques données vaut mieux que de prendre une décision sans aucune donnée. La première étape de l’utilisation de vos données est la préparation des données. Pour pouvoir utiliser les données que vous avez collectées, elles doivent être lisibles par une machine, puis analysées.
Nous avons déjà parlé des différents types de structure de données, mais que vont révéler les différents aspects des données ?
Les six « V » de l’analyse des données
Les statistiques de données consistent à prendre des données massives (big data) et à les décomposer dans un format lisible afin que vous puissiez appliquer leurs avantages à vos projets d’entreprise et à vos prévisions. Il existe de nombreuses façons d’interpréter les données. Il est donc utile de diviser votre analyse en ces six segments.
| Type | Description |
|---|---|
| VOLUME : Le volume concerne l’évolutivité. | Le volume vous oblige à répondre à une question importante : quelle quantité de données êtes-vous capable de traiter ? Collecter des données est une chose, mais lorsque nous parlons de volume, nous parlons en réalité de la puissance de traitement de votre infrastructure. Quelle quantité de données pouvez-vous stocker et quelle quantité pouvez-vous manipuler à un instant T ? |
| VÉLOCITÉ : La vélocité (ou vitesse) consiste à définir les conditions de traitement de vos données en quelques instants pour obtenir les résultats dont vous avez besoin. | La vélocité implique la rapidité avec laquelle vos données sont reçues, par exemple en temps réel ou par lots. Les données sont en constante évolution, et il devient important de pouvoir traiter rapidement différents types de données (structurées/non structurées) afin de saisir les opportunités de géolocalisation et de tirer parti des tendances en temps réel. |
| VARIÉTÉ : La variété fait référence à la manière dont la collecte de vos données influence la façon dont elles peuvent être analysées. | La variété correspond à la diversité de vos données : leur provenance, leur valeur, si elles ont été obtenues auprès d’utilisateurs individuels ou d’une source d’entreprise plus vaste, etc. En termes d’analyse, la variété concerne la façon dont les différentes données sont standardisées et distribuées une fois collectées. |
| VÉRACITÉ : La véracité concerne la qualité de l’origine de vos données. | Dans quelle mesure vos données sont-elles exactes ? Ou, plus important encore, quelle est la qualité de l’origine de vos données ? La véracité fait appel à votre processus de collecte de données et aux facteurs que vous avez mis en place pour garantir qu’il s’agit de données utilisateurs de haute qualité et non de données de bots ou d’emails jetables, etc. |
| VALEUR : La valeur concerne l’utilisabilité. Quelles sont les applications possibles pour vos données ? | La détermination de la valeur des données est subjective. Une méthode consiste à lier la contribution des données à leur impact sur vos résultats nets. Une autre méthode consiste à l’évaluer en fonction de son utilisabilité : vos données ont-elles des applications pratiques dans le cadre de diverses initiatives ou constituent-elles une ressource précieuse ? |
| VARIABILITÉ : La variabilité consiste à établir une base de référence pour comparer un ensemble de données à un autre à des fins d’analyse. | Quelle est l’étendue de vos données ? La variabilité correspond à la dispersion de vos points de données collectés. La variance d’un ensemble de données détermine l’étendue des données collectées (du plus petit au plus grand point), ainsi que l’écart, c’est-à-dire la façon dont vos points de données sont regroupés autour de la moyenne. |
Stockage des données
Stocker des données ne signifie pas simplement les collecter et les jeter dans une boîte, au fond d’un sous-sol numérique, pour une utilisation ultérieure. Les données stockées sont des données enregistrées, traitées pour que vous puissiez les conserver sur un ordinateur ou un autre appareil. Stocker des données signifie également que vous les capturez afin de les rendre accessibles. À quoi bon collecter des données si vous ne pouvez pas les appliquer ?
Centres de données et cloud
Vous avez le choix quant à l’endroit où vous stockez vos données. Cloud ou sur site est un débat en soi, que vous vous intéressiez à la sécurité ou au stockage des données. En matière de traitement des données, vous pouvez soit héberger votre propre stockage de données, soit les stocker sur des solutions cloud hébergées qui utilisent des entrepôts de données externes plus vastes.
Les données sont vivantes. Bon, pas vraiment vivantes, mais les données se multiplient à mesure qu’elles sont collectées. Et plus vous avez de données, plus vos applications peuvent être performantes. Par conséquent, lorsque vous réfléchissez au stockage, il est judicieux de garder à l’esprit l’évolutivité, ce qui a tendance à être plus simple et plus rentable avec des solutions basées sur le cloud.
Stockage des données et conformité
Le plus grand obstacle à l’évolution du traitement des données est sans doute le stockage sécurisé et l’utilisation responsable. La législation sur la conformité des données évolue rapidement. L’une des façons de respecter ces politiques est d’opter pour des solutions d’infrastructure cloud conçues pour s’adapter à l’évolution des lois. Dans le cas contraire, vous serez tenu de dépenser de l’argent pour mettre à jour votre propre infrastructure.
Bien que les États-Unis n’aient pas encore de politiques fédérales sur les données, des États comme la Californie commencent à en mettre en œuvre avec des législations telles que le CCPA. Et soyons honnêtes, de nombreuses entreprises opèrent à l’échelle mondiale et doivent tenir compte de législations européennes telles que le RGPD dans leurs politiques.
Application de vos données
Le traitement des données est le manuel de référence pour rendre vos données utilisables. Une fois que vos données ont été évaluées et analysées par des machines, vous pouvez appliquer les résultats obtenus à vos projets d’entreprise. Utilisez les données pour anticiper les tendances du marché, les comportements des utilisateurs et les améliorations des performances stratégiques.
Dans notre monde, celui de l’email, les données nous aident à proposer des fonctionnalités telles que Validation des emails qui vous aident à valider vos adresses email par rapport à notre base de données pour détecter les domaines de spam, les fautes de frappe et autres incohérences avec une précision incroyable.
Comme nous l’avons dit, les données constituent une ressource naturelle, et elles peuvent sembler illimitées. Les données ne s’épuiseront probablement pas. Tant que les gens interagiront en ligne, les données resteront un outil puissant. Cependant, sans un traitement adéquat et un stockage efficace, vos données ne serviront à rien. Si vous ne pouvez pas gérer vos données, vous ne pouvez pas les appliquer.
Base de connaissances de Mailgun
Nous ne connaissons pas de sujet plus vaste ou plus intéressant que les données. Les données façonnent tout, de votre délivrabilité des emails à vos politiques et systèmes d’information. C’est un sujet vaste dont notre équipe parle beaucoup.
Participez à notre conversation et inscrivez-vous à notre newsletter pour ne manquer aucun conseil ni aucun guide comme celui-ci.



