IT & Engineering
Gubernator: limitação de taxa distribuída nativa da nuvem para microsserviços

Hoje, a Mailgun tem o prazer de disponibilizar o código aberto do Gubernator, um microsserviço de limitação de taxa distribuída de alto desempenho. O que o Gubernator faz? Ótima pergunta:
Recursos do Gubernator
- O Gubernator distribui uniformemente as solicitações de limite de taxa por todo o cluster, o que significa que você pode escalar o sistema apenas adicionando mais nós.
- O Gubernator não depende de caches externos como Memcache ou Redis, portanto, não há sincronização de implantação com um serviço dependente. Isso torna o aumento ou a redução dinâmica do cluster em um sistema de orquestração como o Kubernetes ou o Nomad algo trivial.
- O Gubernator não mantém nenhum estado no disco. A configuração é passada para ele pelo cliente a cada solicitação.
- O Gubernator fornece acesso GRPC e HTTP à sua API.
- Pode ser executado como um sidecar para serviços que precisam de limitação de taxa ou como um serviço separado.
- Pode ser usado como uma biblioteca para implementar um serviço de limitação de taxa específico de um domínio.
- Tem suporte opcional à distribuição de limite de taxa eventualmente consistente para ambientes de vazão extremamente alta.
- Gubernator é a pronúncia em inglês da palavra governador em russo e também soa legal.
Agora, temos certeza de que você tem muitas dúvidas sobre os motivos que nos levaram a abrir o código do Gubernator. Portanto, antes de entrarmos em detalhes sobre como o Gubernator funciona, vamos responder a algumas dessas dúvidas. A maior dúvida que você deve ter é provavelmente…
Por que não usar o Redis?
Algumas coisas nos chamaram a atenção ao avaliar o Redis.
- Usar a implementação básica do limite de taxa do Redis incorreria em viagens de ida e volta adicionais na rede, mesmo com o pipelining.
- Poderíamos reduzir as viagens de ida e volta usando https://redis.io/commands/eval e escrevendo um script LUA que precisaríamos manter para cada algoritmo implementado.
- Cada solicitação resultaria em pelo menos uma viagem de ida e volta ao Redis. Combinado com pelo menos uma viagem de ida e volta ao nosso microsserviço, isso significa ao menos duas viagens de ida e volta por solicitação ao nosso serviço.
A solução ideal para o Redis é escrever um script LUA que implementa o algoritmo de limite de taxa. Esse script é armazenado no servidor do Redis e é chamado a cada solicitação de limite de taxa. Neste cenário, grande parte do trabalho é feito pelo Redis e o nosso microsserviço funciona basicamente como um proxy para acessar o Redis. Sendo esse o caso, temos duas opções:
- Criar o Gubernator como uma biblioteca de limite de taxa que fornece acesso ao Redis. Essa biblioteca seria usada por todos os serviços que precisam de limitação de taxa.
- Eliminar o Redis e implementar os algoritmos de distribuição, armazenamento em cache e limitação em um microsserviço de limitação de taxa com um cliente GRPC leve para ser usado por cada serviço.
Por que um microsserviço?
A Mailgun é uma empresa poliglota, sendo que a maior parte da nossa base de código é composta por Python e Golang. Se optarmos por implementar a limitação de taxa como uma biblioteca, isso exigirá, no mínimo, uma versão em Python e outra em Golang da biblioteca. Já adotamos essa abordagem internamente antes com uma versão em Python e em Golang da mesma biblioteca. Em nossa experiência, as bibliotecas compartilhadas entre os serviços têm as seguintes desvantagens.
- As atualizações de bugs e recursos na biblioteca podem implicar, na melhor das hipóteses, em uma atualização da dependência. Na pior das hipóteses, exige modificações em todos os serviços que usam a biblioteca em todas as linguagens compatíveis.
- É raro que a equipe de desenvolvimento queira manter ou criar novos recursos em ambas as linguagens. Isso costuma fazer com que uma versão da biblioteca tenha mais recursos ou seja mais bem mantida do que a outra.
À medida que o número de microsserviços e linguagens em nosso ecossistema continua a crescer, esses problemas se acumulam e pioram. Em comparação, as bibliotecas GRPC e HTTP são criadas e mantidas facilmente para cada linguagem que precisa de acesso ao Gubernator.
Para os microsserviços, atualizações de bugs e novos recursos podem ser adicionados sem causar interrupções aos serviços dependentes. Desde que as alterações estruturais na API não sejam permitidas, os serviços dependentes poderão aderir a novos recursos sem a necessidade de atualizar todos os serviços dependentes.
O grande diferencial do Gubernator como um microsserviço é que ele cria um ponto de sincronização para as diversas solicitações que entram no sistema. As solicitações recebidas em uma diferença de poucos microssegundos umas das outras podem ser otimizadas e coordenadas em lotes, o que reduz a largura de banda geral e a latência de ida e volta que o serviço usa em situações de carga alta. Vários serviços em execução em um único host, todos com a mesma biblioteca rodando em seus respectivos processos, não têm essa capacidade.
Por que o Gubernator é stateless?
O Gubernator é stateless, pois não exige espaço em disco para operar. Nenhum dado de configuração ou cache passa por sincronização com o disco, e isso ocorre porque cada solicitação ao Gubernator inclui a configuração do limite de taxa.
A princípio, você pode achar que essa é uma sobrecarga desnecessária a cada solicitação. No entanto, na realidade, uma configuração de limite de taxa é composta por apenas quatro números inteiros de 64 bits. A configuração é composta por Limite, Duração, Algoritmo e Comportamento (veja abaixo os detalhes de como isso funciona). É por causa dessa configuração simples que o Gubernator pode ser usado para fornecer uma grande variedade de casos de uso de limite de taxa que podem ser empregados pelos clientes. Alguns desses casos de uso são:
- Limitação de entrada – Limitação típica baseada em HTTP do tipo 402 Too Many Requests
- Descarte de tráfego – Rejeita apenas solicitações novas ou não autenticadas quando sua API estiver em um estado ruim.
- Limitação de saída – Bombardear servidores SMTP externos com milhões de mensagens não é uma boa ideia.
- Processamento de fila – Saiba quando uma solicitação pode ser tratada imediatamente ou se deve ser colocada na fila e processada na ordem em que foi recebida.
- Gerenciamento da capacidade da API – Defina limites globais para o número total de solicitações com o qual um sistema de API coletivo pode lidar. Rejeite ou coloque na fila as solicitações que violam a capacidade operacional normal do sistema.
Além dos casos de uso mencionados anteriormente, um design sem configurações tem implicações significativas para o design e a implantação de microsserviços:
- Nenhuma sincronização de configuração na implantação. Quando um serviço que usa o Gubernator é implantado, não há nenhuma configuração de limite de taxa que precise ser pré-implantada no Gubernator.
- Os serviços que usam o Gubernator controlam seu próprio modelo de domínio de limite de taxa no que diz respeito aos problemas envolvidos. Isso mantém o conhecimento específico do domínio fora do Gubernator, de modo que ele possa se concentrar no que faz de melhor: a limitação de taxa!
Fora essas dúvidas, vamos falar um pouco mais sobre o Gubernator como um todo, começando por como ele funciona.
Como o Gubernator funciona
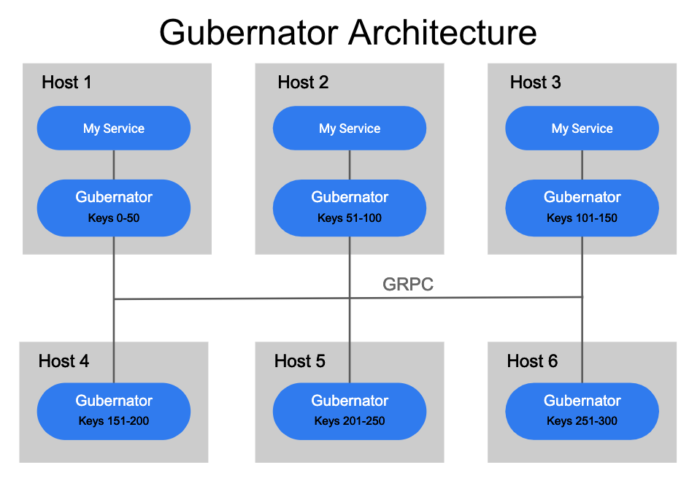
O Gubernator foi criado para operar como um cluster distribuído de nós pares que utilizam um cache na memória de todos os limites de taxa ativos no momento; assim sendo, não ocorre sincronização de dados com o disco. Como a maioria das durações de limite de taxa com base na rede é mantida por apenas alguns segundos, a perda do cache na memória durante uma reinicialização ou inatividade programada não é um grande problema. Para o Gubernator, escolhemos o desempenho em vez da precisão, pois é aceitável que um pequeno subconjunto de tráfego sofra com solicitações excessivas por um curto período (geralmente segundos) em caso de perda de cache.
Quando é feita uma solicitação de limite de taxa ao Gubernator, a solicitação recebe uma chave e um algoritmo de hash consistente é aplicado para determinar qual dos pares será o proprietário da solicitação. A escolha de um único proprietário para um limite de taxa torna os incrementos atômicos das contagens muito rápidos e evita a complexidade e a latência envolvidas na distribuição de contagens de forma consistente em um cluster de nós pares.
Apesar de simples e com bom desempenho, esse design pode ser suscetível a um volume avassalador de solicitações, já que um único coordenador é responsável por possivelmente centenas de milhares de solicitações para um limite de taxa.
Para combater isso, os clientes podem solicitar o uso de `Behaviour=BATCHING`, que permite que os pares aceitem várias solicitações dentro de um período especificado (o padrão é 500 microssegundos) e agrupem-nas em uma solicitação de nó par individual em lote, reduzindo consideravelmente o número total de solicitações pela rede para um único par do Gubernator.
Para garantir que cada nó par no cluster calcule com exatidão o hash correto de uma chave de limite de taxa, a lista de pares no cluster deve ser distribuída a cada par nele de maneira oportuna e consistente. Atualmente, o Gubernator tem suporte ao uso do etcd ou da API de endpoints do Kubernetes para descobrir pares do Gubernator.
Operação do Gubernator
Quando um cliente ou serviço faz uma solicitação ao Gubernator, a configuração de limite de taxa é fornecida em cada solicitação pelo cliente. A configuração do limite de taxa é armazenada juntamente ao seu status atual no cache local do proprietário do limite de taxa. Os limites de taxa e sua configuração que são armazenados no cache local existirão apenas durante a duração especificada na configuração do limite de taxa.
Após a expiração da duração e caso o limite de taxa não seja solicitado novamente dentro desse período, ele será descartado do cache. As solicitações seguintes para o mesmo nome e par unique_key recriarão a configuração e o limite de taxa no cache, fazendo com que o ciclo se repita. Por outro lado, as solicitações subsequentes com configurações diferentes substituirão a configuração anterior e aplicarão a nova de imediato.
Um exemplo de solicitação de limite de taxa enviada via GRPC pode se parecer com o seguinte:
rate_limits:rn # Scopes the request to a specific rate limit rn - name: requests_per_secrn # A unique_key that identifies this rate limit requestrn unique_key: account_id=123|source_ip=172.0.0.1rn # The number of hits we are requestingrn hits: 1rn # The total number of requests allowed for this rate limitrn limit: 100rn # The duration of the rate limit in millisecondsrn duration: 1000rn # The algorithm used to calculate the rate limit rn # 0 = Token Bucketrn # 1 = Leaky Bucketrn algorithm: 0rn # The behavior of the rate limit in gubernator.rn # 0 = BATCHING (Enables batching of requests to peers)rn # 1 = NO_BATCHING (Disables batching)rn # 2 = GLOBAL (Enable global caching for this rate limit)rn behavior: 0
Um exemplo de resposta seria:
rate_limits:rn # The status of the rate limit. OK = 0, OVER_LIMIT = 1rn - status: 0,rn # The current configured limitrn limit: 10,rn # The number of requests remainingrn remaining: 7,rn # A unix timestamp in milliseconds of when the rate limit will reset,rn # or if OVER_LIMIT is set it is the time at which the rate limitrn # will no longer return OVER_LIMIT.rn reset_time: 1551309219226,rn # Additional metadata about the request the client might find usefulrn metadata:rn # This is the name of the node that owns this requestrn "owner": "api-n03.staging.us-east-1.mailgun.org:9041"
Comportamento global
Como os limites de taxa do Gubernator passam por processos de hash e são gerenciados por um único nó par no cluster, os limites de taxa aplicáveis a cada solicitação em um data center resultariam na gerência da solicitação de limite de taxa por um único par para todo o data center.
Por exemplo, considere um limite de taxa com name=requests_per_datacenter e um unique_id=us-east-1. Agora imagine que seja feita uma solicitação ao Gubernator com esse limite para cada solicitação HTTP que entra no data center us-east-1. Podem ser centenas de milhares, ou até mesmo milhões, de solicitações por segundo, e todas elas passam por processos de hash e são tratadas por um único par no cluster. Devido a esse possível problema de escala, o Gubernator introduz um behavior configurável chamado GLOBAL.
Quando um limite de taxa é configurado com behavior=GLOBAL, a solicitação de limite de taxa recebida de um cliente não será encaminhada ao nó par proprietário. Em vez disso, ela será respondida de um cache interno gerenciado pelo par que recebeu a solicitação. As Hits direcionadas ao limite de taxa serão colocadas em lote pelo nó par de recebimento e enviadas de forma assíncrona para o nó par proprietário, onde os acessos serão totalizados e o OVER_LIMIT será calculado. Cabe então ao par proprietário a responsabilidade de atualizar cada nó par no cluster com o status atual do limite de taxa, de modo que os caches internos do par sejam rotineiramente atualizados com o status de limite de taxa mais recente originário do proprietário.
Efeitos colaterais do comportamento global
Como as Hits são agrupadas em lotes e encaminhadas ao par proprietário de forma assíncrona, a resposta imediata ao cliente não incluirá as contagens de itens remaining mais precisas. Essa contagem só será atualizada após a conclusão da chamada assíncrona ao par proprietário e após esse mesmo par ter tido tempo de atualizar todos os pares no cluster. Como resultado, o uso de GLOBAL permite uma escala maior, mas ao custo da consistência. O uso de GLOBAL pode aumentar a quantidade de tráfego por solicitação de limite de taxa se o cluster for grande o suficiente. O GLOBAL deve ser usado apenas para limites de taxa de volume extremamente alto que não escalam bem com o comportamento não GLOBAL tradicional.
Desempenho do Gubernator
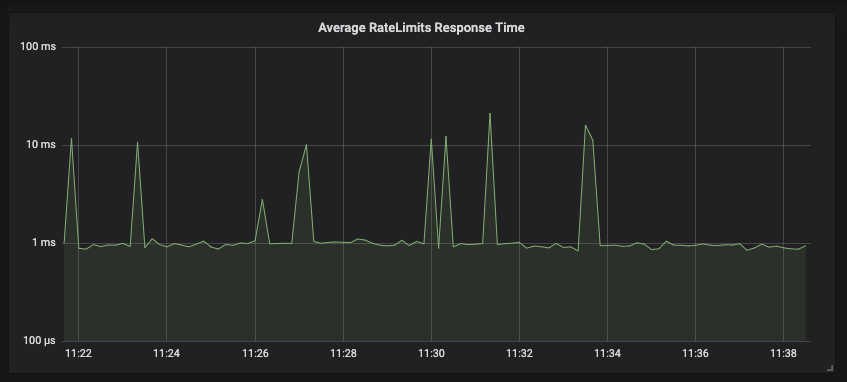
Em nosso ambiente de produção, para cada solicitação à nossa API, enviamos 2 solicitações de limite de taxa ao Gubernator para avaliação desse limite; uma para avaliar a solicitação HTTP e a outra para determinar a taxa do número de destinatários aos quais um usuário pode enviar um e-mail dentro da duração específica. Nessa configuração, um único nó do Gubernator lida com mais de 2.000 solicitações por segundo, e a maioria das respostas em lote retorna em menos de 1 milissegundo.
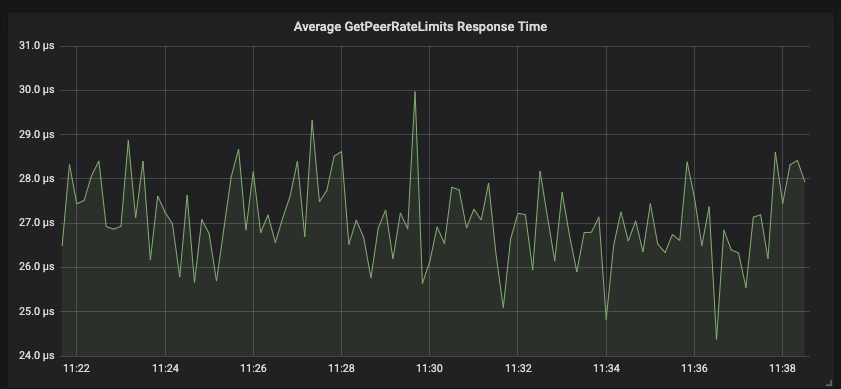
As solicitações de pares encaminhadas para nós proprietários costumam responder em menos de 30 microssegundos.
Como muitas das nossas APIs voltadas para o público são escritas em Python, executamos várias instâncias do interpretador de Python em um único nó. Essas instâncias em Python encaminharão as solicitações localmente para a instância do Gubernator que, em seguida, as agrupará em lote e encaminhará essas solicitações aos nós proprietários.
O Gubernator permite que os usuários optem por um comportamento sem lote, o que reduziria ainda mais a latência nas solicitações de limite de taxa do cliente. No entanto, devido aos requisitos de vazão, nosso ambiente de produção usa o Behaviour=BATCHING com o período padrão de 500 microssegundos. Em produção, observamos tamanhos de lote de 1.000 durante o pico de uso da API. Outros usuários que não têm as mesmas altas demandas de tráfego poderiam desativar os lotes para obter latências mais baixas, mas ao custo da vazão.
Gubernator como uma biblioteca
Se estiver usando Golang, você pode usar o Gubernator como uma biblioteca. Isso é útil se você desejar implementar um serviço de limite de taxa com o seu próprio modelo específico da empresa sobre ele. Fazemos isso internamente na Mailgun com um serviço que batizamos criativamente de ratelimits, que rastreia os limites impostos em cada conta. Desta forma, você pode utilizar a potência e a velocidade do Gubernator, mas ainda criar níveis de lógica de negócios e integrar problemas específicos de um domínio em seu serviço de limite de taxa.
Ao usar a biblioteca, o seu serviço se torna um membro integral do cluster que participa do mesmo cache e hash consistentes que um servidor autônomo do Gubernator faria. Tudo o que você precisa fazer é fornecer a instância do servidor GRPC e informar ao Gubernator onde estão localizados os nós pares no seu cluster.
Conclusão
O uso do Gubernator como um serviço de limite de taxa de propósito geral nos permite usar uma arquitetura de microsserviço sem comprometer a independência dos serviços ou a duplicação do trabalho exigida pelas soluções comuns de limitação de taxa. Esperamos que, com a abertura do código deste projeto, outras pessoas possam colaborar e se beneficiar do trabalho que iniciamos aqui.
Tem interesse em trabalhar no Mailgun? Estamos contratando! E há várias vagas disponíveis para a equipe de desenvolvimento. Confira nossas vagas atuais aqui.


