Product
Lançamento em código aberto da nossa biblioteca de análise de assinaturas de e-mail

Lá em 2011, vários clientes nos pediram uma API de análise de mensagens de alto nível que pudesse ser usada para remover assinaturas e citações de um e-mail, como você vê abaixo:
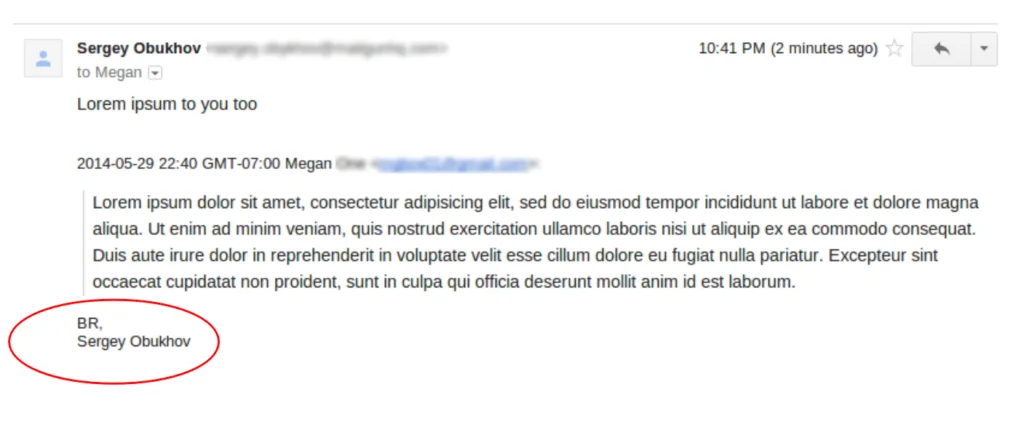
O problema
Embora seja simples para pessoas, essa é uma tarefa bastante desafiadora para máquinas. Um dos principais motivos é que não há um formato padrão para uma mensagem de e-mail. Diferentes clientes de e-mail redigem respostas de maneiras diferentes e, mesmo no mesmo cliente de e-mail, o remetente pode alterar o formato para o que preferir. Por exemplo, os usuários podem colocar a resposta após citar a mensagem original (postagem inferior):
Às 10:01 de quarta-feira, Danny escreveu:
> A propósito, quais sistemas serão atualizados? Tive alguns problemas de rede
> após a atualização da semana passada.  Terei que reiniciar?
Não, você não precisará reiniciar.
antes da mensagem original citada (postagem superior):
Não, você não precisará reiniciar.

-------- Mensagem Original --------

De: Danny

Enviado: Terça-feira, 16 de outubro de 2007, às 10:01

Para: Jim

Assunto: RE: Job

A propósito, quais sistemas serão atualizados? Tive alguns problemas de rede

após a atualização da semana passada.  Terei que reiniciar?
ou até mesmo intercalar a resposta:
> Você pode apresentar seu relatório uma hora mais tarde?
Sim, eu posso. O resumo será enviado até as 17:00.
Jim
Às 10:01 de quarta-feira, Danny escreveu:
>> 14:00: Apresentar relatório
> Jim, tenho uma reunião nesse horário. Você pode apresentar seu relatório uma hora mais tarde?
De fato, existem tantas maneiras diferentes de responder, que há até um artigo na Wikipédia sobre isso! Tudo isso torna a análise do corpo de um e-mail uma tarefa desafiadora.
Mesmo com o aprendizado de máquina, tivemos que ajustar as coisas constantemente. A formatação de e-mail muda a todo momento, clientes de e-mail para celular estão introduzindo novas assinaturas como “Enviado do seu telefone XXX”, novos casos extremos são descobertos, etc.
Aqui está um exemplo simples. Antigamente, todas as assinaturas de e-mail eram separadas por traços:
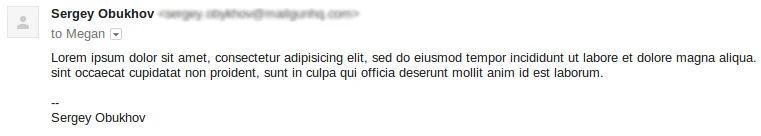
Então, a primeira coisa que vem à mente é escrever um regex para detectar traços como separadores e extrair as linhas seguintes como uma assinatura:
>>> signature = regex.match("^[s]*--*[s]*[a-z .]*$).*", message)
Mas de repente você recebe um e-mail como este:
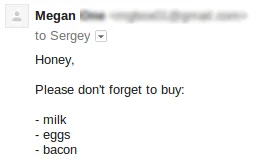
E o seu parser remove a parte mais importante do e-mail. É um exemplo muito simples e você poderia contorná-lo facilmente. Mas, na vida real, as coisas ficam muito mais complicadas e difíceis.
Nossa solução
Fizemos muitas pesquisas, analisamos todas as variações de e-mail que passam pelo Mailgun e chegamos a uma solução baseada em algumas técnicas de aprendizado de máquina. A solução já está em produção há vários anos, passando por correções de bugs e melhorias. No geral, recebemos um feedback positivo dos clientes, embora, naturalmente, a equipe de desenvolvimento tenda a apontar onde se pode melhorar.
Então, agora todo mundo tem a chance de ajudar a melhorar a solução. Devido ao cenário de e-mail distribuído e em constante mudança, decidimos lidar com esse problema com uma solução distribuída: estamos lançando nossa biblioteca em código aberto para que possamos trabalhar nisso em conjunto!
Estamos chamando nossa nova biblioteca de talon em homenagem a um robô multifuncional projetado para realizar missões que vão desde o reconhecimento ao combate, operando em vários ambientes hostis.
Caso você queira começar a testar agora mesmo, preparamos um Aplicativo de demonstração simples e um Guia de início rápido para você. Caso contrário, continue lendo para ter uma visão mais geral, conhecer as abordagens que adotamos e ver os resultados das avaliações.
Veja como são os fluxos de trabalho mais comuns:
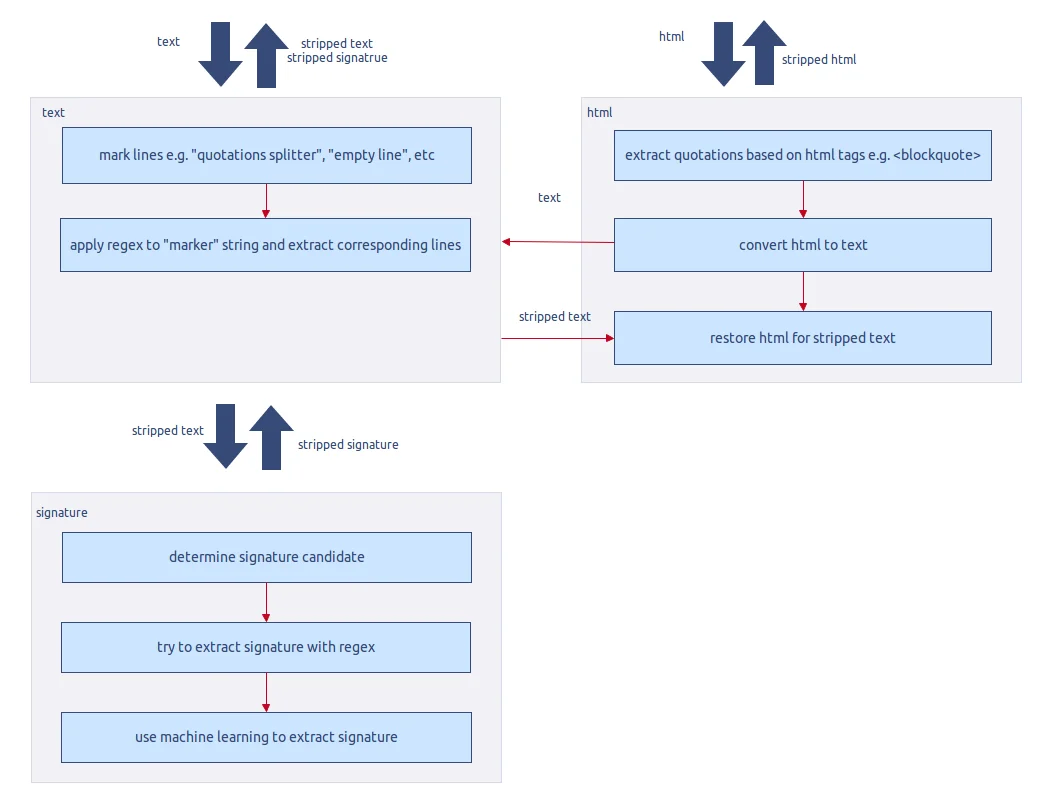
Atualmente, usamos o aprendizado de máquina apenas para classificar as linhas de assinatura. O resto da biblioteca é composto por várias heurísticas e verificações de integridade que criamos ao trabalhar em tickets de suporte e ao analisar padrões e tendências na formatação de mensagens.
A parte de aprendizado de máquina da biblioteca foi inspirada nos seguintes artigos de pesquisa:
- http://www.cs.cmu.edu/~vitor/papers/sigFilePaper_finalversion.pdf
- http://www.cs.cornell.edu/people/tj/publications/joachims_01a.pdf
Para classificar as linhas de assinatura, usamos o SVM com Kernel Linear. Para avaliar nossos classificadores, usamos a validação cruzada com 5 folds:
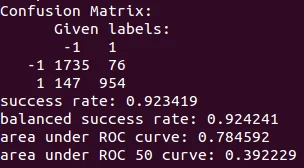
O conjunto de dados era composto por 2.912 linhas de e-mail. De 1.030 linhas de assinatura, 954 foram classificadas corretamente. De 1.882 linhas que não eram assinaturas, 147 foram confundidas com assinaturas. No geral, isso nos dá uma taxa de sucesso de 92% e uma área sob a curva ROC de 78%. O que poderia ser considerado excelente e justo, respectivamente.
Ao modificarmos a biblioteca para código aberto, tentamos fornecer uma estrutura robusta e, ao mesmo tempo, facilitar a adição de novas funcionalidades. Pela nossa experiência, as partes que poderiam exigir mais foco são as expressões regulares para separadores de citações e assinaturas, e a extração de citações HTML através das tags HTML. No entanto, sinta-se à vontade para contribuir com qualquer parte da biblioteca que desejar.
Esperamos que você ache a biblioteca útil e que ela facilite a sua vida.
Bons envios!